Data Formats vs Table Formats: fundamenty nowoczesnego data lakehouse
Temat: Open Source AI
Format pliku decyduje o tym, ile zapłacicie za przeczytanie danych; format tabeli decyduje o tym, czy w ogóle da się im zaufać. Parquet i Avro układają bajty pojedynczego pliku. Delta Lake, Apache Iceberg, Apache Hudi i Apache Paimon mówią, które z tysięcy takich plików składają się dziś na tabelę „zamówienia”, kto ją ostatnio zmienił i jak wyglądała w zeszły wtorek. Jedno bez drugiego nie buduje hurtowni — i to jest cała teza tego poradnika.
To przewodnik dla dwóch czytelników naraz. Dyrektorowi finansowemu albo operacyjnemu ma pomóc zrozumieć, o czym rozmawia zespół danych, kiedy spiera się o „Iceberg czy Delta”, i dlaczego ta decyzja wraca na fakturze za chmurę. Architektowi i inżynierowi ma dać uporządkowany model pojęć, zanim wejdzie w dokumentację konkretnego projektu. Jeśli pojęcie lakehouse jest dla Was nowe, zacznijcie od poradnika o lakehouse dla firm — ten tekst schodzi piętro niżej, do formatów, na których lakehouse stoi.
Dlaczego jezioro danych zamieniało się w bagno
— Raport sprzedaży za wrzesień pokazuje inną sumę niż ten sam raport z zeszłego tygodnia. — Bo w nocy doładowaliśmy korekty. — A która wersja jest prawdziwa? — Obie. Zależy, o której godzinie zapytasz. (Proces ładowania przerwał się o 3:14. Połowa plików jest z nowej wersji, połowa ze starej. Nikt o tym nie wie.)
Pierwsza generacja jezior danych (data lake) obiecywała prostą rzecz: wrzucamy wszystko do taniego magazynu obiektowego — Amazon S3, Azure Data Lake Storage, MinIO we własnej serwerowni — a przeczytamy, kiedy będzie trzeba. Magazyn obiektowy jest pojemny i tani, ale ma jedną właściwość, którą trudno obejść: zna tylko pliki. Nie zna tabel, transakcji ani schematu. Katalog sprzedaz/rok=2026/miesiac=09/ to dla niego lista obiektów, nie tabela.
Z tej właściwości wynikały trzy codzienne problemy:
- Brak transakcji. Zadanie, które zapisuje 400 plików i pada po 220, zostawia tabelę w stanie, którego nikt nie zamawiał. Czytelnik widzi pół nowej wersji i pół starej. To właśnie problem „uszkodzonego pliku” — tylko że uszkodzona jest cała tabela, a każdy plik z osobna wygląda poprawnie.
- Brak izolacji. Gdy jeden proces nadpisuje partycję, a drugi ją w tym czasie czyta, drugi dostaje błąd „plik nie istnieje” albo, gorzej, wynik bez błędu i bez części danych.
- Drogi odczyt metadanych. Żeby odpowiedzieć na pytanie „ile sprzedaliśmy w trzecim kwartale”, silnik musiał najpierw wylistować dziesiątki tysięcy obiektów, a dopiero potem zacząć czytać. Listowanie w magazynie obiektowym jest wolne i płatne.
Hurtownia danych (data warehouse) nie miała tych problemów, bo trzymała dane we własnym, zamkniętym formacie i sama pilnowała transakcji. Płaciło się za to brakiem wyboru silnika i ceną za każdy terabajt. Lakehouse jest próbą pogodzenia obu światów, a jego warunkiem technicznym są dwa oddzielne, uzupełniające się rodzaje formatów. Przejdźmy przez nie po kolei.
Format pliku: cegła, z której buduje się dane
Format pliku (data format, file format) odpowiada na pytanie: jak jeden plik układa rekordy w bajtach, żeby program mógł je zapisać i odczytać. W tej roli odpowiada za trzy rzeczy:
- Serializację — zamianę struktury w pamięci (rekord z polami
klient,kwota,data) na ciąg bajtów i z powrotem, razem z typami danych. - Układ bajtów — czy rekordy leżą jeden za drugim (układ wierszowy), czy wszystkie wartości jednej kolumny leżą obok siebie (układ kolumnowy).
- Kompresję i kodowanie — jak zmniejszyć plik: słownikiem powtarzających się wartości, kodowaniem ciągów (RLE), a na końcu ogólnym kompresorem jak Snappy, ZSTD czy GZIP.
Format pliku nic nie wie o innych plikach. Nie wie, czy jest częścią tabeli, czy jest aktualny, czy ktoś go właśnie zastępuje. To cegła: ma wymiary, wytrzymałość i cenę, ale sama nie wie, w której ścianie stoi.
W lakehouse liczą się dwa formaty plików, bo odpowiadają na dwa różne pytania.
Apache Parquet: kolumnowo, pod analitykę
Apache Parquet układa dane kolumnowo. Plik dzieli się na grupy wierszy (row groups), każda grupa na kawałki kolumn (column chunks), a te na strony (pages). Dla zapytania „suma kwot za wrzesień” silnik czyta tylko kolumnę kwota i data, pomijając trzydzieści pozostałych. Do tego każda grupa wierszy niesie statystyki (minimum, maksimum, liczba wartości pustych), więc silnik może ominąć całe fragmenty pliku, w których szukanej wartości być nie może. Dodatkowo filtry Blooma i indeks stron pozwalają przeskakiwać jeszcze drobniej. Z kodeków kompresji w praktyce liczą się Snappy, ZSTD i GZIP; specyfikacja formatu rozwija się dalej — wersja 2.11 dodała typ VARIANT dla danych półstrukturalnych oraz typy GEOMETRY i GEOGRAPHY, a 2.14 z września 2026 typ FILE (stan według bloga projektu, sprawdzono 21.10.2026).
Dlaczego to ważne dla kosztów: w chmurze płacicie za przeczytane bajty i za czas pracy silnika. Kolumnowy układ plus kompresja słownikowa oznaczają, że ten sam raport dotyka ułamka danych w porównaniu z plikiem CSV. Parquet jest też formatem, który czytają wszyscy: Spark, Trino, DuckDB, Snowflake, BigQuery, Microsoft Fabric, pandas, Polars. Dlatego jest domyślnym nośnikiem danych w każdym formacie tabeli z tego poradnika. Osobny wpis o Parquet w otwartym stosie znajdziecie w profilu Apache Parquet.
Apache Avro: wierszowo, pod strumień
Apache Avro układa dane wierszowo: rekord za rekordem, każdy w całości. Schemat zapisany jest w JSON i podróżuje razem z danymi — w nagłówku pliku kontenerowego (Object Container File) albo jako identyfikator w rejestrze schematów (schema registry), gdy rekordy lecą pojedynczo przez Apache Kafka. Specyfikacja Avro formalnie opisuje rozwiązywanie schematów czytelnika i pisarza: czytelnik ze starszym schematem przeczyta rekord zapisany nowszym, jeśli zmiana była zgodna (nowe pole z wartością domyślną, usunięte pole z domyślną wartością po stronie czytelnika, dopuszczone promocje typów jak int → long). Aktualne wydanie to 1.12.2 z sierpnia 2026 (sprawdzono 21.10.2026).
Dlaczego to ważne: w systemach zdarzeniowych każde zdarzenie — „zamówienie złożone”, „paleta wydana” — jest zapisywane i odczytywane w całości, jedno po drugim, często miliony razy na godzinę. Układ wierszowy jest tu tańszy w zapisie niż kolumnowy, a zgodność schematów chroni przed sytuacją, w której dział sprzedaży doda pole do zdarzenia i przewróci system magazynowy, który tego pola nie zna. Avro dobrze pisze, Parquet dobrze czyta — i dlatego w wielu architekturach jedno przechodzi w drugie.
| Cecha | Apache Parquet | Apache Avro |
|---|---|---|
| Układ | kolumnowy | wierszowy |
| Typowy odczyt | kilka kolumn z milionów wierszy | cały rekord, jeden po drugim |
| Typowy zapis | duże paczki (batch) | pojedyncze zdarzenia (stream) |
| Kompresja | wysoka (słownik, RLE, kodeki) | umiarkowana (kodeki na bloki) |
| Schemat | w stopce pliku | JSON w nagłówku albo w rejestrze schematów |
| Ewolucja schematu | po stronie formatu tabeli i silnika | formalne reguły zgodności czytelnik–pisarz |
| Gdzie spotkacie | lakehouse, hurtownie, BI, uczenie modeli | Kafka, integracje, dziennik zdarzeń |
Format tabeli: plan architektoniczny nad stosem cegieł
Wróćmy do nocy z 3:14. Mamy katalog z czterystoma plikami Parquet. Każdy z osobna jest poprawny, dobrze skompresowany i szybki w odczycie. A mimo to nikt nie potrafi powiedzieć, które z nich tworzą aktualną tabelę. Brakuje planu budynku.
Format tabeli (table format) odpowiada na pytanie: które pliki, w jakim schemacie i w jakim podziale składają się na tabelę w danej chwili — i jak tę listę zmieniać bezpiecznie, gdy pisze kilka procesów naraz. Robi to, nie dotykając samych plików danych. Pliki Parquet są niezmienne (immutable): raz zapisanego pliku nikt nie edytuje. Zmiana tabeli polega na dopisaniu nowych plików i zapisaniu nowej wersji metadanych, która mówi: „od teraz tabela to te pliki, a tamtych już nie licz”.
W praktyce każdy z czterech formatów tabel buduje nad plikami trzy rzeczy:
- Log albo drzewo metadanych. Delta Lake prowadzi katalog
_delta_log/z ponumerowanymi plikami JSON — każdy to jedna transakcja z akcjamiadd,remove,metaDataiprotocol— oraz z okresowymi punktami kontrolnymi (checkpoint) w Parquet, żeby nie czytać całej historii od zera. Apache Iceberg buduje drzewo: plik metadanych tabeli wskazuje migawkę (snapshot), migawka wskazuje listę manifestów, manifest (sam zapisany w Avro) wylicza pliki danych wraz ze statystykami. Apache Hudi prowadzi oś czasu (timeline) akcji i indeks rekordów w tabeli metadanych. Apache Paimon przechowuje migawki i manifesty nad drzewem LSM, które porządkuje dane po kluczu głównym. - Atomowe zatwierdzenie. Nowa wersja tabeli staje się widoczna w jednej operacji: zapisie kolejnego pliku logu albo podmianie wskaźnika na nowy
metadata.jsonw katalogu. Czytelnik widzi albo całą starą wersję, albo całą nową. Noc z 3:14 kończy się nieudaną transakcją i nienaruszoną tabelą, nie bagnem. - Abstrakcję tabeli SQL. Dzięki metadanym silnik może wykonać
UPDATE,DELETE,MERGE, zmienić schemat, dodać kolumnę, zmienić partycjonowanie albo odczytać tabelę „na stan z 30 września” (time travel) — wszystko na plikach w magazynie obiektowym, który nadal zna tylko pliki.
To właśnie znaczy, że format tabeli „owija” (wraps) pliki danych. Nie jest bazą danych i nie jest silnikiem. Jest specyfikacją metadanych, którą każdy silnik — Spark, Trino, Flink, DuckDB, Snowflake, Fabric — może przeczytać i zapisać według tych samych reguł. Dlatego dyskusja „Iceberg czy Delta” nie jest dyskusją o szybkości plików. Jest dyskusją o tym, kto i jak prowadzi plan budynku.
— Czy możemy po prostu skasować dane klienta, który skorzystał z prawa do usunięcia? — W bazie tak. W jeziorze trzeba znaleźć plik, przepisać go bez tych wierszy i podmienić, a w międzyczasie raport nie może widzieć pół pliku. (Z formatem tabeli to jedno polecenie
DELETE. Bez formatu tabeli to projekt na tydzień i nerwy prawnika.)
Przy okazji widać, czemu format tabeli jest tematem dla zarządu, nie tylko dla inżynierów. Usunięcie danych osobowych zgodnie z RODO, odtworzenie stanu danych na dzień audytu, pewność, że raport dla banku i raport dla rady nadzorczej liczyły z tej samej wersji tabeli — to wszystko są własności formatu tabeli, nie formatu pliku.
Porównanie: co załatwia plik, a co tabela
| Cecha | Format pliku (Parquet, Avro) | Format tabeli (Delta Lake, Iceberg, Hudi, Paimon) |
|---|---|---|
| Poziom abstrakcji | pojedynczy plik: bajty, typy, kompresja | zbiór plików widziany jako jedna tabela SQL |
| Co zna | własne rekordy i własny schemat | listę plików, schemat tabeli, partycje, historię wersji |
| Transakcje ACID | brak; plik jest albo cały, albo uszkodzony | tak; atomowe zatwierdzenie wersji, izolacja czytelników od pisarzy, kontrola współbieżności |
| Ewolucja schematu | Avro: reguły zgodności czytelnik–pisarz; Parquet: schemat per plik | dodawanie, usuwanie, przemianowanie i zmiana typu kolumn na poziomie tabeli, bez przepisywania danych |
| Podział na partycje | nie istnieje; partycja to tylko nazwa katalogu | partycjonowanie jest metadaną: ukryte partycje i ich ewolucja (Iceberg), klastrowanie (Delta liquid clustering), klucze i kubełki (Hudi, Paimon) |
Operacje UPDATE / DELETE / MERGE | niemożliwe bez przepisania pliku | tak, przez nowe pliki plus metadane; wektory usunięć (deletion vectors) pozwalają oznaczać wiersze bez przepisywania całych plików |
| Podróż w czasie (time travel) | brak | odczyt tabeli na dowolną zachowaną wersję lub znacznik czasu; punkt wyjścia do audytu i odtwarzania błędów |
| Optymalizacja zapytań | statystyki w stopce, indeks stron, filtry Blooma, kompresja kolumnowa | przycinanie plików po statystykach w manifestach i logu, pomijanie partycji, kompaktowanie małych plików, sortowanie i klastrowanie |
| Strumienie i CDC | Avro przenosi zdarzenia | tabela jako źródło i cel strumienia; dziennik zmian (Delta CDF, Hudi incremental, Paimon changelog) |
| Zgodność silników | praktycznie wszystkie silniki czytają Parquet | zależy od formatu i wersji specyfikacji; sprawdzać na własnych silnikach |
| Koszt utrzymania | brak — plik raz zapisany leży | zadania serwisowe: kompaktowanie, czyszczenie starych wersji, przepisywanie manifestów |
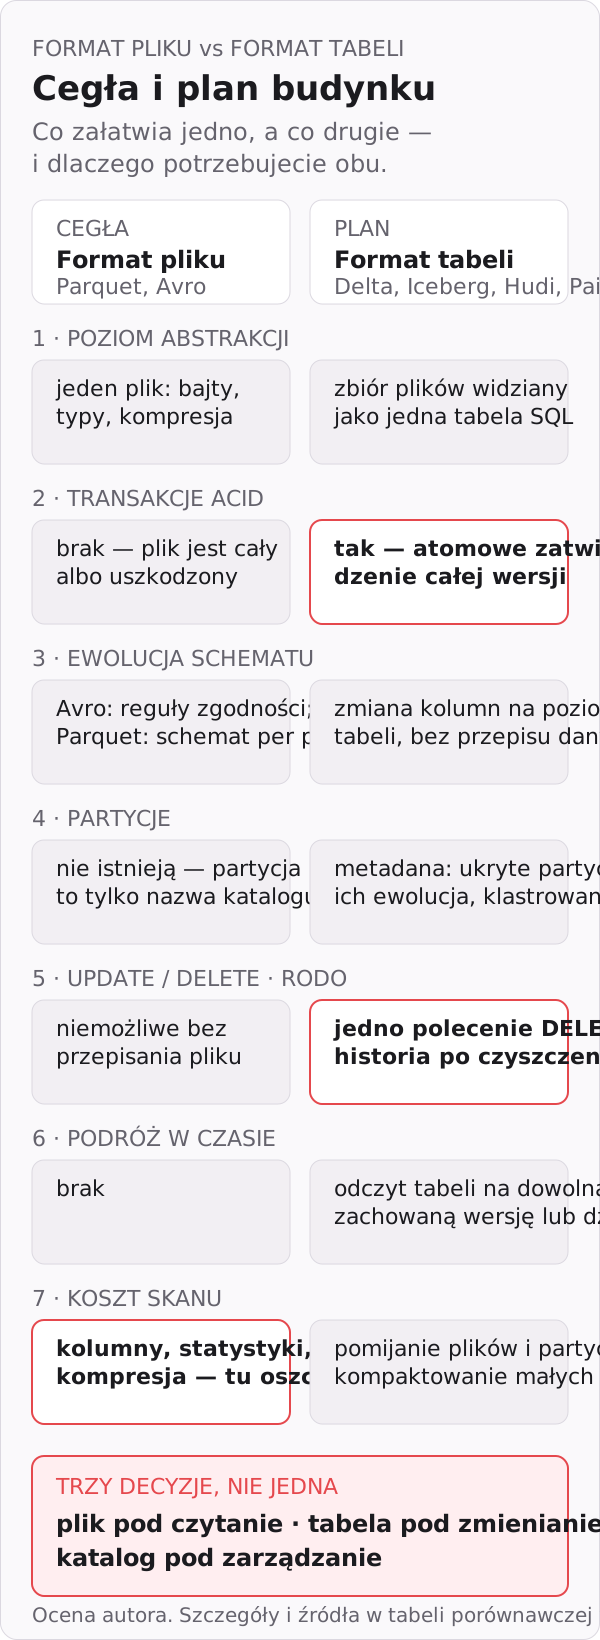
Czytając tabelę wiersz po wierszu, widać regułę: format pliku optymalizuje koszt jednego odczytu, format tabeli optymalizuje zaufanie do całości i koszt zmian. Jedno nie zastąpi drugiego, bo rozwiązuje inny problem.
Gdzie ślepa wiara w format zaszkodzi
Format tabeli nie naprawia sam niczego. Trzy pułapki wracają w prawie każdym projekcie.
Pułapka małych plików. Strumień, który co minutę dopisuje do tabeli kilkaset rekordów, po miesiącu zostawia setki tysięcy plików Parquet po kilkadziesiąt kilobajtów. Każdy jest poprawny, każdy ma własną stopkę i statystyki, a zapytanie, które powinno trwać sekundy, trwa minuty — bo silnik otwiera pliki, nie czyta danych. Format tabeli daje narzędzie (kompaktowanie, OPTIMIZE, klastrowanie), ale ktoś musi je uruchamiać, planować i opłacać. Bez właściciela tabeli lakehouse z czasem staje się droższy niż hurtownia, przed którą uciekał.
Pułapka katalogu. Format tabeli opisuje jedną tabelę. O tym, jakie tabele istnieją, kto ma do nich prawo i gdzie leży aktualny metadata.json, mówi katalog: Unity Catalog, Apache Polaris, Lakekeeper, AWS Glue, katalog Fabric. Dane w otwartym formacie z zamkniętym katalogiem nadal są w połowie zakładnikiem platformy. Plan wyjścia, który kończy się na „mamy Parquet w S3”, nie jest planem wyjścia.
Pułapka „wszystko w czasie rzeczywistym”. Formaty tabel potrafią przyjmować strumienie, a Paimon jest wręcz do tego zbudowany. Ale każda minuta opóźnienia, którą próbujecie zbić, kosztuje więcej małych plików, więcej kompaktowania i więcej złożoności. Raport marży, który zarząd czyta raz dziennie, nie potrzebuje tabeli odświeżanej co pięć sekund. Zacznijcie od pytania, która decyzja biznesowa naprawdę zmienia się w ciągu minuty — zwykle jest ich mniej, niż się wydaje.
Po czym poznać, że format pracuje dla firmy
Nie mierzcie liczby tabel ani terabajtów. Mierzcie to, co zmienia się na fakturze i w zaufaniu do liczb:
- Koszt przeczytania raportu — ile bajtów skanuje typowe zapytanie przed i po przejściu na kolumnowy format pliku z przycinaniem po statystykach. To jest miara efektu Parquet.
- Czas od pytania do odpowiedzi dla najczęstszych zapytań zarządu i agentów AI, mierzony na tych samych danych.
- Liczba kopii tych samych danych w firmie: eksporty do Excela, kopie dla modelu, kopie dla raportu. Format tabeli ma sens, gdy ta liczba spada do jednej.
- Czas odtworzenia stanu na dany dzień — ile trwa odpowiedź na pytanie audytora „jak wyglądały dane 30 czerwca”. Z podróżą w czasie to jedno zapytanie; bez niej to poszukiwanie kopii zapasowych.
- Czas i koszt realizacji żądania usunięcia danych zgodnie z RODO — od zgłoszenia do potwierdzenia, że rekord zniknął również z historii.
Uczciwie trzeba dodać, że na żadną z tych liczb nie wpływa sam format. Wpływa też jakość danych źródłowych, projekt partycji, dyscyplina zadań serwisowych i to, czy ktoś w firmie jest właścicielem tabeli, a nie tylko administratorem klastra.
Złota zasada architekta i pierwszy krok
Zasada brzmi: wybierzcie format pliku pod sposób czytania, format tabeli pod sposób zmieniania, a katalog pod sposób zarządzania — i nie mylcie tych trzech decyzji. Delta Lake potrzebuje Parquet, bo sam nie przechowuje ani jednego wiersza danych; przechowuje tylko wiedzę o tym, które pliki Parquet są tabelą. Iceberg jest z założenia niezależny od formatu plików i obsługuje Parquet, Avro oraz ORC, ale w praktyce prawie zawsze leży na Parquet. Avro najczęściej żyje w strumieniu przed tabelą, a nie w niej — zdarzenia z Kafki lądują w Parquet już pod kontrolą formatu tabeli. Z tego samego powodu formaty tabel dają się tłumaczyć między sobą bez kopiowania danych: Delta UniForm generuje metadane Iceberg obok logu Delta, a Apache XTable (w inkubacji Apache) przepisuje metadane między Delta, Iceberg i Hudi nad tymi samymi plikami Parquet. Tłumaczy się plan budynku, cegły zostają na miejscu.
Oba światy współpracują więc jak cegła i plan architektoniczny: plan bez cegieł jest rysunkiem, cegły bez planu są stertą. Lakehouse jest budynkiem dopiero wtedy, gdy ma oba — i kogoś, kto dba o konserwację.
Jeśli macie zacząć w poniedziałek, zacznijcie od jednej tabeli, która już dziś sprawia kłopot: raport, który pokazuje różne liczby w zależności od godziny. Sprawdźcie, w jakim formacie plików leży, czy ma jakikolwiek format tabeli, kto jest jej właścicielem i kto ostatnio ją zmienił. Odpowiedź na te cztery pytania powie więcej o gotowości Waszych danych do pracy z AI niż jakakolwiek prezentacja vendora.
Mapa wpisów o formatach plików i tabel
Wpisy z tej serii, pogrupowane według warstw. Zacznijcie od profili formatów, które już stoją w Waszym stosie.
Formaty plików
Formaty tabel
- Apache Iceberg: format tabeli, który czytają Snowflake, AWS i Google
- PyIceberg w suwerennym AI OS
- Delta Lake: log transakcji, który zrobił z jeziora danych hurtownię
Katalogi nad tabelami
Strumienie, które zasilają tabele
Nowe teksty serii (październik 2026)
- Parquet czy Avro? Kolumna, kiedy czytacie; wiersz, kiedy piszecie
- Delta Lake, Apache Iceberg czy Apache Hudi? Trzy plany tego samego budynku
- Po „wielkiej trójce”: Apache Paimon i tabela, która nadąża za strumieniem
- Koniec wojny formatów? Jak XTable i Delta UniForm pozwalają zapisać raz, a czytać jako Delta, Iceberg i Hudi
- Apache Avro: jak zdarzenie z hali dociera do Kafki bez zgubionego pola
- Apache Hudi: gdy dane zmieniają się co minutę — CDC i masowe aktualizacje bez przepisywania jeziora
- Apache Paimon: jedna tabela dla strumienia i raportu
Najważniejsze w skrócie
- Format pliku (Parquet, Avro) mówi, jak jeden plik układa bajty. Format tabeli (Delta Lake, Iceberg, Hudi, Paimon) mówi, które pliki są tabelą i jak ją bezpiecznie zmieniać.
- Parquet jest kolumnowy i tani w odczycie analitycznym. Avro jest wierszowy i wygodny w strumieniu zdarzeń z formalną ewolucją schematu.
- Same pliki nie dają transakcji, izolacji ani historii. Format tabeli dodaje je przez niezmienne pliki plus wersjonowane metadane z atomowym zatwierdzeniem.
- Transakcje ACID, podróż w czasie,
DELETEpod RODO i ewolucja schematu to własności formatu tabeli. Koszt skanu to własność formatu pliku. - Trzy decyzje, nie jedna: plik pod czytanie, tabela pod zmienianie, katalog pod zarządzanie. Bez właściciela i zadań serwisowych każdy z tych wyborów z czasem drożeje.
- Dane i analityka
- Open Source AI
- Lakehouse
- Inżynieria danych
