Koniec wojny formatów? Jak XTable i Delta UniForm pozwalają zapisać raz, a czytać jako Delta, Iceberg i Hudi
Temat: Open Source AI
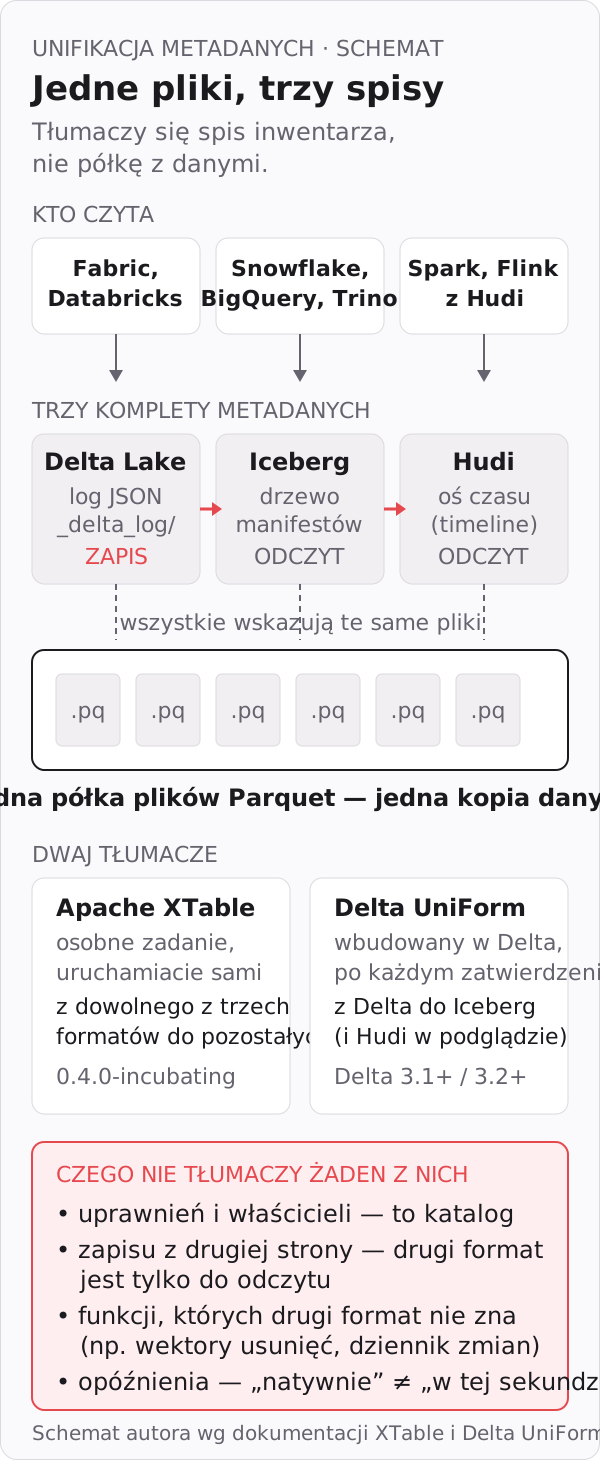
Dane w trzech formatach tabel to trzy komplety metadanych nad tymi samymi plikami Parquet — i właśnie dlatego da się je tłumaczyć bez kopiowania danych. Apache XTable (dawniej OneTable) czyta metadane jednego formatu i dopisuje obok metadane drugiego, więc tabela zapisana jako Delta pojawia się jako Iceberg dla Snowflake i jako Hudi dla silnika, który woli Hudi. Delta UniForm robi to samo od środka Delta Lake: przy każdym zatwierdzeniu generuje metadane Iceberg (i Hudi), żeby platformy czytające Iceberg widziały tabelę natywnie. Dla firmy oznacza to jedną kopię danych i wybór silnika według zadania, a nie według formatu. Ten tekst wyjaśnia, co faktycznie jest tłumaczone, czego nie da się przetłumaczyć i gdzie „jedna kopia” nadal wymaga jednego właściciela. Różnicę między formatem pliku a formatem tabeli, na której stoi cała ta mechanika, porządkuje poradnik o formatach plików i tabel.
Piszę dla dwóch osób. Dla architekta w firmie, która ma Microsoft Fabric albo Databricks i jednocześnie spółkę zależną, dział analityczny albo partnera na Snowflake lub BigQuery. I dla dyrektora IT, który płaci dziś za dwie kopie tych samych danych i chce wiedzieć, czy unifikacja metadanych rozwiązuje jego problem, czy tylko przenosi go do katalogu.
Co dziś nie działa
— Zespół controllingu w spółce zależnej chce liczyć marżę na naszych danych. Oni mają Snowflake. — Nasz lakehouse jest w Delta. Snowflake woli Iceberg. — To skopiujmy im tabelę raz w nocy. (Po pół roku są dwie tabele marży, dwa harmonogramy kopiowania i dwie liczby na posiedzeniu zarządu. Obie z pieczątką „źródło: lakehouse”.)
Kopiowanie tabeli między platformami wygląda na decyzję techniczną, ale jest decyzją o prawdzie. Każda kopia ma własne opóźnienie, własny proces, który może nie zadziałać, i własnego administratora, który o tym nie wie. Różnica w jednej liczbie nie wynika z błędu — wynika z tego, że dwie platformy zobaczyły tabelę o różnych godzinach. Do tego dochodzi koszt składowania dwóch egzemplarzy danych, koszt procesu kopiującego i, co najtrudniejsze do policzenia, koszt godziny, w której dwa zespoły ustalają, która wersja jest właściwa.
Przez lata jedyną odpowiedzią było „wybierzcie jeden format i zmuście wszystkich do jego używania”. Tyle że platformy nie pytają Waszej firmy o zdanie: Databricks i Fabric zapisują w Delta, Snowflake, AWS i Google Cloud rozmawiają w Iceberg, a zespół, który od lat przetwarza zmiany z ERP, trzyma dane w Hudi. Unifikacja metadanych jest próbą zakończenia tej wojny bez zwycięzcy.
Dlaczego to w ogóle możliwe
Trzy formaty tabel różnią się planem budynku, ale używają tych samych cegieł. Pliki danych w Delta Lake, Apache Iceberg i Apache Hudi to w zdecydowanej większości pliki Parquet, a każdy z formatów traktuje je jako niezmienne (immutable): raz zapisany plik nikt nie edytuje, zmiana tabeli to nowe pliki plus nowa wersja metadanych. Format tabeli odpowiada tylko na pytania: które pliki tworzą tabelę w tej chwili, jaki ma schemat, jak jest podzielona, jakie statystyki niesie każdy plik i jaka była jej historia.
Skoro pliki są wspólne, a różni się tylko sposób opisania ich listy, tłumaczenie polega na przepisaniu tej listy do innego drzewa metadanych:
| Co przepisuje tłumacz | Z czego w Delta | Na co w Iceberg | Na co w Hudi |
|---|---|---|---|
| Lista aktualnych plików | akcje add i remove w _delta_log/ | manifesty i lista manifestów wskazywane z migawki | oś czasu (timeline) i grupy plików |
| Schemat tabeli | akcja metaData | schemat w pliku metadanych tabeli z identyfikatorami kolumn | schemat w commicie na osi czasu |
| Partycje | kolumny partycjonujące w metaData | specyfikacja partycji z transformacjami | ścieżki partycji i klucze |
| Statystyki plików | statystyki w akcji add | statystyki kolumn w manifestach | statystyki w metadanych i indeksach |
| Historia wersji | numerowane commity JSON | migawki | instanty na osi czasu |
Rysunek jest prosty: jedna półka z plikami Parquet, nad nią trzy różne spisy inwentarza. Każdy spis mówi to samo innym językiem. Tłumacz czyta jeden spis i pisze drugi; półki nie dotyka. To dlatego cała operacja nie kopiuje danych i nie zwiększa rachunku za składowanie o drugi terabajt — dopisuje kilka megabajtów metadanych.
Są dwa sposoby, żeby ten tłumacz pracował: z zewnątrz tabeli (Apache XTable) albo od środka formatu zapisu (Delta UniForm).
Apache XTable: tłumacz, którego uruchamiacie sami
Apache XTable jest projektem w inkubacji Apache Software Foundation od lutego 2024 roku. Aktualne wydanie to 0.4.0-incubating z sierpnia 2026 (sprawdzono 21.10.2026, lista wydań). Projekt opisuje się jako narzędzie do „bezstratnej” konwersji metadanych między Hudi, Delta i Iceberg „bez kopiowania ani przenoszenia plików danych”.
Model pracy jest prosty. W konfiguracji wskazujecie format źródłowy (sourceFormat) i jeden lub więcej formatów docelowych (targetFormats) oraz ścieżkę tabeli. XTable czyta metadane źródła i zapisuje obok, w tym samym katalogu, metadane docelowe. Z instrukcji projektu wynikają dwa tryby synchronizacji: pełna (FULL), która buduje od nowa listę wszystkich plików, oraz przyrostowa (INCREMENTAL), która dopisuje tylko to, co zmieniło się od poprzedniego uruchomienia. Uruchamiacie to jako zadanie — ręcznie, w harmonogramie albo po każdym zapisie — a wynik rejestrujecie w katalogu, którego używa silnik czytający.
Wydanie 0.4.0 dodało między innymi cel oparty na Delta Kernel, źródła Paimon i surowego Parquet oraz środowisko uruchomieniowe dla Spark. Z dokumentacji wynikają też ograniczenia, które decydują o tym, czy XTable pasuje do Waszego stosu: tabele Merge-on-Read w Hudi i Iceberg nie są obsługiwane, podobnie jak wektory usunięć (deletion vectors) w Delta. Innymi słowy, XTable najlepiej radzi sobie z tabelami, które zmieniają się przez dopisywanie i przepisywanie plików, a gorzej z takimi, gdzie usunięcia i aktualizacje są oznaczane „na boku”.
Blog Microsoft Fabric podaje, że OneLake korzysta z Apache XTable, żeby udostępniać tabele Delta jako Iceberg i odwrotnie. Jeśli używacie Fabric, nie uruchamiacie XTable sami — dokumentacja OneLake opisuje to jako wirtualizację metadanych z własnymi ograniczeniami (między innymi limit liczby commitów i opóźnienie od kilku sekund do kilku minut; sprawdzono 21.10.2026).
Delta UniForm: tłumacz wbudowany w format zapisu
Delta UniForm (Universal Format) jest funkcją samego Delta Lake. Po włączeniu na tabeli Delta generuje po każdym zatwierdzeniu metadane Iceberg — a w trybie podglądowym także Hudi — i zapisuje je obok logu Delta. Nie ma osobnego zadania do uruchamiania: tłumaczenie jest asynchroniczną częścią zapisu.
Z dokumentacji (sprawdzono 21.10.2026) wynikają warunki i granice:
- tabela musi używać mapowania kolumn (column mapping) i mieć protokół czytelnika co najmniej 2 oraz pisarza co najmniej 7, z włączoną właściwością
delta.enableIcebergCompatV2; - Iceberg przez UniForm jest dostępny od Delta 3.1, Hudi od Delta 3.2;
- strona Iceberg i Hudi jest tylko do odczytu — zapis nadal odbywa się wyłącznie przez Delta;
- wektory usunięć nie są przenoszone do widoku Iceberg; dokumentacja Databricks rozróżnia odczyt jako Iceberg v2 (bez wektorów) i v3 (z wektorami) oraz opisuje polecenie
REORG … UPGRADE UNIFORM, które fizycznie usuwa wektory z plików; - typ
VOIDjest nieobsługiwany, a dziennik zmian (Change Data Feed) nie jest widoczny od strony Iceberg; - Delta 4.3.0 z czerwca 2026 dodała atomową przyrostową konwersję metadanych Iceberg (lista wydań).
Jak czytają to inne platformy: BigQuery sięga po wersjonowany plik metadanych Iceberg wskazany ścieżką, Databricks udostępnia tabele UniForm przez punkt końcowy Iceberg REST w Unity Catalog, a Snowflake może zarejestrować tabelę Iceberg przez integrację z katalogiem zewnętrznym (dokumentacja Snowflake). Szczegóły pełnego profilu Delta Lake, w tym rolę protokołu i funkcji tabeli, opisuje profil Delta Lake.
| Kryterium | Apache XTable | Delta UniForm |
|---|---|---|
| Gdzie żyje | osobne narzędzie uruchamiane obok tabeli | funkcja wbudowana w Delta Lake |
| Kto uruchamia | Wy: zadanie ręczne, harmonogram, hook po zapisie; w Fabric — platforma | pisarz Delta, asynchronicznie po zatwierdzeniu |
| Format zapisu | dowolny z trzech (Hudi, Delta, Iceberg); od 0.4.0 także Paimon i Parquet jako źródła | tylko Delta |
| Formaty odczytu | pozostałe z trzech | Iceberg; Hudi w podglądzie |
| Tryby | pełny i przyrostowy | przyrostowy po każdym commicie |
| Ograniczenia z dokumentacji | brak obsługi Merge-on-Read w Hudi/Iceberg i wektorów usunięć w Delta | wymagane mapowanie kolumn i protokół 2/7; brak wektorów usunięć w Iceberg v2, brak CDF i typu VOID |
| Status | 0.4.0-incubating, inkubacja ASF | część Delta Lake od 3.1 (Iceberg) i 3.2 (Hudi) |
| Dobre dopasowanie | wiele formatów zapisu w firmie, własny stos, Fabric (pod spodem) | Databricks lub własny Spark z Delta jako jedynym formatem zapisu |
Kontekst rynkowy: dlaczego to się dzieje teraz
Kilka faktów, bez prognoz. W czerwcu 2024 roku Databricks ogłosił przejęcie Tabular, firmy założonej przez twórców Apache Iceberg, deklarując jako cel krótkoterminowy zgodność Delta i Iceberg przez UniForm. W grudniu 2024 AWS udostępnił Amazon S3 Tables z wbudowanym Icebergiem. Snowflake prowadzi Open Catalog jako zarządzaną wersję Apache Polaris, który w lutym 2026 został projektem najwyższego poziomu ASF. Confluent oferuje Tableflow, który materializuje tematy Kafki jako tabele Iceberg lub Delta w katalogach Glue, Unity, Polaris i Open Catalog. Google udostępnia zarządzane tabele Iceberg w BigQuery i katalog REST Iceberg w usłudze Lakehouse.
Wspólny mianownik: żaden z dużych vendorów nie ogłosił, że porzuca swój format. Zamiast tego każdy uczy się czytać format sąsiada, a otwarta specyfikacja katalogu REST Iceberg staje się punktem styku. Dla Waszej firmy to dobra wiadomość — oraz powód, żeby nie podejmować decyzji o formacie na podstawie tego, kto wygrywa w danym kwartale. Jak czytać ten krajobraz na poziomie wyboru formatu, opisuje porównanie Delta Lake, Iceberg i Hudi.
Gdzie „jedna kopia” zaszkodzi
Unifikacja metadanych rozwiązuje jeden problem — kopiowanie danych między formatami — i nie dotyka czterech innych. Warto je nazwać, zanim ktoś na zarządzie usłyszy „mamy już jedną kopię”.
Tłumaczy się metadane, nie uprawnienia. XTable i UniForm przepisują listę plików, schemat i partycje. Nie przepisują tego, kto ma prawo czytać tabelę, kto jest jej właścicielem i jakie reguły maskowania obowiązują. Katalog po stronie Snowflake trzeba skonfigurować osobno od katalogu po stronie Fabric, a dwa katalogi to dwie listy uprawnień do uzgodnienia. Firma, która kupiła unifikację, żeby „mieć jedną prawdę”, bez uzgodnienia uprawnień ma jedną prawdę dostępną różnym osobom w różnych miejscach.
„Natywnie” nie znaczy „w tej samej sekundzie”. UniForm generuje metadane asynchronicznie po zatwierdzeniu, XTable po uruchomieniu zadania, a wirtualizacja w OneLake ma udokumentowane opóźnienie. Raport w Snowflake może przez chwilę widzieć tabelę o jeden commit starszą niż notatnik w Databricks. Dla raportu dziennego to bez znaczenia; dla procesu, który na podstawie tej tabeli blokuje limit kredytowy klienta, znaczenie ma.
Jeden format pozostaje formatem zapisu. To tam decyduje się, kto jest właścicielem tabeli, kto uruchamia kompaktowanie i czyszczenie, kto odpowiada za usunięcie danych pod RODO. Drugi widok jest lustrem. Jeśli ktoś w spółce zależnej zapisze „swoją” wersję w Iceberg obok, powstają dwa logi transakcji nad jednymi plikami — i wojna formatów wraca pod nową nazwą.
Funkcje, których drugi format nie zna, nie przetłumaczą się. Wektory usunięć, dziennik zmian, niektóre typy danych — listy ograniczeń w dokumentacji XTable i UniForm są dłuższe niż jedno zdanie i zmieniają się z wersjami. Przed włączeniem trzeba przeczytać je dla Waszej wersji Delta, Iceberg i silników, a nie dla wersji z prezentacji vendora.
Przykład dydaktyczny: grupa z Fabric i spółką zależną na Snowflake
To przykład ilustracyjny, nie opis wdrożenia u klienta. Wyobraźcie sobie grupę handlowo-produkcyjną zatrudniającą około 200 osób, która trzyma dane z ERP, WMS i sklepu w lakehouse na Microsoft Fabric, a jej spółka zależna — przejęta dwa lata wcześniej — ma zespół analityczny pracujący w Snowflake.
Stan przed. Co noc zadanie kopiuje pięć tabel (sprzedaż, zapasy, cennik, klienci, marża) z OneLake do magazynu Snowflake. Załóżmy, że kopia opóźnia dane o jeden dzień, a dwa razy w kwartale zadanie nie kończy się przed poranną prezentacją. Grupa płaci za składowanie dwóch egzemplarzy tych samych tabel i utrzymuje osobny proces kopiujący z osobnym właścicielem. Gdy controlling obu spółek liczy marżę, liczby różnią się o korekty dopisane po północy — i spotkanie zaczyna się od ustalania, kto ma rację.
Co robi system po zmianie. Tabele pozostają zapisywane w Delta w OneLake. Przez wirtualizację metadanych w Fabric (pod spodem XTable) spółka zależna rejestruje te same tabele jako Iceberg w swoim katalogu i czyta je w Snowflake bez kopii. Alternatywa dla grupy na Databricks wyglądałaby identycznie z UniForm włączonym na tabelach Delta i punktem końcowym Iceberg REST w Unity Catalog. Zadanie kopiujące zostaje wyłączone. Obie spółki czytają tę samą listę plików, z opóźnieniem liczonym w minutach, nie w dobach.
Co zostaje przy człowieku. Właściciel każdej z pięciu tabel jest po stronie formatu zapisu i to on zatwierdza zmianę schematu, retencję historii i realizację żądań usunięcia danych. Dyrektor finansowy grupy decyduje, która definicja marży jest definicją grupy — unifikacja metadanych nie uzgodni za niego, czy bonus roczny wchodzi do marży klienta. Administratorzy obu katalogów uzgadniają listę uprawnień: kto w spółce zależnej widzi cennik, a kto tylko marżę zagregowaną.
Czym to zmierzyć. Liczba kopii każdej tabeli (cel: jedna), koszt składowania zduplikowanych danych (znika w miesiącu po wyłączeniu kopii), opóźnienie od zapisu w Fabric do widoczności w Snowflake (mierzone, nie deklarowane), liczba zadań ETL „kopiujących między formatami”, które udało się wyłączyć, oraz — mniej wygodnie — liczba spotkań, które zaczynają się od uzgadniania wersji danych.
Po czym poznać wartość
Metryki próżności są tu wyjątkowo kuszące: „obsługujemy trzy formaty”, „mamy interoperacyjność”. Żadna z nich nie zmienia rachunku. Mierzcie to, co zmienia:
| Miara | Dlaczego ma znaczenie |
|---|---|
| Liczba kopii tej samej tabeli w grupie | każda kopia to osobna prawda i osobny koszt |
| Koszt składowania zduplikowanych danych na miesiąc | jedyna oszczędność, którą zobaczycie na fakturze wprost |
| Zmierzone opóźnienie zapis → widoczność w drugim silniku | decyduje, które procesy mogą korzystać z widoku |
| Liczba wyłączonych zadań kopiujących | mniej procesów, mniej właścicieli, mniej nocnych awarii |
| Czas realizacji żądania usunięcia danych do zniknięcia z obu widoków | mierzy, czy RODO jest spełnione w praktyce, nie w poleceniu SQL |
Uczciwie: na żadną z tych liczb nie wpływa sam XTable ani UniForm. Wpływa to, czy ktoś wyłączył stare kopie, uzgodnił uprawnienia i jest właścicielem formatu zapisu.
Pierwszy krok
W poniedziałek wybierzcie jedną tabelę, którą dziś kopiujecie między platformami — najlepiej tę, o którą zdarzyło się spierać na zarządzie. Sprawdźcie jej format zapisu i wersję Delta albo Iceberg, przeczytajcie listę ograniczeń UniForm lub XTable dla tej wersji, włączcie unifikację na tej jednej tabeli i porównajcie wyniki zapytania z obu stron przez tydzień. Dopiero gdy liczby się zgadzają, a opóźnienie jest zmierzone, wyłączcie kopię. Jeśli przy tej okazji okaże się, że tabela nie ma właściciela — to jest Wasz prawdziwy pierwszy problem, a formaty są drugim.
Najważniejsze w skrócie
- Delta Lake, Iceberg i Hudi różnią się metadanymi, nie plikami. Dlatego tabelę da się przetłumaczyć bez kopiowania danych.
- Apache XTable (0.4.0-incubating) to osobny tłumacz, który uruchamiacie sami; Delta UniForm to tłumacz wbudowany w Delta, działający po każdym zatwierdzeniu. Fabric OneLake korzysta z XTable pod spodem.
- Tłumaczy się lista plików, schemat, partycje i statystyki. Nie tłumaczą się uprawnienia, katalog, dziennik zmian ani funkcje nieznane drugiemu formatowi.
- Drugi format jest widokiem tylko do odczytu. Właściciel tabeli, zadania serwisowe i usunięcia pod RODO zostają po stronie formatu zapisu.
- Mierzcie liczbę kopii, koszt składowania, zmierzone opóźnienie i czas usunięcia danych — nie liczbę „obsługiwanych formatów”.
- Dane i analityka
- Open Source AI
- Lakehouse
- Microsoft Fabric
- Inżynieria danych
