Apache Avro: jak zdarzenie z hali dociera do Kafki bez zgubionego pola
Temat: Open Source AI
Avro jest formatem, który w architekturze zdarzeniowej pilnuje jednej rzeczy: że to, co system magazynowy wysłał, system sprzedaży przeczyta — także wtedy, gdy między wysłaniem a odczytem ktoś dodał pole. Robi to przez schemat zapisany w JSON, formalne reguły zgodności czytelnika i pisarza oraz rejestr schematów, w którym każda wersja ma numer. Dla firmy, która łączy ERP, WMS i sklep strumieniem zdarzeń w Apache Kafka, Avro jest umową między działami zapisaną w formacie, a nie w mailu.
Ten profil pokazuje, jak Avro działa od środka, gdzie przewyższa JSON i Protobuf, a gdzie oddaje pole Parquet. Piszemy go dla architekta integracji, zespołu utrzymującego Kafkę i menedżera, który odpowiada za to, żeby trzy systemy mówiły o zamówieniu to samo. Pojęcie formatu pliku (data format) i jego relację do formatu tabeli wyjaśnia poradnik o formatach plików i tabel.
Co dziś nie działa
— Import zamówień ze sklepu do WMS-a stanął w sobotę o 6:00. — Co się zmieniło? — Sklep dodał pole „rabat_procent”. Nasz parser tego nie znał. — Przecież dodanie pola nie powinno nic psuć. — Nie powinno. Ale nikt nie zapisał, co znaczy „nie powinno”. (Umowa między sklepem a magazynem istniała. W głowie programisty, który odszedł w marcu.)
W firmie od 50 do 300 osób systemy rozmawiają ze sobą zwykle przez pliki i interfejsy budowane punkt–punkt: eksport z ERP do WMS, drugi eksport z ERP do sklepu, trzeci ze sklepu do systemu kurierskiego. Każde połączenie ma własną, niespisaną definicję rekordu. Dodanie jednego pola po jednej stronie to loteria po drugiej. A kiedy połączeń jest dziesięć, każdy nowy wymóg działu sprzedaży — „chcemy widzieć rabat na zamówieniu” — kosztuje tydzień uzgadniania i trzy weekendy awarii.
Architektura zdarzeniowa (event-driven architecture) zamienia dziesięć połączeń na jeden strumień: każdy system publikuje zdarzenia („zamówienie złożone”, „paleta wydana”, „zwrot przyjęty”), a każdy zainteresowany je czyta. To działa pod jednym warunkiem — kształt zdarzenia musi być umową, której ktoś pilnuje. Tym kimś jest Avro z rejestrem schematów.
Architektura wewnętrzna: schemat, bajty, kontener
Specyfikacja Avro (aktualne wydanie 1.12.2 z sierpnia 2026, sprawdzono 21.10.2026) opisuje cztery elementy, które warto rozumieć, zanim ktoś w zespole powie „po prostu użyjmy Avro”.
Schemat w JSON. Schemat to dokument JSON: typy proste (null, boolean, int, long, float, double, bytes, string) i złożone (record, enum, array, map, union, fixed). Pole może mieć wartość domyślną — i to ta wartość domyślna decyduje, czy dodanie pola będzie zmianą zgodną. Unia ["null", "string"] to sposób zapisu pola opcjonalnego. Schemat czyta człowiek i maszyna, więc może leżeć w repozytorium obok kodu i podlegać przeglądowi jak każda inna zmiana umowy.
Kodowanie binarne bez znaczników. W danych nie ma nazw pól ani typów. Pisarz zapisuje wartości w kolejności ze schematu, czytelnik odczytuje je w tej samej kolejności, bo zna schemat. Dlatego rekord Avro jest mały — i dlatego bez schematu jest nieczytelnym ciągiem bajtów. To nie wada, to konstrukcja: schemat musi być dostępny, więc nie da się go „zgubić po drodze”.
Plik kontenerowy (Object Container File). Gdy zdarzenia zapisuje się do pliku, a nie wysyła pojedynczo, Avro pakuje je w kontener: nagłówek z magicznymi bajtami, metadanymi (wymagany avro.schema, opcjonalny avro.codec) i szesnastobajtowym znacznikiem synchronizacji, a potem bloki rekordów rozdzielone tym znacznikiem. Znacznik pozwala podzielić duży plik między wiele procesów bez czytania go od początku. Kodeki null i deflate są wymagane; snappy, zstandard, bzip2 i xz opcjonalne.
Kodowanie pojedynczego obiektu (single-object encoding). Gdy rekord leci sam — przez kolejkę, przez HTTP — nie ma nagłówka pliku, w którym leżałby schemat. Avro definiuje więc format: dwubajtowy marker, ośmiobajtowy odcisk schematu (CRC-64-AVRO) i dane. Odczytujący znajduje schemat po odcisku. W praktyce w ekosystemie Kafki tę rolę pełni rejestr schematów z własnym formatem ramki, o czym niżej.
| Element | Co robi | Dlaczego ma znaczenie dla firmy |
|---|---|---|
| Schemat JSON | definiuje pola, typy, wartości domyślne | umowa między działami, którą można przejrzeć i wersjonować |
| Kodowanie binarne | wartości bez nazw pól | mały komunikat; schemat zawsze musi być pod ręką |
| Plik kontenerowy | schemat w nagłówku, bloki ze znacznikiem | archiwum zdarzeń czytelne po latach, dzielone między procesy |
| Kodowanie pojedynczego obiektu | odcisk schematu przed danymi | zdarzenie w locie da się rozpoznać bez pliku |
Rozwiązywanie schematu: umowa, która przeżywa zmiany
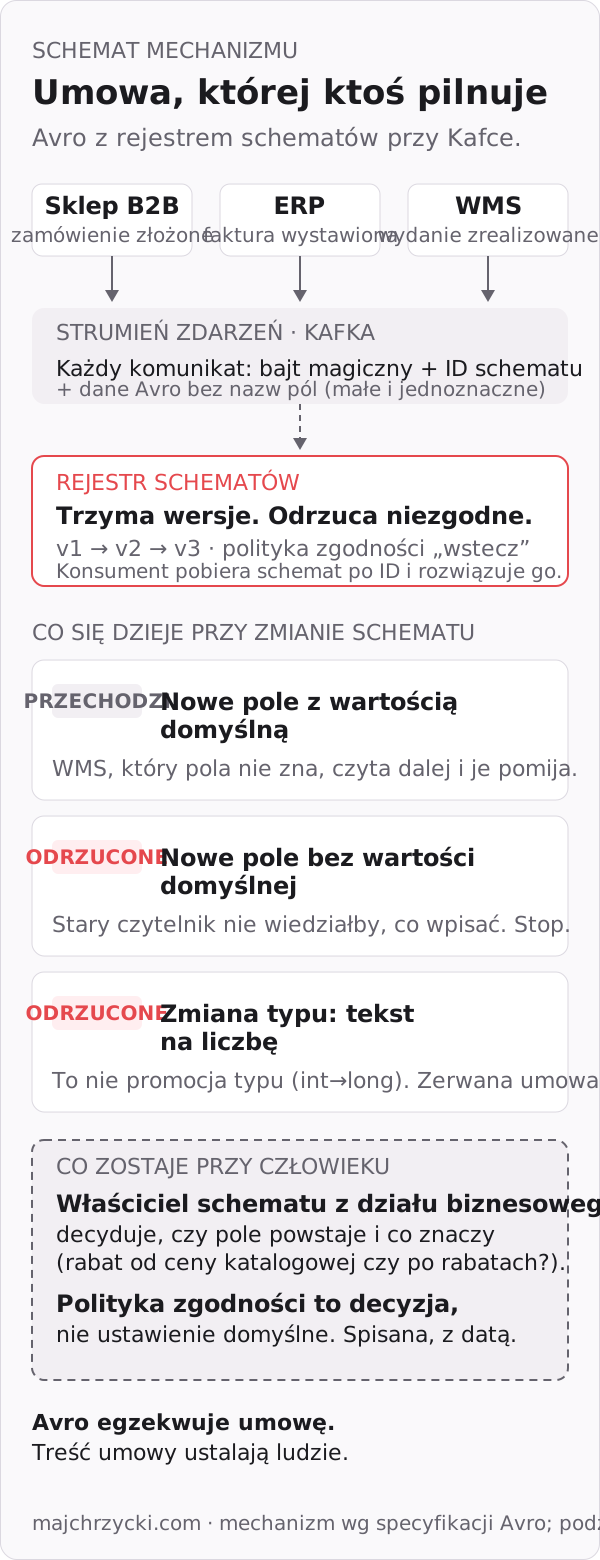
Serce Avro to reguły rozwiązywania schematu czytelnika i pisarza (reader/writer schema resolution). Pisarz zapisał rekord według swojego schematu. Czytelnik ma swój — być może starszy, być może nowszy. Specyfikacja mówi, co się dzieje:
- Pola dopasowuje się po nazwie, nie po pozycji. Przesunięta kolumna z pierwszej scenki nie ma tu racji bytu.
- Pole, które pisarz zapisał, a czytelnik go nie zna, jest pomijane. Sklep może dodać
rabat_procent, a WMS, który o rabatach nie wie, czyta dalej. - Pole, którego czytelnik oczekuje, a pisarz nie zapisał, dostaje wartość domyślną ze schematu czytelnika. Jeśli wartości domyślnej nie ma — odczyt kończy się błędem. To jest miejsce, w którym zmiana staje się niezgodna.
- Dozwolone są promocje typów:
intnalong,floatlubdouble;longnafloatlubdouble;floatnadouble;stringnabytesi odwrotnie. Zmianastringnaintnie jest promocją — jest zerwaniem umowy. - Dla
enumnieznany symbol przyjmuje wartość domyślną czytelnika, jeśli ją zdefiniowano; dlauniongałąź pisarza dopasowuje się do pierwszej zgodnej gałęzi czytelnika.
Z tych reguł wynikają trzy polityki zgodności, które rejestr schematów egzekwuje przy rejestracji nowej wersji:
| Polityka | Co gwarantuje | Co wolno zmienić |
|---|---|---|
| Wstecz (backward) | nowy czytelnik przeczyta stare dane | dodać pole z wartością domyślną, usunąć pole |
| W przód (forward) | stary czytelnik przeczyta nowe dane | dodać pole, usunąć pole z wartością domyślną |
| Pełna (full) | oba kierunki | dodać lub usunąć tylko pola z wartością domyślną |
Rejestr schematów przy Kafce. Według dokumentacji Confluent każdy komunikat w Kafce zaczyna się bajtem magicznym (0), czterobajtowym identyfikatorem schematu i dopiero potem danymi Avro. Producent przy pierwszym wysłaniu rejestruje schemat i dostaje identyfikator; konsument po identyfikatorze pobiera schemat i rozwiązuje go względem swojego. Rejestr obsługuje Avro, Protobuf i JSON Schema, a jego API implementują też otwarte alternatywy — Apicurio Registry i Karapace. Najważniejsze jest to, że rejestr odrzuca rejestrację schematu niezgodnego z polityką. Umowa między działami ma wreszcie strażnika, który nie wyjeżdża na urlop.
Unikalne cechy — i miejsce Avro w stosie danych
| Cecha | Co daje | Gdzie to widać |
|---|---|---|
| Schemat podróżuje z danymi | zdarzenie zawsze da się odczytać poprawnie | nagłówek pliku, identyfikator w rejestrze |
| Formalne reguły zgodności | zmiana schematu jest przewidywalna i sprawdzalna | polityka w rejestrze, przegląd schematu jak kodu |
| Mały rekord | tani transport i składowanie strumienia | brak nazw pól w danych |
| Niezależność od języka | ERP w Javie, sklep w Pythonie, WMS w C# czytają to samo | biblioteki Avro dla wielu języków, tryb generyczny bez generowania kodu |
| Wsparcie narzędzi strumieniowych | gotowe konektory i serializatory | Kafka Connect, Debezium, Flink, Spark, Hudi Streamer |
| Rola w formatach tabel | manifesty Apache Iceberg są plikami Avro | lista plików czytana w całości, rekord po rekordzie |
Ostatni wiersz pokazuje, dlaczego spór „Avro czy Parquet” jest źle postawiony: nawet format tabeli zbudowany na Parquet używa Avro tam, gdzie czyta się całe rekordy po kolei. Avro i Parquet to dwie cegły o różnym kształcie, a nie dwa konkurencyjne budynki. Rozwinięcie tego porównania znajdziecie w tekście Parquet czy Avro: kolumna, kiedy czytacie; wiersz, kiedy piszecie.
Przykład dydaktyczny: trzy systemy, jedna umowa
To przykład ilustracyjny, nie studium klienta — pokazuje mechanizm na typowej firmie, nie opisuje konkretnego wdrożenia.
Firma produkcyjno-handlowa, około 150 osób. Trzy systemy: ERP (zamówienia, faktury, stany księgowe), WMS (lokalizacje, kompletacja, wydania) i sklep B2B z integracją do marketplace. Dziś połączone są sześcioma eksportami plikowymi i dwoma interfejsami, które napisał integrator trzy lata temu. Każda zmiana w jednym systemie wymaga sprawdzenia, które z ośmiu połączeń się przewróci — a sprawdzenie polega na uruchomieniu i czekaniu.
Stan po przejściu na zdarzenia w Avro. Każdy system publikuje do Kafki trzy–cztery typy zdarzeń: „zamówienie złożone”, „zamówienie zmienione”, „wydanie zrealizowane”, „zwrot przyjęty”. Każdy typ ma schemat Avro w rejestrze z polityką zgodności „wstecz” i przypisanym właścicielem — osobą z działu, który zdarzenie publikuje. Konsumenci czytają to, co ich dotyczy: WMS czyta zamówienia, ERP czyta wydania i zwroty, warstwa analityczna czyta wszystko i zapisuje do tabel w lakehouse.
Co robi system. Rejestr sprawdza każdą nową wersję schematu i odrzuca niezgodną, zanim dotrze do produkcji. Serializatory w konektorach dbają, by każdy komunikat niósł identyfikator schematu. Konsumenci rozwiązują schemat automatycznie: nowe pole rabat_procent ze sklepu trafia do analityki, a WMS je pomija, bo go nie potrzebuje. Nikt nie pisze parsera od nowa.
Co zostaje przy człowieku. Decyzja, że rabat_procent w ogóle powstaje i co znaczy — czy to rabat od ceny katalogowej, czy od ceny po poprzednich rabatach — należy do właściciela schematu z działu sprzedaży. Decyzja o polityce zgodności (czy dopuszczamy usuwanie pól) należy do architekta i jest spisana. Decyzja, kto odpowiada, gdy dwa działy chcą zmienić to samo pole w różny sposób, należy do kierownika operacji. Avro egzekwuje umowę; treść umowy ustalają ludzie.
Czym to zmierzyć. Załóżmy, że dziś każda zmiana pola w jednym z systemów wymaga ręcznego sprawdzenia ośmiu połączeń i średnio jednej awarii na kwartał. Po zmianie mierzycie: liczbę awarii importu po zmianie schematu (cel: zero, bo niezgodne zmiany nie przechodzą rejestracji), czas od zgłoszenia nowego pola przez dział do jego obecności w analityce, liczbę połączeń punkt–punkt do utrzymania (z ośmiu do jednego strumienia i trzech konsumentów). Koszt całkowity (Total Cost of Ownership, TCO) nie spada przez sam format — spada, bo osiem umów ustnych zamienia się w cztery spisane schematy z właścicielem. Liczby w Waszej firmie będą inne; mechanizm ten sam.
Gdzie Avro zaszkodzi albo nie wystarczy
Analityka kolumnowa. Raport marży na plikach Avro czyta wszystkie pola każdego rekordu. Zdarzenia do analityki muszą trafić do tabeli na Parquet — Avro w tej roli jest tylko kurierem.
Rejestr to kolejny komponent z właścicielem. Rejestr schematów trzeba uruchomić, zabezpieczyć, kopiować i monitorować. Bez niego Avro w Kafce traci swoją główną zaletę. Jeśli nikt nie chce być właścicielem rejestru, to znak, że firma nie jest gotowa na architekturę zdarzeniową — nie na Avro.
Unie i wartości domyślne łatwo zaprojektować źle. Pole ["null", "string"] z domyślnym null jest poprawne; pole ["string", "null"] z domyślnym null już nie, bo wartość domyślna musi pasować do pierwszej gałęzi unii. Takie szczegóły nie są trudne, ale wymagają, by schematy przechodziły przegląd jak kod.
Alternatywy. Protobuf, gdy te same definicje służą też komunikacji między usługami (gRPC) i zespół programistów już go używa. JSON Schema, gdy czytelność dla człowieka jest ważniejsza niż rozmiar. Rejestr Confluent obsługuje wszystkie trzy, więc decyzja nie zamyka drogi — ale mieszanie formatów w jednym strumieniu to prośba o kłopoty.
Po czym poznać wartość
| Miernik wyniku | Miernik próżności |
|---|---|
| Awarie importu po zmianie schematu na kwartał | Liczba schematów w rejestrze |
| Czas od zgłoszenia pola do jego obecności w raporcie | Liczba tematów w Kafce |
| Liczba połączeń punkt–punkt do utrzymania | Liczba komunikatów na sekundę |
| Liczba pól bez właściciela i bez definicji | Rozmiar klastra Kafki |
Uczciwie: na liczbę awarii wpływa też jakość danych źródłowych i dyscyplina przeglądu schematów. Avro daje narzędzie do egzekwowania umowy — nie zastępuje umowy.
Pierwszy krok w poniedziałek
- Wybierzcie jeden temat Kafki (albo jedno dzisiejsze połączenie plikowe, które najczęściej się przewraca) i spiszcie schemat jego rekordu w Avro — z wartościami domyślnymi dla każdego pola, które bywa puste.
- Uruchomcie rejestr schematów z polityką zgodności „wstecz” i zarejestrujcie schemat.
- Spróbujcie zarejestrować wersję z nowym polem bez wartości domyślnej. Rejestr ma odmówić. Jeśli przyjął — sprawdźcie politykę.
- Wpiszcie przy schemacie imię i nazwisko właściciela z działu biznesowego, nie z IT.
Jeżeli przy punkcie czwartym nikt nie chce się podpisać, zaczęliście od właściwego problemu.
Co sprawdzić przed decyzją
- Wersję biblioteki Avro w każdym języku, który u Was publikuje lub czyta zdarzenia; aktualne wydanie to 1.12.2 (blog projektu, sprawdzono 21.10.2026).
- Który rejestr schematów (Confluent, Apicurio, Karapace), na jakiej licencji i w jakim modelu wdrożenia; czy Wasze konektory Kafka Connect i Debezium go obsługują.
- Politykę zgodności na każdym temacie — spisaną, nie domyślną.
- Kto jest właścicielem każdego schematu i jak wygląda przegląd zmiany.
Najważniejsze w skrócie
- Avro to format wierszowy ze schematem w JSON, kodowaniem binarnym bez nazw pól i formalnymi regułami rozwiązywania schematu czytelnika i pisarza.
- W Kafce schemat nie podróżuje z każdym komunikatem — podróżuje jego identyfikator, a rejestr schematów trzyma wersje i odrzuca zmiany niezgodne z polityką.
- Dodanie pola z wartością domyślną jest zmianą zgodną; dodanie bez wartości domyślnej albo zmiana typu poza promocjami — nie.
- Avro jest kurierem zdarzeń; do analityki dane trafiają do tabeli na Parquet. Nawet Iceberg używa Avro na manifesty, bo czyta je rekord po rekordzie.
- Format egzekwuje umowę, ale treść umowy — co znaczy pole, kto jest jego właścicielem, jaka polityka zgodności — to decyzje ludzi.
- Dane i analityka
- Open Source AI
- Kafka
- Integracja systemów
- Inżynieria danych
