Co to jest lakehouse? Dane pod AI — poradnik dla firm
Temat: Open Source AI
Lakehouse to jezioro danych, w którym pliki zachowują się jak tabele w hurtowni. Dane leżą w tanim magazynie obiektowym, a nad nimi działa otwarty format tabel — Apache Iceberg, Delta Lake albo Apache Hudi — który dodaje transakcje, migawki i schemat. Dzięki temu te same dane mogą czytać i zapisywać różne silniki: do raportów, do analiz, do modeli i agentów AI. Lakehouse ma sens, gdy danych jest dużo, są różnego rodzaju i pracuje na nich kilka narzędzi; przy mniejszej skali często wystarczy jedna baza albo hurtownia.
Poradnik jest dla zarządu i lidera danych w firmie od 50 osób, który słyszy „lakehouse”, „Iceberg” i „OneLake” na każdej prezentacji vendora i chce wiedzieć, czy to w ogóle jego problem. Na końcu jest mapa wszystkich wpisów serii o lakehouse i inżynierii danych open source, pogrupowanych według warstw. Szerszy kontekst — cały otwarty stos AI, od sprzętu po interfejs — opisuje poradnik o AI OS dla firm, a przewodnik Open Source AI zbiera całą tematykę.
Czym jest lakehouse: jezioro danych z tabelami z transakcjami
Przez lata firmy miały dwa osobne miejsca na dane. Hurtownia danych trzyma uporządkowane tabele, pilnuje schematu i transakcji, świetnie obsługuje raporty — ale jest droga przy dużych wolumenach i zamyka dane we własnym formacie. Jezioro danych to pliki w magazynie obiektowym: tanie, pojemne, przyjmą logi, dokumenty i obrazy. Tyle że jezioro samo nie wie, który plik należy do aktualnej wersji tabeli. Gdy dwa programy piszą jednocześnie, łatwo o bałagan.
Lakehouse łączy oba światy. Pojęcie opisali w 2021 roku Armbrust, Ghodsi, Xin i Zaharia w artykule na konferencji CIDR: otwarte formaty plików z bezpośrednim dostępem, wsparcie dla uczenia maszynowego i wydajność zbliżona do hurtowni. Databricks definiuje lakehouse jako system łączący zalety jeziora i hurtowni.
Sercem lakehouse jest format tabel. To nie program, tylko specyfikacja metadanych zapisanych obok plików z danymi. Specyfikacja Apache Iceberg opisuje migawki tabeli, atomowe zatwierdzanie zmian z izolacją serializowalną, ewolucję schematu i ukryte partycjonowanie. Delta Lake daje transakcje ACID, podróż w czasie, aktualizacje i usuwanie rekordów oraz jedną tabelę dla wsadów i strumieni. Apache Hudi kładzie nacisk na wydajne aktualizacje i przetwarzanie przyrostowe.
W praktyce oznacza to trzy rzeczy, które zarząd zrozumie bez znajomości technologii:
- Jedna kopia danych. Raport, analityk w notatniku i agent AI czytają tę samą tabelę, a nie trzy eksporty z różnych dni.
- Historia stanów. Migawka pozwala sprawdzić, jak wyglądała tabela w dniu, w którym model przygotował odpowiedź.
- Wymienialny silnik. Dane w otwartym formacie przeczyta inny silnik. Zmiana narzędzia nie wymaga migracji danych.
Po co lakehouse w projektach AI
AI nie potrzebuje lakehouse. AI potrzebuje danych, którym można ufać — a lakehouse jest jednym ze sposobów, żeby je mieć, gdy danych jest dużo.
Jedno źródło prawdy dla ludzi i modeli. Najczęstszy problem projektów AI to nie model, tylko pytanie „które dane są właściwe?”. Gdy sprzedaż, finanse i agent obsługi klienta korzystają z różnych kopii, każdy dostaje inną odpowiedź. Lakehouse z katalogiem i właścicielem każdej tabeli daje wspólny punkt odniesienia.
Dane dla RAG i agentów. System RAG wyszukuje fragmenty dokumentów i dołącza je do pytania. Coraz częściej musi łączyć dokumenty z danymi z systemów firmy: stanem zamówień, historią klienta, parametrami produktu. Lakehouse jest dobrym miejscem na tę drugą część. Jak działa samo wyszukiwanie, opisuje poradnik o RAG i danych firmy w AI.
Powtarzalność i ślad. Gdy model trenuje się albo ocenia na danych z lakehouse, migawka zapisuje dokładny stan zbioru. Po pół roku można odtworzyć, na czym model się uczył. Przy pytaniach audytora albo klienta to różnica między „chyba na danych z marca” a konkretnym identyfikatorem migawki.
Wiele rodzajów danych. Tabele z ERP, logi aplikacji, zdarzenia z czujników, pliki PDF. Hurtownia przyjmie tylko część. Magazyn obiektowy przyjmie wszystko, a format tabel uporządkuje to, co ma być tabelą.
Sześć warstw lakehouse od magazynu do AI
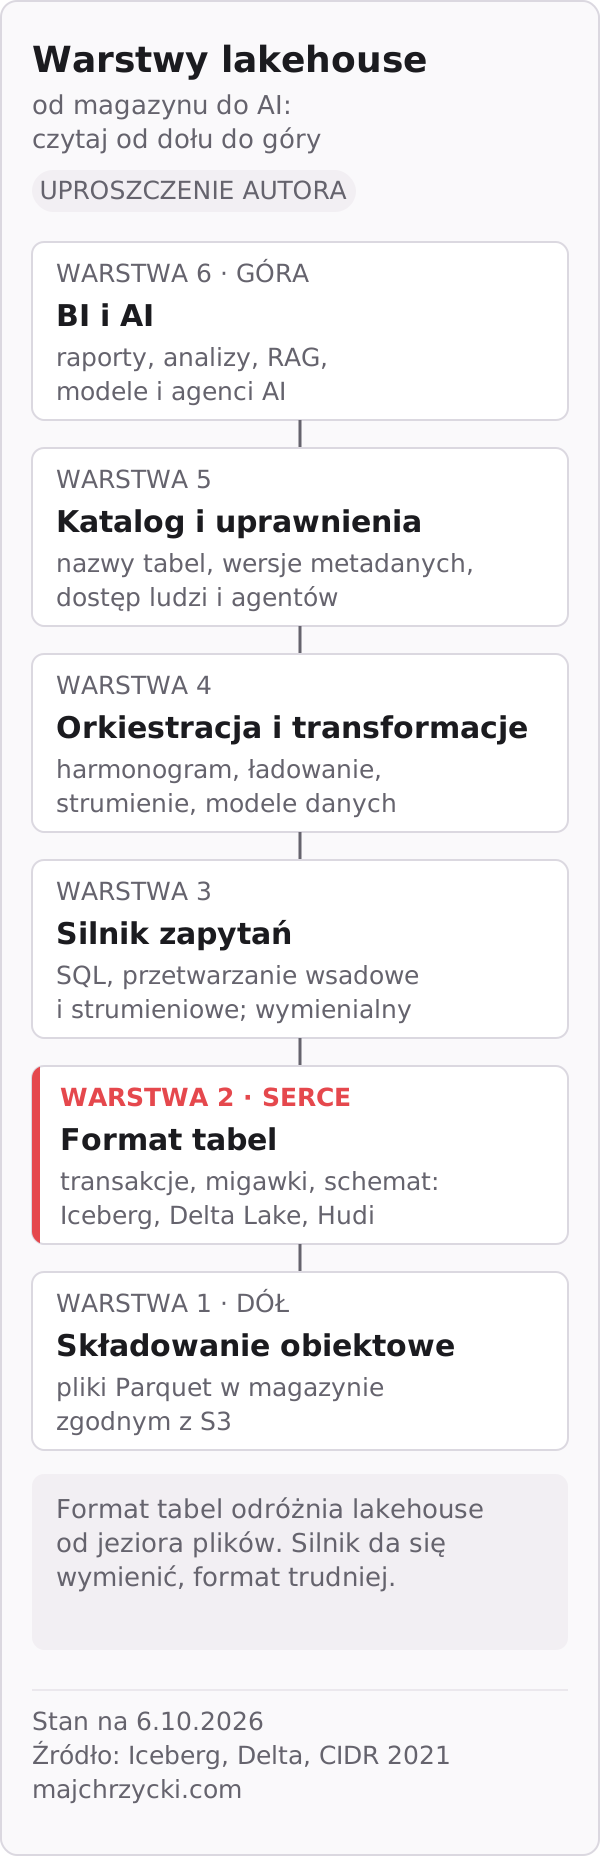
Poniższy podział to uproszczenie autora. Czyta się go od dołu do góry: każda warstwa korzysta z tej pod nią i da się ją wymienić, jeśli rozmawia z sąsiednimi przez otwarty standard.
| Warstwa | Rola | Przykłady z serii | Pytanie dla zarządu |
|---|---|---|---|
| 1. Składowanie obiektowe | pliki danych w magazynie zgodnym z S3 | Apache Ozone, magazyny chmurowe, Apache Parquet jako format plików | gdzie fizycznie leżą dane i kto ma klucze? |
| 2. Format tabel | transakcje, migawki, schemat nad plikami | Apache Iceberg, PyIceberg, Delta Lake, Apache Hudi | czy dane zostają w otwartym formacie? |
| 3. Silnik zapytań i przetwarzania | SQL, obliczenia, przetwarzanie wsadowe i strumieniowe | Apache Spark, Trino, DataFusion, Dremio, DuckDB, Apache Flink | czy silnik da się wymienić bez migracji danych? |
| 4. Orkiestracja i transformacje | harmonogram zadań, ładowanie, modele danych | Apache Airflow, Apache Hop, dbt Core, SQLMesh, Kafka, Debezium | kto odpowiada za to, że dane są świeże? |
| 5. Katalog i uprawnienia | nazwy tabel, wersje metadanych, dostęp | Apache Polaris, Lakekeeper, Unity Catalog | kto widzi które tabele, także agent AI? |
| 6. BI i AI | raporty, analizy, modele, agenci | Apache Superset, ClickHouse, StarRocks, RAG, agenci | kto używa danych i do jakiej decyzji? |
Składowanie i format tabel
Na dole leżą pliki, zwykle w formacie kolumnowym Apache Parquet, w magazynie obiektowym zgodnym z protokołem S3. Może to być usługa chmurowa albo magazyn uruchomiony u siebie, na przykład Apache Ozone, który projekt opisuje jako skalowalny, rozproszony magazyn z natywną obsługą S3.
Nad plikami działa format tabel. To najważniejsza decyzja w całym stosie, bo od niej zależy, które silniki przeczytają dane za pięć lat. Delta Lake jest projektem w ramach Linux Foundation, a funkcja UniForm pozwala czytać tabele Delta klientami Iceberg i Hudi. Iceberg i Hudi rozwija Apache Software Foundation.
Silnik zapytań i przetwarzania
Silnik wykonuje obliczenia, ale nie posiada danych. Apache Spark przetwarza duże zbiory wsadowo i strumieniowo. Trino to rozproszony silnik SQL do analityki — dokumentacja projektu wprost zastrzega, że nie jest bazą ogólnego przeznaczenia ani zamiennikiem PostgreSQL. DuckDB działa wewnątrz procesu aplikacji, bez serwera, i czyta pliki Parquet; dobrze sprawdza się na laptopie analityka i w małych zadaniach.
Orkiestracja i transformacje
Dane trzeba regularnie ładować, czyścić i przeliczać. Apache Airflow według dokumentacji służy do tworzenia, harmonogramowania i monitorowania przepływów pracy — od wsadów danych po zadania modeli i agentów. dbt Core i SQLMesh opisują transformacje jako kod SQL z testami. Apache Kafka i Debezium przenoszą zmiany z systemów źródłowych na bieżąco, a Apache Flink przetwarza strumienie zdarzeń.
Katalog i uprawnienia
Katalog mówi silnikom, gdzie leży aktualna wersja tabeli, i coraz częściej pilnuje dostępu. Apache Polaris implementuje REST API Iceberg, więc Spark, Trino i Flink korzystają z tych samych tabel. Unity Catalog w wersji open source obsługuje Delta Lake i Iceberg.
Tu jest najczęstsza luka. Uprawnienia w katalogu nie pomogą, jeśli ktoś — albo agent AI z szerokim kluczem — sięgnie bezpośrednio do plików w magazynie. Prawa do magazynu i do katalogu trzeba projektować razem.
Stan projektów na 6.10.2026
| Projekt | Rola | Najnowsze wydanie (data) | Licencja |
|---|---|---|---|
| Apache Iceberg | format tabel | 1.12.0 (30.09.2026) | Apache 2.0 |
| Delta Lake | format tabel | 4.4.1 (5.10.2026) | Apache 2.0 |
| Apache Hudi | format tabel | 1.2.1 (24.09.2026) | Apache 2.0 |
| Apache Spark | przetwarzanie | 4.2.0 (14.07.2026) | Apache 2.0 |
| Trino | silnik SQL | 483 (18.07.2026) | Apache 2.0 |
| Apache Kafka | strumienie zdarzeń | 4.3.1 (25.06.2026) | Apache 2.0 |
| Apache Flink | przetwarzanie strumieni | 2.3.0 (25.06.2026) | Apache 2.0 |
| Apache Airflow | orkiestracja | 3.3.2 (17.09.2026) | Apache 2.0 |
| DuckDB | analityka lokalna | 1.5.6 (28.09.2026) | MIT |
Rytm wydań jest szybki: Kafka deklaruje trzy wydania rocznie, a poprawki trafiają tylko do wspieranych wersji. Aktualizacja silników to stała praca w kalendarzu, nie projekt raz na kilka lat.
Otwarte formaty a Microsoft Fabric, Databricks i Snowflake
Lakehouse nie musi oznaczać budowania wszystkiego samemu. Duzi vendorzy oferują go jako usługę, a otwarte formaty tabel stały się wspólnym językiem między nimi.
| Platforma | Rola w lakehouse (z dokumentacji vendora) |
|---|---|
| Microsoft Fabric / OneLake | OneLake to jedno jezioro danych na dzierżawę Fabric; tabele w formacie Delta Parquet albo Iceberg, skróty do danych w ADLS, S3 i źródłach zgodnych z Iceberg, wirtualizacja metadanych między Delta i Iceberg |
| Databricks | lakehouse na Delta Lake z governance w Unity Catalog |
| Snowflake | tabele Apache Iceberg z plikami w magazynie Snowflake albo w chmurze klienta; katalogiem może być Snowflake albo katalog zewnętrzny |
Wspólny wniosek: format danych jest coraz częściej otwarty, ale silnik, uprawnienia i rozliczenie należą do platformy. To dobra wiadomość dla planu wyjścia — dane w Delta albo Iceberg przeczyta inny silnik — i ostrzeżenie dla zarządu. Otwarty format nie przenosi automatycznie uprawnień, modeli semantycznych, raportów ani zadań orkiestracji. To też trzeba umieć odtworzyć.
Jak w tym układzie wygląda Microsoft Fabric — koszt, licencje i wyjście z platformy — opisuje poradnik o Microsoft Fabric dla firm. Otwarty stos z tej serii i usługa vendora nie wykluczają się: częsty układ to dane w otwartym formacie w magazynie firmy, a silnik i raporty w chmurze.
Lakehouse, hurtownia czy baza?
Uczciwie: firma od 50 osób rzadko zaczyna od lakehouse. Najpierw warto sprawdzić, czy nie wystarczy coś prostszego.
| Sygnał | Baza danych (np. PostgreSQL) | Hurtownia lub platforma vendora | Lakehouse na otwartych formatach |
|---|---|---|---|
| Dane | z kilku systemów, mieszczą się w jednej bazie | uporządkowane tabele do raportów | dużo danych różnego rodzaju: tabele, logi, pliki, zdarzenia |
| Narzędzia | jedna aplikacja i raporty | jeden ekosystem, np. Microsoft | kilka silników na tych samych danych |
| Zespół | zna SQL, brak inżyniera danych | brak ludzi do utrzymania infrastruktury | jest zespół albo partner od inżynierii danych |
| Kontrola | dane w bazie u Was albo w usłudze | akceptujecie format i rozliczenie vendora | dane mają zostać w otwartym formacie, pod kontrolą firmy |
| AI | RAG i agenci na danych z jednej bazy | AI w ekosystemie vendora | modele i agenci na wspólnym, wersjonowanym źródle |
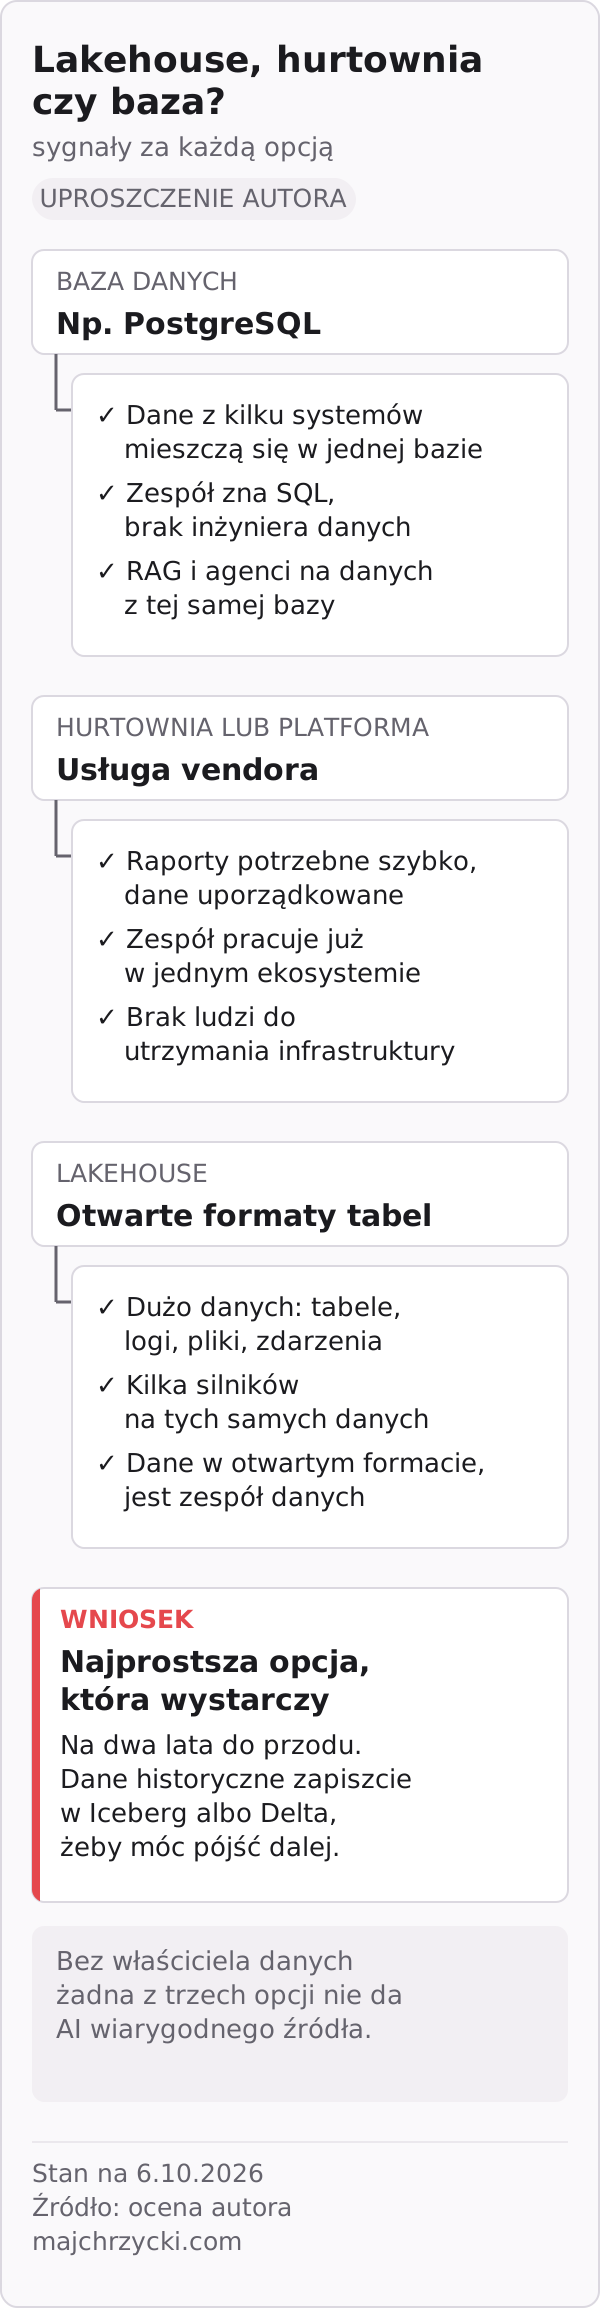
Kiedy zwykła baza wystarczy i gdzie kończą się jej możliwości, opisuje poradnik o PostgreSQL jako bazie pod AI. Zasada praktyczna: wybierzcie najprostszą opcję, która obsłuży dane na najbliższe dwa lata, i zapiszcie dane w formacie, który pozwoli pójść dalej. Tabela Iceberg albo Delta w magazynie obiektowym jest dobrym miejscem na dane historyczne nawet wtedy, gdy codzienna praca odbywa się w bazie.
Ryzyka i koszty utrzymania
Małe pliki i migawki. Każdy zapis tworzy nowe pliki i nową migawkę. Bez regularnego kompaktowania i usuwania starych migawek zapytania zwalniają, a magazyn rośnie. To zadanie, które ktoś musi zaplanować i monitorować.
Katalog jako pojedynczy punkt. Gdy katalog nie działa, silniki nie wiedzą, gdzie są tabele. Katalog wymaga kopii, aktualizacji i planu odtworzenia jak każda baza.
Uprawnienia na dwóch poziomach. Katalog może mieć świetne role, ale jeśli klucz do magazynu ma szeroki dostęp, ominie je każdy program — w tym agent AI. Agent kodujący z dostępem administratora chętnie „naprawi” wolne zapytanie, przepisując pół jeziora. Będzie przy tym bardzo uprzejmy i bardzo pewny siebie, więc klucze do magazynu zostawcie ludziom i usługom z wąskimi rolami.
Kompetencje. Format tabel, silnik, orkiestracja i katalog to cztery różne systemy z własnymi wydaniami. Firma od 50 osób rzadko ma do nich pełny zespół. Realne opcje to partner z umową utrzymaniową, usługa vendora dla części warstw albo ograniczenie stosu do minimum: magazyn, jeden format, jeden silnik, jeden katalog.
Zgodność formatów. „Obsługuje Iceberg” w materiałach vendora może oznaczać odczyt bez zapisu albo tylko część funkcji. Sprawdźcie to na własnych tabelach, zanim od tego uzależnicie architekturę.
Jak zacząć: jedno źródło, jeden format, jeden właściciel
Krok 1. Nazwijcie dane, na których ma pracować AI. Które tabele i dokumenty są potrzebne do pierwszego zastosowania, z jakich systemów pochodzą i kto jest ich właścicielem. Jeśli to trzy systemy i jedna baza wystarczy — nie budujcie lakehouse.
Krok 2. Wybierzcie format i katalog. Gdy lakehouse ma sens, najpierw decydujcie o formacie tabel i katalogu, dopiero potem o silniku. W ekosystemie Microsoft punktem wyjścia jest OneLake; na otwartym stosie — Iceberg z katalogiem REST albo Delta Lake.
Krok 3. Pilot na jednym przepływie danych. Jedno źródło, ładowanie do tabeli, transformacja, raport i jedno zastosowanie AI na tych samych danych. Zapiszcie tabelę jednym silnikiem, odczytajcie drugim, zmieńcie schemat i odtwórzcie poprzednią migawkę. Osobno sprawdźcie, czy użytkownik bez uprawnień nie sięgnie do plików w magazynie.
Krok 4. Zapiszcie właściciela i plan utrzymania. Kto kompaktuje pliki, kto aktualizuje silniki, jak długo trzymacie migawki, jak odtworzycie katalog po awarii. Dopiero z tą kartą decydujcie o skali.
Jeśli po kroku 1 nie wiecie, które dane są wspólnym źródłem prawdy, albo nikt w firmie nie chce być ich właścicielem, problem nie leży w wyborze Iceberg czy Delta. Wtedy pomaga rozmowa zarządu o danych, procesach i odpowiedzialności. Na tym polega prezentacja dla zarządu: nazwiemy dane, ich miejsce i właścicieli, niezależnie od vendora i partnera.
Mapa wpisów o lakehouse i inżynierii danych open source
Wszystkie wpisy serii o lakehouse, przetwarzaniu i analityce danych na otwartym stosie, pogrupowane według warstw z tego poradnika. Zacznijcie od formatów tabel i katalogów — to decyzje, które najtrudniej zmienić.
1. Składowanie i format plików
2. Formaty tabel
- Apache Iceberg: fundament suwerennego lakehouse
- PyIceberg w suwerennym AI OS
- Delta Lake w suwerennym AI OS
3. Katalogi i uprawnienia
4. Silniki zapytań i przetwarzania
- Apache Spark w suwerennym AI OS
- Trino w suwerennym AI OS
- Apache DataFusion w suwerennym AI OS
- DataFusion Comet w suwerennym AI OS
- Daft w suwerennym AI OS
- Dremio OSS w suwerennym AI OS
- Databend w suwerennym AI OS
5. Strumienie i przechwytywanie zmian
6. Orkiestracja i transformacje
- Apache Airflow w suwerennym AI OS
- Apache Hop w suwerennym AI OS
- Celery w suwerennym AI OS
- dbt Core w suwerennym AI OS
- SQLMesh w suwerennym AI OS
7. Analityka, hurtownie i BI
- DuckDB w suwerennym AI OS
- ClickHouse w suwerennym AI OS
- StarRocks w suwerennym AI OS
- Apache Doris w suwerennym AI OS
- Apache Druid w suwerennym AI OS
- WarehousePG w suwerennym AI OS
- PostgresML w suwerennym AI OS
- Apache Superset w suwerennym AI OS
Powiązane: magazyny obiektowe, metadane i hurtownie vendorów
- SeaweedFS w suwerennym AI OS
- RustFS w suwerennym AI OS
- DataHub w suwerennym AI OS
- OpenMetadata w suwerennym AI OS
- OpenLineage w suwerennym AI OS
- Snowflake w suwerennym AI OS
- BigQuery w suwerennym AI OS
- Amazon Redshift w suwerennym AI OS
Najważniejsze w skrócie
- Lakehouse to jezioro danych z formatem tabel, który dodaje transakcje, migawki i schemat.
- Format tabel (Iceberg, Delta Lake, Hudi) jest najważniejszą decyzją; silnik da się wymienić, format trudniej.
- Pod AI lakehouse daje jedno, wersjonowane źródło danych dla raportów, RAG, modeli i agentów.
- Fabric, Databricks i Snowflake korzystają z otwartych formatów, ale silnik, uprawnienia i rozliczenie zostają na platformie.
- Firma od 50 osób zwykle zaczyna od bazy albo hurtowni; lakehouse ma sens przy wielu źródłach, silnikach i rodzajach danych.
- Uprawnienia projektuje się na katalogu i na magazynie jednocześnie, a każda warstwa potrzebuje właściciela.
- Dane i analityka
- Open Source AI
- Lakehouse
- Zarząd