Apache Parquet: dlaczego raport czyta dwie kolumny, a nie całą tabelę — i co to robi z fakturą za chmurę
Temat: Open Source AI
Parquet obniża koszt analityki w chmurze jednym ruchem: układa dane kolumnowo i zapisuje przy każdej grupie wierszy statystyki, dzięki czemu silnik czyta tylko kolumny, o które pyta, i tylko fragmenty, w których odpowiedź może być. Reszta pliku nie jest nawet pobierana — a w chmurze płaci się za pobrane bajty i czas pracy silnika. Dlatego Parquet jest domyślnym nośnikiem danych w Delta Lake, Apache Iceberg, Apache Hudi i Apache Paimon, czyta go każdy liczący się silnik, a najwięcej zyskują na nim raporty i modele, które pytają o kilka kolumn z milionów wierszy.
Ten profil rozkłada plik Parquet na części, pokazuje, które ustawienia naprawdę wpływają na koszt skanowania, i gdzie Parquet przestaje być dobrym wyborem. Piszemy go dla inżyniera danych, osoby odpowiedzialnej za koszty chmury i analityka BI, który chce rozumieć, za co płaci. Pojęcia formatu pliku (data format) i formatu tabeli (table format) porządkuje poradnik o formatach plików i tabel; miejsce Parquet w całym stosie od magazynu obiektowego po BI opisuje poradnik o lakehouse dla firm.
Co dziś nie działa
— Faktura za silnik zapytań urosła o połowę. Co się stało? — Dodaliśmy jeden dashboard dla handlowców. — Jeden dashboard? — Odświeża się co pięć minut i za każdym razem czyta całą historię sprzedaży z CSV. (Historia sprzedaży ma czterdzieści kolumn. Dashboard pokazuje trzy.)
Większość firm, które zaczynają analitykę w chmurze, przenosi tam dane w tej postaci, w jakiej je miała: eksporty CSV, kopie tabel z bazy, czasem JSON z systemów internetowych. Działa — do pierwszej faktury, która rośnie szybciej niż liczba raportów. Przyczyna jest prosta: format wierszowy zmusza silnik do przeczytania całego rekordu, żeby wyjąć z niego jedną wartość. Czterdzieści kolumn, czytane dla trzech, to trzynaście razy więcej bajtów, niż potrzeba. W chmurze te bajty mają cennik.
Architektura wewnętrzna: jak zbudowany jest plik
Dokumentacja Parquet opisuje plik jako hierarchię z trzech poziomów, zakończoną stopką.
Grupa wierszy (row group). Plik dzieli się poziomo na grupy wierszy — zwykle od kilkudziesięciu do kilkuset megabajtów każda. Grupa to jednostka, którą silnik może pominąć w całości, jeśli statystyki mówią, że szukanej wartości tam nie ma.
Kawałek kolumny (column chunk). W każdej grupie wierszy dane jednej kolumny leżą razem, obok siebie. To jest serce układu kolumnowego: zapytanie o kolumnę kwota czyta kawałki kolumny kwota i nie dotyka pozostałych trzydziestu dziewięciu.
Strona (page). Kawałek kolumny składa się ze stron — najmniejszych jednostek kodowania i kompresji. Strona słownikowa (dictionary page) trzyma listę unikalnych wartości, strony danych trzymają odwołania do słownika.
Stopka (footer). Na końcu pliku leżą metadane: schemat, położenie każdej grupy i kolumny, statystyki (minimum, maksimum, liczba wartości pustych), a także wskaźniki do indeksu stron i filtrów Blooma. Plik kończy się czterobajtową długością stopki i magicznym ciągiem PAR1. Silnik czyta najpierw stopkę, a dopiero potem decyduje, które fragmenty pobrać.
| Poziom | Co zawiera | Co pozwala pominąć |
|---|---|---|
| Plik | grupy wierszy + stopka | cały plik, jeśli statystyki w stopce wykluczają wartość |
| Grupa wierszy | kawałek każdej kolumny | całą grupę po statystykach min/max |
| Kawałek kolumny | strony jednej kolumny | kolumny, o które zapytanie nie pyta |
| Strona | zakodowane wartości | pojedyncze strony po indeksie stron |
Kodowania i kompresja
Parquet oszczędza bajty w dwóch krokach. Najpierw kodowanie (encoding) wykorzystuje powtarzalność w kolumnie: kodowanie słownikowe (RLE_DICTIONARY) zapisuje każdą unikalną wartość raz i zastępuje ją numerem; kodowanie długości serii (RLE) i upakowanie bitowe skracają ciągi powtórzeń i małe liczby; kodowania delta (DELTA_BINARY_PACKED dla liczb całkowitych, DELTA_BYTE_ARRAY dla tekstów ze wspólnymi prefiksami) zapisują różnice zamiast wartości; BYTE_STREAM_SPLIT pomaga przy liczbach zmiennoprzecinkowych. Lista kodowań jest w dokumentacji. Dopiero potem kodek kompresji ściska całą stronę: według dokumentacji kodeków dostępne są między innymi SNAPPY, GZIP, ZSTD, BROTLI i LZ4_RAW (starsze LZ4 w ramce Hadoop jest przestarzałe). Snappy jest szybki, ZSTD daje mniejsze pliki za cenę procesora.
Statystyki, indeks stron, filtry Blooma
Trzy mechanizmy pozwalają silnikowi nie czytać tego, czego nie potrzebuje:
- Statystyki min/max/null przy każdym kawałku kolumny — jeśli zapytanie filtruje
data = '2026-09', a w grupie wierszy daty są od stycznia do marca, grupa jest pomijana. - Indeks stron (page index): ColumnIndex ze statystykami na stronę i OffsetIndex z położeniem stron — pozwala pominąć strony wewnątrz grupy.
- Filtry Blooma (bloom filter): dla kolumn o wielu unikalnych wartościach (numer zamówienia, identyfikator klienta), gdzie min/max nic nie mówi, filtr odpowiada „tej wartości tu na pewno nie ma” bez czytania danych.
Wszystkie trzy działają najlepiej, gdy dane są posortowane po kolumnie, po której najczęściej filtrujecie. Posortowana kolumna data daje wąskie zakresy min/max; nieposortowana daje w każdej grupie zakres „od stycznia do grudnia” — i nic nie zostaje pominięte. To jest ustawienie, które wpływa na koszt bardziej niż wybór kodeka, a jest decyzją właściciela tabeli, nie formatu.
Typy logiczne i rozwój specyfikacji
Specyfikacja formatu rozwija się nadal: wersja 2.11 (marzec 2025) wprowadziła typ VARIANT dla danych półstrukturalnych oraz typy GEOMETRY i GEOGRAPHY, 2.12 sfinalizowała VARIANT i jego rozbijanie na kolumny (shredding), a 2.14 z września 2026 dodała typ logiczny FILE i kodowanie ALP w wersji zapoznawczej (stan według bloga projektu i listy wydań, sprawdzono 21.10.2026). Dla firmy znaczy to jedno: jeśli planujecie trzymać w Parquet dane z JSON-ów (VARIANT) albo współrzędne (GEOMETRY), sprawdźcie, czy Wasz silnik czyta już te typy — specyfikacja wyprzedza implementacje.
Unikalne cechy — tabela
| Cecha | Co daje | Warunek |
|---|---|---|
| Przycinanie kolumn (projection pushdown) | odczyt tylko potrzebnych kolumn | zapytanie wymienia kolumny, nie SELECT * |
| Przycinanie po statystykach (predicate pushdown) | pomijanie grup i stron | dane posortowane po kolumnie filtru |
| Kompresja słownikowa | małe pliki dla kolumn o małej liczbie wartości | kolumny kategorii, statusów, nazw |
| Zgodność silników | Spark, Trino, DuckDB, Polars, pandas/Arrow, Snowflake, BigQuery, Fabric | brak — Parquet czytają wszystkie |
| Zagnieżdżone struktury | listy i mapy w jednej kolumnie | świadomy projekt schematu |
| Niezmienność pliku | podstawa transakcji w formatach tabel | zmiana = nowy plik + nowe metadane |
Ostatni wiersz tłumaczy, dlaczego Parquet nie jest bazą danych i nie próbuje być: raz zapisany plik nikt nie edytuje. Dzięki temu Delta Lake, Iceberg, Hudi i Paimon mogą zbudować nad plikami transakcje — wiedzą, że plik, który wczoraj opisały, dziś wygląda tak samo.
Przykład dydaktyczny: raport marży po kanałach
To przykład ilustracyjny, nie studium klienta — pokazuje mechanizm na typowej firmie, nie opisuje konkretnego wdrożenia.
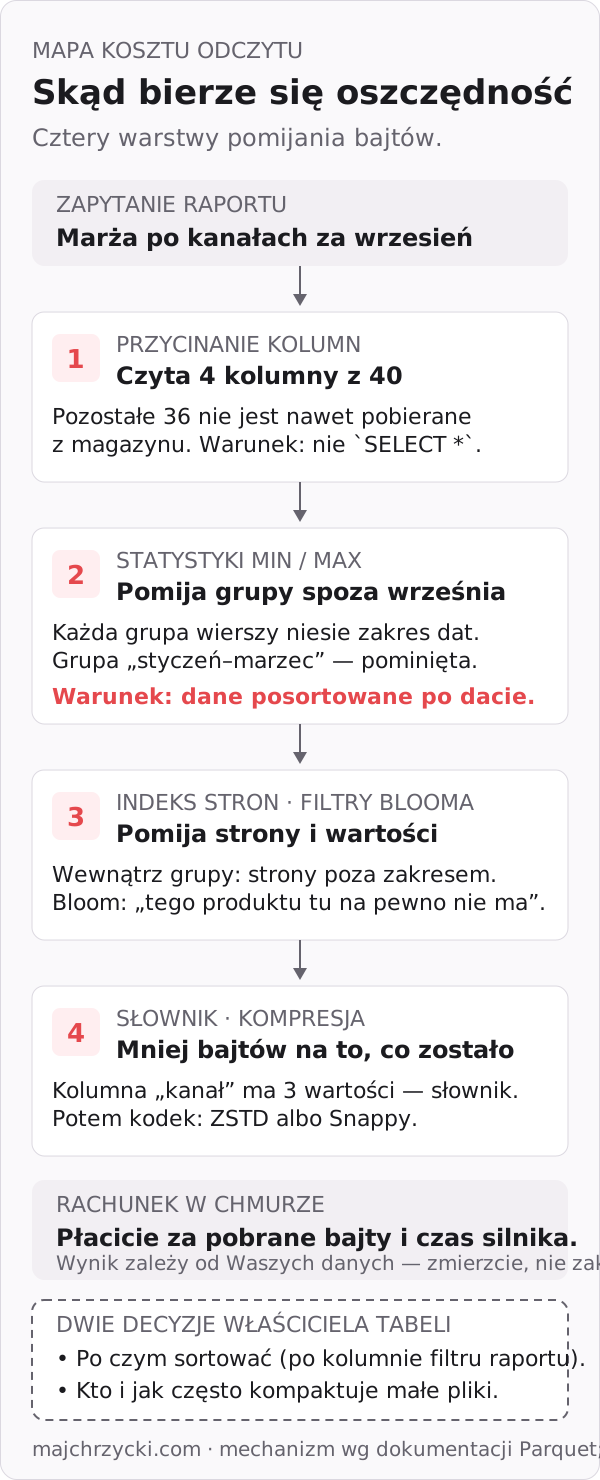
Firma handlowa, około 120 osób, sprzedaje przez sklep własny, marketplace i hurt. Historia transakcji z trzech kanałów to kilkadziesiąt milionów wierszy po czterdzieści kolumn, składowana jako nocne eksporty CSV w magazynie obiektowym. Raport marży po kanałach i grupach produktów, który zarząd czyta co tydzień, a handlowcy odświeżają co kilka minut, filtruje po dacie i kanale, a sumuje przychód i koszt — cztery kolumny z czterdziestu.
Stan przed. Każde odświeżenie czyta wszystkie pliki CSV za wybrany okres w całości: czterdzieści kolumn, żadnych statystyk, żadnego pomijania. Koszt rośnie liniowo z liczbą odświeżeń i z długością historii.
Co robi system po zmianie. Dane trafiają do tabeli w formacie tabeli, której pliki są w Parquet, posortowane po dacie i kanale, z kompresją ZSTD i filtrem Blooma na identyfikatorze produktu. Silnik czyta stopki, pomija grupy wierszy spoza zakresu dat, pobiera cztery kolumny zamiast czterdziestu i korzysta ze słownika dla kolumny kanał, która ma trzy wartości.
Co zostaje przy człowieku. Decyzja, po czym sortować (data i kanał, bo po tym filtruje raport), ile historii trzymać w „gorącej” warstwie, kto jest właścicielem tabeli i kto uruchamia kompaktowanie, gdy nocne ładowania zostawią małe pliki. Format daje narzędzia; projekt tabeli jest pracą ludzi.
Czym to zmierzyć. Załóżmy, że dziś jedno odświeżenie raportu skanuje całą historię za kwartał. Po zmianie mierzycie bajty skanowane na odświeżenie (silniki podają tę liczbę w planie zapytania), czas odpowiedzi, miesięczny koszt silnika przypisany do raportu i liczbę kopii historii sprzedaży w firmie. Mechanizm mówi, że bajty spadną w stopniu zbliżonym do stosunku czytanych kolumn do wszystkich i do odsetka pomijanych grup — ale konkretny wynik zależy od Waszych danych, więc zmierzcie go sami, zanim wpiszecie do prezentacji. Źródłem modelu kosztów jest cennik Waszej platformy, nie ten tekst.
Gdzie Parquet przestaje być dobrym wyborem
Zapis pojedynczych rekordów. Strumień, który co minutę dopisuje kilkaset zdarzeń do nowego pliku, tworzy problem małych plików: tysiące plików po kilkadziesiąt kilobajtów, każdy z własną stopką. Silnik otwiera pliki zamiast czytać dane. Rozwiązanie to kompaktowanie przez format tabeli — albo Avro w strumieniu i Parquet dopiero w tabeli, jak opisujemy w porównaniu Parquet i Avro.
Odczyt całych rekordów po kluczu. „Pokaż mi zamówienie numer 48213” to zadanie dla bazy danych albo dla formatu wierszowego. Parquet musi złożyć wiersz z czterdziestu kolumn — da się, ale to nie jest jego mocna strona.
Brak transakcji. Dwa procesy piszące jednocześnie do tego samego katalogu plików Parquet nie mają żadnej ochrony. Potrzebny jest format tabeli — Parquet sam w sobie nie wie, czy jest częścią tabeli.
Parametry do dobrania. Rozmiar grupy wierszy, rozmiar strony, próg słownika, kodek — domyślne wartości są rozsądne, ale nie są dopasowane do Waszych danych. Tabela z milionem unikalnych identyfikatorów i tabela z pięcioma statusami powinny być zapisane inaczej.
Po czym poznać wartość
| Miernik wyniku | Miernik próżności |
|---|---|
| Bajty skanowane na jedno odświeżenie raportu | Terabajty w magazynie |
| Czas odpowiedzi dziesięciu najczęstszych zapytań | Liczba plików Parquet |
| Miesięczny koszt silnika przypisany do raportu | Stopień kompresji w procentach |
| Liczba kopii tych samych danych (eksporty, arkusze) | Liczba kolumn w tabeli |
Uczciwie: na koszt wpływa też to, jak napisane są zapytania (SELECT * niweczy przycinanie kolumn), jak zaprojektowane partycje i czy ktoś pilnuje kompaktowania. Parquet daje możliwość oszczędności; zapytanie i projekt tabeli decydują, czy z niej skorzystacie.
Pierwszy krok w poniedziałek
- Wybierzcie jeden raport, którego koszt lub czas odświeżenia najbardziej Was boli.
- Odczytajcie w planie zapytania, ile bajtów skanuje dziś. Zapiszcie.
- Zapiszcie dane tego raportu do Parquet posortowane po kolumnie, po której raport filtruje, z kodekiem ZSTD.
- Zmierzcie ponownie bajty i czas. Porównajcie. To jest Wasz pierwszy argument oparty na własnych danych.
Jeśli zapytanie raportu zaczyna się od SELECT *, poprawcie je najpierw — żaden format nie pomoże zapytaniu, które prosi o wszystko.
Co sprawdzić przed decyzją
- Wersję biblioteki, którą piszecie i czytacie pliki (parquet-java 1.18.x, Arrow), i wersję specyfikacji, którą obsługuje (wydania parquet-java, sprawdzono 21.10.2026).
- Które typy logiczne (VARIANT, GEOMETRY) czyta już Wasz silnik, jeśli ich potrzebujecie.
- Domyślny kodek i rozmiar grupy wierszy w Waszym narzędziu zapisu.
- Rozmiar plików po kompaktowaniu i kto odpowiada za jego uruchamianie.
- Z jakim formatem tabeli Parquet ma pracować — Apache Iceberg, Delta Lake, Apache Hudi czy Apache Paimon; każdy z nich ma w tej serii własny profil.
Najważniejsze w skrócie
- Parquet układa dane kolumnowo w hierarchii plik → grupa wierszy → kawałek kolumny → strona, ze stopką metadanych na końcu.
- Oszczędność bierze się z czterech warstw pomijania: przycinanie kolumn, statystyki min/max, indeks stron i filtry Blooma, kodowanie słownikowe i kompresja.
- Sortowanie po kolumnie filtru wpływa na koszt bardziej niż wybór kodeka — i jest decyzją właściciela tabeli.
- Parquet nie daje transakcji ani zapisu pojedynczych rekordów; tabelę robi z niego format tabeli, strumień obsługuje Avro.
- Mierzcie bajty na raport i koszt silnika, nie terabajty i liczbę plików.
- Dane i analityka
- Open Source AI
- Lakehouse
- Inżynieria danych
- Koszty chmury
