Parquet czy Avro? Kolumna, kiedy czytacie; wiersz, kiedy piszecie
Temat: Open Source AI
Parquet i Avro nie konkurują ze sobą — odpowiadają na dwa różne pytania i w dobrze zaprojektowanej firmie zwykle występują razem. Avro przenosi zdarzenie z systemu magazynowego do Kafki tak, żeby nikt po drodze nie zgubił pola; Parquet układa milion takich zdarzeń tak, żeby raport marży przeczytał z nich dwie kolumny i zapłacił za dwie kolumny. Spór „który lepszy” wraca w zespołach danych co kilka miesięcy i prawie zawsze kończy się tą samą odpowiedzią: to zależy od tego, czy dane w tej chwili płyną, czy leżą.
Ten tekst pokazuje, jak rozpoznać ten moment, co się dzieje z kosztem i wydajnością po obu stronach i gdzie najczęściej psuje się przejście z jednego formatu do drugiego. Piszemy go dla architekta integracji, inżyniera danych i menedżera, który odpowiada za raportowanie w firmie z ERP, WMS i sklepem internetowym — i który właśnie zaczyna gromadzić zdarzenia zamiast nocnych eksportów. Pojęcia formatu pliku (data format) i formatu tabeli (table format), na których tu stoimy, porządkuje poradnik o formatach plików i tabel.
Co dziś nie działa
— Raport sprzedaży nie zgadza się z WMS-em o czterdzieści palet. — Bo w piątek sklep dodał pole „rabat_procent” do eksportu i nasz import przesunął kolumny. — Przesunął kolumny? — CSV nie wie, która kolumna jest która. Liczy po przecinkach. (Pole dodał stażysta. Raport czytał zarząd. Przecinki nie czytały nikogo.)
Większość firm między 50 a 300 osób wymienia dane między systemami w ten sam sposób: ERP eksportuje CSV o 2:00, skrypt importuje go do hurtowni o 4:00, raport odświeża się o 6:00. Ten układ ma dwie słabości, które nie są winą ludzi. Po pierwsze, CSV nie niesie schematu: kolejność kolumn, typ liczby i znaczenie pustego pola są umową ustną między dwoma skryptami. Po drugie, każdy raport czyta cały plik, nawet jeśli potrzebuje dwóch kolumn z trzydziestu — a w chmurze płaci się za przeczytane bajty.
Avro i Parquet rozwiązują te dwa problemy — ale każdy inny. Dlatego zanim porównacie je ze sobą, trzeba zapytać, który problem w tej chwili kosztuje więcej.
Dwa układy bajtów, dwa rachunki
Wyobraźcie sobie jedno zdarzenie: „wydanie z magazynu” z trzydziestoma polami — numer zlecenia, indeks, ilość, lokalizacja, operator, czas, przewoźnik i tak dalej. Dziennie takich zdarzeń powstaje w średniej firmie kilkadziesiąt tysięcy.
Układ wierszowy (Avro) zapisuje każde zdarzenie w całości, pole za polem, jedno po drugim. Zapis jednego rekordu to dopisanie kilkudziesięciu bajtów na koniec bloku. Odczyt jednego rekordu to przeczytanie tych kilkudziesięciu bajtów. Jeśli zadanie brzmi „weź to zdarzenie i przekaż dalej”, nie da się tego zrobić taniej. Specyfikacja Avro opisuje kodowanie binarne bez znaczników pól: pisarz i czytelnik znają schemat, więc w danych nie ma nazw kolumn — tylko wartości.
Układ kolumnowy (Parquet) zapisuje osobno wszystkie numery zleceń, osobno wszystkie ilości, osobno wszystkich operatorów. Zapis pojedynczego zdarzenia nie ma sensu — Parquet zbiera tysiące rekordów w grupę wierszy (row group), a dopiero potem układa je kolumna po kolumnie. Za to odczyt „suma ilości po przewoźniku za wrzesień” dotyka dwóch kolumn z trzydziestu, a dzięki statystykom minimum i maksimum zapisanym przy każdej grupie wierszy silnik omija grupy, w których września nie ma. Dokumentacja Parquet opisuje tę strukturę: plik → grupy wierszy → kawałki kolumn (column chunks) → strony (pages), ze stopką metadanych na końcu.
Kompresja działa na korzyść układu kolumnowego z prostego powodu: wartości w jednej kolumnie są do siebie podobne. Kolumna „przewoźnik” ma pięć różnych wartości na milion wierszy — kodowanie słownikowe (RLE_DICTIONARY) zapisuje pięć nazw i milion małych numerków. Avro też kompresuje (deflate, snappy, zstandard na bloki), ale kompresuje rekordy, w których obok siebie leżą data, tekst i liczba — różne typy, mało powtórzeń.
| Pytanie | Avro (wierszowy) | Parquet (kolumnowy) |
|---|---|---|
| Zapis jednego zdarzenia | tani: dopisanie kilku dziesiątek bajtów | nieopłacalny: plik powstaje z tysięcy rekordów naraz |
| Odczyt całego rekordu | tani: bajty leżą obok siebie | droższy: trzeba złożyć wiersz z wielu kolumn |
| Odczyt dwóch kolumn z miliona wierszy | drogi: czyta się wszystkie trzydzieści pól | tani: czyta się dwie kolumny i pomija grupy po statystykach |
| Kompresja | na bloki rekordów, umiarkowana | słownikowa i RLE po kolumnach, wysoka dla powtarzalnych wartości |
| Gdzie leży schemat | JSON w nagłówku pliku albo w rejestrze schematów | w stopce pliku |
| Kodeki (wg dokumentacji) | null, deflate wymagane; snappy, zstandard, bzip2, xz opcjonalne | SNAPPY, GZIP, ZSTD, BROTLI, LZ4_RAW (LZ4 w ramce Hadoop przestarzałe) |
Nie podajemy tu procentów oszczędności, bo zależą od Waszych danych: liczby unikalnych wartości, długości tekstów, sposobu sortowania. Mechanizm jest jednak ten sam u każdego — i dlatego warto go zmierzyć na własnej tabeli, zanim ktoś pokaże slajd z obietnicą.
Schemat: kto go pilnuje
W pierwszej scence problemem nie był rozmiar pliku, tylko to, że nikt nie wiedział, co znaczy nowa kolumna. Tu drogi obu formatów rozchodzą się najwyraźniej.
Avro traktuje schemat jako umowę. Schemat jest dokumentem JSON: nazwy pól, typy, wartości domyślne. Specyfikacja definiuje reguły rozwiązywania schematu czytelnika i pisarza (reader/writer schema resolution): pola dopasowuje się po nazwie; pole, które pisarz zapisał, a czytelnik go nie zna, jest pomijane; pole, którego czytelnik oczekuje, a pisarz nie zapisał, dostaje wartość domyślną — albo odczyt kończy się błędem, jeśli domyślnej nie ma. Dopuszczone są promocje typów: int na long, long na double, string na bytes i odwrotnie. Gdy rekordy lecą pojedynczo przez Kafkę, schemat nie podróżuje z każdym z nich — podróżuje jego identyfikator. Rejestr schematów (schema registry) trzyma wszystkie wersje i, co ważniejsze, odrzuca zmianę, która łamie zgodność. Według dokumentacji Confluent każdy komunikat zaczyna się bajtem magicznym i czterobajtowym identyfikatorem schematu, a dopiero potem leżą dane Avro. Avro ma też kodowanie pojedynczego obiektu (single-object encoding) z odciskiem schematu w nagłówku — dla przypadków bez rejestru.
Parquet traktuje schemat jako opis pliku. W stopce każdego pliku jest jego schemat — ale to schemat tego jednego pliku. Jeśli w poniedziałek zapisaliście pliki z trzydziestoma kolumnami, a we wtorek z trzydziestoma jedną, Parquet sam z siebie nie wie, czy to ta sama tabela. Tę wiedzę wnosi format tabeli (Delta Lake, Iceberg) albo silnik, który łączy schematy przy odczycie. Dlatego ewolucja schematu w Parquet jest sprawą warstwy wyżej — co nie jest wadą, tylko podziałem ról.
| Zmiana | Avro z rejestrem (zgodność wstecz) | Parquet w formacie tabeli |
|---|---|---|
| Dodanie pola | dozwolone, jeśli ma wartość domyślną | dozwolone; starsze pliki czytane z wartością pustą |
| Usunięcie pola | dozwolone, jeśli czytelnik ma domyślną | dozwolone na poziomie tabeli; pliki zostają |
| Zmiana typu | tylko promocje (int→long, float→double…) | zależnie od formatu tabeli (np. rozszerzanie typów w Delta Lake) |
| Przemianowanie | w Avro to usunięcie i dodanie; aliasy pomagają | po identyfikatorach kolumn w Iceberg; mapowanie kolumn w Delta |
Wniosek dla menedżera: w Avro zmiana schematu jest decyzją między działami, egzekwowaną przez rejestr. W Parquet zmiana schematu jest decyzją właściciela tabeli, egzekwowaną przez format tabeli. W obu przypadkach ktoś musi być tym właścicielem — plik sam się nie obroni.
Przypadki użycia: kiedy który
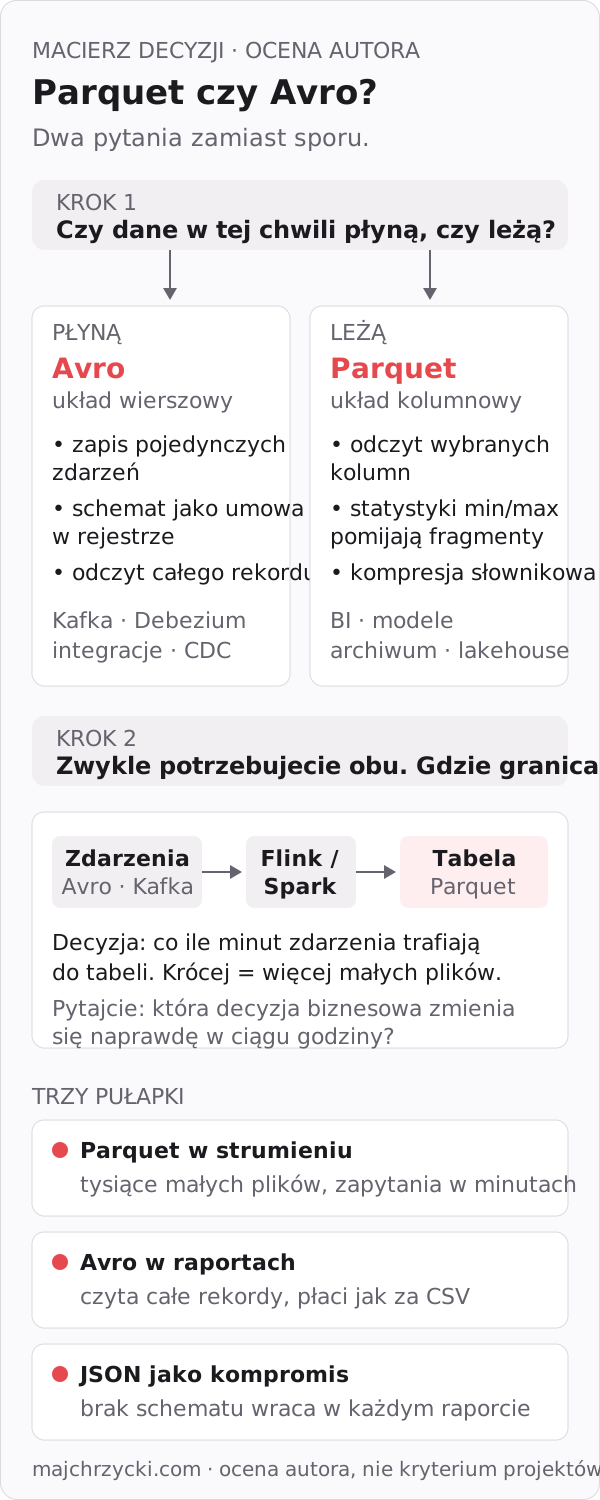
Tabela decyzyjna z trzech pytań — gdzie dane są w tej chwili, kto je czyta i jak często.
| Sytuacja | Format | Dlaczego |
|---|---|---|
| Zdarzenia z ERP, WMS, sklepu płyną przez Kafkę do innych systemów | Avro | zapis pojedynczych rekordów, schemat jako umowa między działami, odczyt całego zdarzenia |
| Integracja między dwiema aplikacjami (zamówienie → faktura) | Avro (albo Protobuf) | rekord w całości, zgodność wersji, mały rozmiar komunikatu |
| Przechwytywanie zmian (Change Data Capture, CDC) z bazy ERP | Avro w strumieniu | Debezium i Kafka Connect zapisują zmiany jako rekordy ze schematem |
| Raporty, BI, analiza marży, agregacje | Parquet | kilka kolumn z milionów wierszy, statystyki, kompresja słownikowa |
| Uczenie modeli, zbiory treningowe, cechy | Parquet | odczyt wybranych kolumn, duże paczki, zgodność z Arrow, pandas, Polars |
| Archiwum historii transakcji | Parquet w formacie tabeli | tanie składowanie, rzadki odczyt analityczny, podróż w czasie dzięki tabeli |
| Dziennik zdarzeń dopisywany i czytany w całości | Avro albo Parquet z dużymi plikami | zależy od tego, czy częściej czytacie pojedyncze zdarzenia, czy agregaty |
Gdzie spotkacie który format u vendorów: Microsoft Fabric przechowuje tabele w OneLake w formacie Delta Parquet (według dokumentacji OneLake); Databricks buduje na Delta Lake, czyli na Parquet; Snowflake czyta tabele Apache Iceberg, których pliki danych to w praktyce Parquet. Avro spotkacie po stronie strumienia: w Kafce, Kafka Connect, Debezium, Flinku — i, co ciekawe, w samym Icebergu, który zapisuje swoje manifesty (listy plików) właśnie w Avro, bo manifest czyta się w całości, rekord po rekordzie.
Gdzie zły wybór zaszkodzi
Cztery sytuacje, które widzieliśmy wystarczająco często, żeby je nazwać.
Parquet w strumieniu. Zadanie, które co minutę zapisuje kilkaset zdarzeń do pliku Parquet, po miesiącu zostawia dziesiątki tysięcy plików po kilkadziesiąt kilobajtów. Każdy ma własną stopkę, własne statystyki i własny koszt otwarcia. Zapytanie, które powinno trwać sekundy, trwa minuty, bo silnik otwiera pliki zamiast czytać dane. To problem małych plików (small files problem) i rozwiązuje go kompaktowanie — czyli zadanie serwisowe, które ktoś musi zaplanować i opłacić.
Avro w analityce. Raport marży na plikach Avro czyta wszystkie trzydzieści pól każdego rekordu, żeby wyciągnąć dwa. Nie ma statystyk do przycinania, nie ma słownika po kolumnach. Działa — tylko kosztuje tyle, co CSV, z tą różnicą, że ma schemat.
„Zmienimy schemat, nikt nie zauważy”. Zmiana niezgodna — usunięcie pola bez wartości domyślnej, zmiana typu z tekstu na liczbę — w Avro z rejestrem zostaje odrzucona przy rejestracji. Bez rejestru albo z polityką zgodności ustawioną na „brak” przechodzi i przewraca konsumentów w sobotę rano. Narzędzie daje możliwość pilnowania umowy; polityka musi ją włączyć.
JSON jako „kompromis”. JSON nie wymaga rejestru, nie wymaga typów, każdy go rozumie — i każdy rozumie go trochę inaczej. Brak schematu nie jest oszczędnością; jest pożyczką, którą spłaca każdy raport i każdy agent AI, który dostaje liczbę jako tekst.
Przejście Avro → Parquet: gdzie postawić granicę
Najczęstszy dobry układ wygląda tak: zdarzenia z systemów źródłowych trafiają do Kafki jako rekordy Avro ze schematem w rejestrze. Zadanie przetwarzające (Flink albo Spark) czyta je, oczyszcza, łączy i zapisuje do tabeli w formacie tabeli — Iceberg, Delta Lake albo Paimon — której pliki danych są w Parquet. Raporty, notatniki i agenci czytają tabelę.
Decyzja do podjęcia to opóźnienie, z jakim zdarzenia mają trafiać do tabeli. Co minutę oznacza małe pliki i częste kompaktowanie. Co godzinę oznacza większe pliki i tańszy odczyt — ale raport „na teraz” będzie miał godzinę opóźnienia. Odpowiedź nie leży w technologii; leży w pytaniu, która decyzja biznesowa naprawdę zmienia się w ciągu godziny. Zwykle jest ich mniej, niż sugeruje dashboard.
Jak Avro pracuje po stronie strumienia i jak zbudować rejestr schematów, który pilnuje umów między działami, rozwija profil Apache Avro. Jak zbudować plik Parquet, który skanuje się tanio, opisuje profil Apache Parquet.
Po czym poznać wartość
Odróżnijcie mierniki wyniku od mierników próżności.
| Miernik wyniku | Miernik próżności |
|---|---|
| Bajty skanowane przez typowy raport przed i po przejściu na Parquet | Liczba plików w jeziorze danych |
| Czas odpowiedzi dziesięciu najczęstszych zapytań zarządu i agentów | Liczba tematów w Kafce |
| Liczba incydentów „zmiana schematu przewróciła import” na kwartał | Liczba zarejestrowanych schematów |
| Czas od zgłoszenia nowego pola do jego obecności w raporcie | Rozmiar klastra |
| Liczba kopii tych samych danych (eksporty, arkusze, kopie dla modelu) | Terabajty w magazynie |
I jedno zastrzeżenie: na żaden z tych mierników nie wpływa sam format. Wpływa jakość danych źródłowych, projekt partycji, dyscyplina kompaktowania i to, czy ktoś jest właścicielem schematu. Format jest warunkiem, nie przyczyną.
Pierwszy krok w poniedziałek
Weźcie jeden strumień zdarzeń i jeden raport, który z niego korzysta — najlepiej ten, który ostatnio pokazał dwie różne liczby.
- Spiszcie schemat zdarzenia w Avro z wartościami domyślnymi dla pól, które mogą być puste. Sam zapis schematu zwykle ujawnia dwa–trzy pola, których nikt nie umie zdefiniować.
- Zarejestrujcie go w rejestrze schematów z polityką zgodności „wstecz” i spróbujcie dodać pole bez wartości domyślnej. Rejestr powinien odmówić.
- Zapiszcie dzienną paczkę zdarzeń do Parquet, posortowaną po kolumnie, po której raport filtruje.
- Zmierzcie bajty skanowane i czas tego samego raportu na CSV i na Parquet. Zapiszcie liczby — to Wasz pierwszy rzeczywisty argument, lepszy niż jakikolwiek slajd.
Jeśli nie potraficie wskazać, kto jest właścicielem schematu zdarzenia i kto jest właścicielem tabeli raportowej, zacznijcie od tego — format nie zastąpi decyzji o odpowiedzialności.
Najważniejsze w skrócie
- Avro i Parquet rozwiązują różne problemy: Avro — zapis i przekazanie pojedynczego zdarzenia z gwarancją schematu; Parquet — tani odczyt analityczny wybranych kolumn z milionów wierszy.
- Układ wierszowy jest tani w zapisie, kolumnowy w odczycie. Kompresja kolumnowa wygrywa, bo wartości w jednej kolumnie są do siebie podobne.
- W Avro schemat jest umową między działami pilnowaną przez rejestr. W Parquet ewolucję schematu prowadzi format tabeli.
- Typowy układ: Avro w Kafce, Parquet w tabeli lakehouse. Decyzja do podjęcia to opóźnienie między jednym a drugim.
- Pułapki: Parquet w strumieniu (małe pliki), Avro w raportach (pełne rekordy), JSON jako kompromis (koszt w każdym raporcie).
- Mierzcie bajty na raport, czas zapytań i liczbę incydentów schematu — nie liczbę plików ani tematów.
- Dane i analityka
- Open Source AI
- Lakehouse
- Inżynieria danych
- Kafka
