Delta Lake, Apache Iceberg czy Apache Hudi? Trzy plany tego samego budynku
Temat: Open Source AI
Trzy formaty tabel dają dziś ten sam zestaw obietnic — transakcje, podróż w czasie, ewolucję schematu, aktualizacje i usunięcia — więc wybór między nimi rzadko zależy od listy funkcji, a prawie zawsze od tego, które silniki i platformy mają je czytać i kto ma prowadzić katalog. Delta Lake jest domyślnym formatem Databricks i Microsoft Fabric. Apache Iceberg stał się wspólnym językiem Snowflake, AWS, Google Cloud i silników otwartych, z katalogiem REST jako punktem styku. Apache Hudi od początku budowano wokół aktualizacji rekordów i przetwarzania przyrostowego, więc najlepiej czuje się tam, gdzie dane zmieniają się bez przerwy. Ten tekst porównuje trzy architektury według tych samych kryteriów — bez ogłaszania zwycięzcy, bo zwycięzcą jest ten format, którego Wasze silniki nie będą musiały obchodzić.
Dla kogo: dla architekta platformy danych, dyrektora IT i zarządu, który ma podjąć decyzję o platformie i słyszy od zespołu trzy nazwy. Po lekturze będziecie umieli ocenić, czy proponowany format pasuje do Waszych silników, katalogu i wzorca zmian danych. Czym w ogóle jest format tabeli (table format) i jak ma się do plików Parquet, wyjaśnia poradnik główny o formatach plików i tabel — tu zakładamy, że to już wiecie.
Co dziś nie działa
— Potrzebuję marży po klientach z zeszłego kwartału. — Z której kopii? Zespół raportowy ma swoją w Fabric, analitycy w Snowflake, a dział AI trzyma trzecią, bo ich silnik czyta tylko Iceberg. — A która jest prawdziwa? — Każda. Dla swojego zespołu. (Trzy kopie tych samych faktur, trzy harmonogramy ładowania, trzy daty ostatniej aktualizacji. Jedna firma.)
Kopie danych nie powstają ze złej woli. Powstają, bo każdy zespół kupił silnik, który najlepiej czytał jeden format, a potem skopiował dane, żeby móc pracować. Po roku firma płaci trzy razy za składowanie, trzy razy za ładowanie i raz — najdrożej — za spór na zarządzie, która liczba jest prawdziwa. Format tabeli miał to rozwiązać: jeden zestaw plików, jedna lista „co jest tabelą”, wiele silników. Rozwiązuje, pod warunkiem że silniki czytają ten sam format albo że ktoś zadbał o tłumaczenie między nimi.
Trzy architektury metadanych na jednym rysunku
Wszystkie trzy formaty trzymają dane w niezmiennych plikach Parquet i dopisują nad nimi metadane. Różnią się tym, gdzie leży prawda o tabeli i jak się ją zmienia.
Delta Lake prowadzi log transakcji. W katalogu _delta_log/ leżą ponumerowane pliki JSON — jeden na transakcję — z akcjami add (nowy plik danych), remove (plik przestaje należeć do tabeli), metaData (schemat i partycje), protocol (wymagana wersja czytelnika i pisarza) oraz commitInfo. Co pewien czas powstaje punkt kontrolny (checkpoint) w Parquet, żeby czytelnik nie musiał odtwarzać historii od pierwszego pliku. Zmiana tabeli to zapis kolejnego pliku logu; dwa procesy piszące naraz rozwiązuje optymistyczna kontrola współbieżności — drugi sprawdza, czy pierwszy nie zmienił tych samych plików, i w razie konfliktu próbuje ponownie. Szczegóły są w protokole Delta Lake. Aktualne wydanie to 4.4.0 z sierpnia 2026 (sprawdzono 21.10.2026, lista wydań).
Apache Iceberg buduje drzewo. Plik metadanych tabeli wskazuje aktualną migawkę (snapshot); migawka wskazuje listę manifestów; każdy manifest — zapisany w Avro — wylicza pliki danych i pliki usunięć razem ze statystykami kolumn. Zmiana tabeli to zapisanie nowego drzewa i atomowa podmiana wskaźnika w katalogu na nowy plik metadanych. Katalog jest więc jedynym miejscem, w którym cokolwiek się zmienia — i jedynym, które musi gwarantować atomowość. Stąd rola specyfikacji katalogu REST: każdy silnik rozmawia z katalogiem tym samym językiem. Specyfikacja tabeli w wersji 3 jest przyjęta (spec), aktualne wydanie biblioteki to 1.12.0 z września 2026 (sprawdzono 21.10.2026, katalog wydań ASF).
Apache Hudi prowadzi oś czasu (timeline). Każda akcja — commit, deltacommit, kompaktowanie, klastrowanie, czyszczenie, przywrócenie — ma na niej swój wpis i przechodzi przez stany REQUESTED, INFLIGHT, COMPLETED. Obok osi czasu Hudi utrzymuje tabelę metadanych z indeksami, w tym indeksem rekordów, który mówi, w jakim pliku leży rekord o danym kluczu. To ten indeks pozwala aktualizować pojedyncze wiersze bez skanowania całej tabeli. Hudi ma dwa typy tabel: Copy-on-Write (CoW), gdzie aktualizacja przepisuje plik bazowy, i Merge-on-Read (MoR), gdzie zmiany dopisuje się do plików dziennika, a kompaktowanie scala je później w nowe pliki bazowe (typy tabel, oś czasu). Aktualne wydanie to 1.2.1 z września 2026 (sprawdzono 21.10.2026, katalog wydań ASF).
| Delta Lake | Apache Iceberg | Apache Hudi | |
|---|---|---|---|
| Gdzie leży prawda o tabeli | ponumerowany log JSON _delta_log/ + punkty kontrolne | plik metadanych → migawka → manifesty; wskaźnik w katalogu | oś czasu akcji + tabela metadanych z indeksami |
| Jak zatwierdza się zmianę | zapis kolejnego pliku logu | atomowa podmiana wskaźnika w katalogu | wpis na osi czasu przechodzi do COMPLETED |
| Współbieżność | optymistyczna kontrola konfliktów | optymistyczna, oparta na katalogu | jeden pisarz domyślnie; OCC z blokadami; nieblokująca kontrola (NBCC) dla MoR w 1.x |
| Jednostka aktualizacji | plik (z wektorami usunięć — wiersz) | plik (z plikami usunięć i wektorami — wiersz) | rekord po kluczu dzięki indeksowi |
| Zarządzanie projektem | Linux Foundation (projekt delta-io) | Apache Software Foundation | Apache Software Foundation |
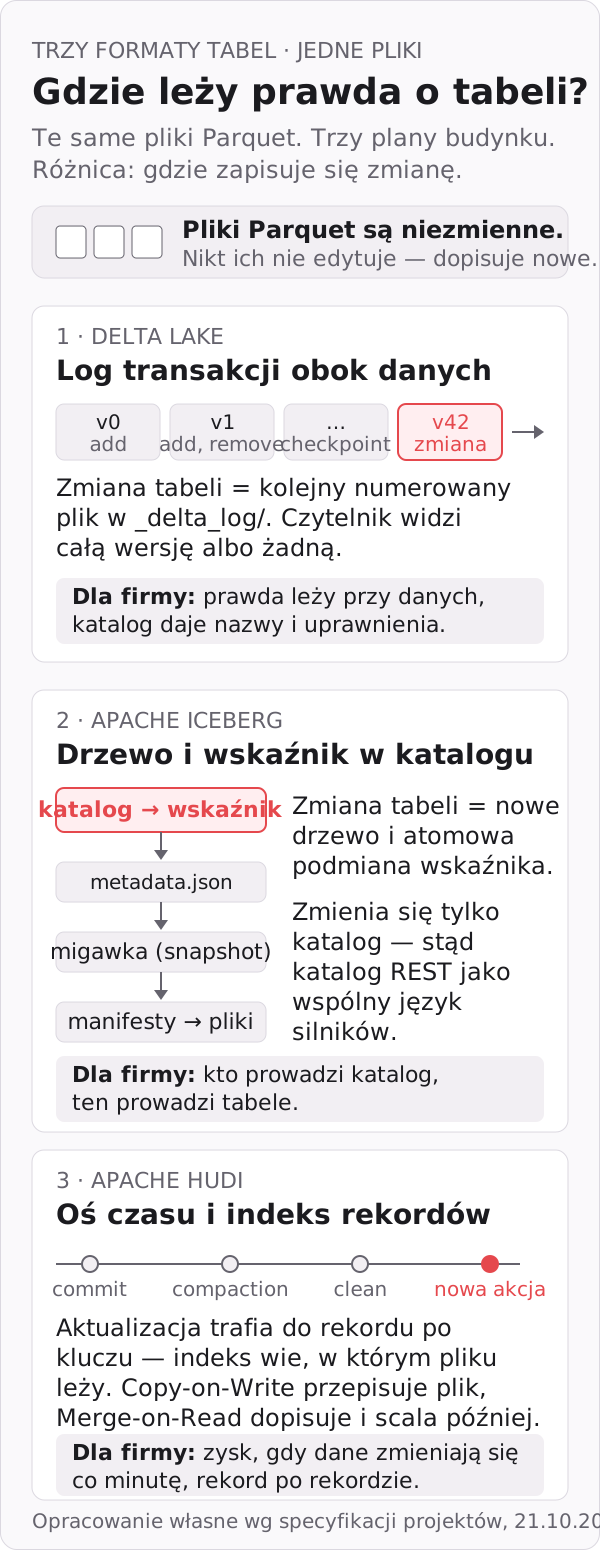
Dla zarządu z tego rysunku wynika jedna rzecz: w Icebergu katalog jest częścią architektury, nie dodatkiem. Kto prowadzi katalog, ten prowadzi tabele. W Delcie katalog jest potrzebny do nazw i uprawnień, ale prawda o tabeli leży w logu obok danych. W Hudi prawda leży na osi czasu, a przewaga formatu pojawia się dopiero wtedy, gdy macie klucz rekordu i aktualizacje po tym kluczu.
Wspólne kryteria: ta sama macierz dla trzech formatów
Porównanie ma sens tylko wtedy, gdy każdemu formatowi zadajemy te same pytania. Poniżej dziewięć kryteriów, które wracają w każdym projekcie. Stan funkcji według dokumentacji projektów na 21.10.2026 — przed decyzją sprawdźcie na własnych wersjach silników.
| Kryterium | Delta Lake | Apache Iceberg | Apache Hudi |
|---|---|---|---|
| Transakcje ACID | tak, przez log | tak, przez atomową podmianę w katalogu | tak, przez oś czasu |
| Usunięcia bez przepisywania plików | wektory usunięć (deletion vectors) od wersji 2.3 | pliki usunięć (pozycyjne, równościowe); w spec v3 wektory usunięć w plikach Puffin | aktualizacja i usunięcie po kluczu; w MoR do dziennika, kompaktowanie później |
| Ewolucja schematu | dodawanie, zmiana nazw przez mapowanie kolumn, rozszerzanie typów (GA w 4.0) | po identyfikatorach kolumn: dodawanie, usuwanie, zmiana nazw, kolejności, promocje typów | dodawanie, zmiana typów w zakresie zgodnym z Avro/Parquet |
| Partycjonowanie | partycje katalogowe albo liquid clustering (od 3.1) bez sztywnych partycji | ukryte partycjonowanie (hidden partitioning) przez transformacje; ewolucja partycji bez przepisywania | partycje + kubełki; klastrowanie jako serwis tabeli |
| Podróż w czasie | wersja albo znacznik czasu z logu; retencja logu domyślnie 30 dni | dowolna zachowana migawka; gałęzie i znaczniki | zapytanie na punkt osi czasu; savepoint |
| Strumienie i CDC | Change Data Feed (od 2.0); jedna tabela dla strumienia i paczki w Spark Structured Streaming | odczyt przyrostowy między migawkami; zapis z Flink i Spark | zapytania przyrostowe i CDC z obrazem przed/po; Hudi Streamer z Kafki i Debezium |
| Katalogi | Unity Catalog, OneLake, Hive Metastore, Glue | katalog REST (Apache Polaris, Lakekeeper, Snowflake, Databricks, AWS, Google), Hive, Glue, JDBC | Hive Metastore, Glue; synchronizacja do katalogów |
| Silniki (zapis / odczyt) | Spark natywnie; inne przez Delta Kernel (Java, Rust) — matryca zgodności do sprawdzenia | Spark, Flink, Trino, Hive, DuckDB, PyIceberg; Snowflake, BigQuery, Athena, Fabric po stronie platform | Spark, Flink natywnie; Trino, Presto, Hive do odczytu |
| Tłumaczenie na inne formaty | UniForm: metadane Iceberg (i Hudi w podglądzie) generowane obok logu | cel tłumaczenia dla UniForm i XTable; źródło w XTable | źródło i cel w XTable |
Trzy wnioski z tej macierzy, zanim przejdziemy do decyzji. Po pierwsze, na poziomie funkcji różnice są mniejsze, niż sugerują konferencyjne slajdy — każdy format ma transakcje, usunięcia i podróż w czasie. Po drugie, różnice wracają w wersjach: „obsługuje Iceberg” może oznaczać specyfikację v1 bez wektorów usunięć, a „obsługuje Delta” może oznaczać protokół czytelnika 1 bez funkcji tabeli, które włączyliście. Po trzecie, kolumna „katalogi” decyduje o więcej niż kolumna „transakcje”.
Kiedy który format
Trzy profile decyzji. Nie są rozłączne i nie są ostateczne — z powodu tłumaczenia metadanych, o którym piszemy w tekście o Apache XTable i Delta UniForm.
Profil A: firma w ekosystemie Microsoft albo Databricks → Delta Lake. Jeśli Wasze dane już płyną do OneLake w Microsoft Fabric albo do Databricks, Delta jest formatem, w którym te platformy zapisują tabele (OneLake). Wybór innego formatu oznaczałby pracę przeciw platformie. Delta daje Wam tu najpełniejszy zestaw funkcji od pierwszego dnia (liquid clustering, Change Data Feed, wektory usunięć), a UniForm pozwala udostępnić te same tabele czytelnikom Iceberg.
Profil B: wiele silników, kilka chmur, Snowflake albo własny stos, nacisk na niezależność → Apache Iceberg. Jeśli raporty robi Trino albo Snowflake, modele trenuje Spark, strumienie pisze Flink, a zarząd pyta o plan wyjścia — Iceberg jest formatem, na który zgadza się najwięcej rywali: Snowflake, AWS S3 Tables, Google BigQuery, Databricks (zarządzane tabele Iceberg w Unity Catalog), Microsoft Fabric (przez OneLake). Warunek: wybieracie i utrzymujecie katalog REST (Apache Polaris jest od lutego 2026 projektem najwyższego poziomu Apache, ogłoszenie).
Profil C: ciągłe aktualizacje z CDC, deduplikacja po kluczu, dane zmieniające się w minutach → Apache Hudi. Jeśli głównym źródłem są zmiany z ERP i CRM przechwytywane przez Debezium, a tabela analityczna ma odzwierciedlać stan rekordu, nie dopisywać zdarzenia, Hudi ma do tego indeks rekordów, tabele MoR i Hudi Streamer. Cena: więcej ruchomych części i mniejsze wsparcie natywne u vendorów platform — sprawdźcie, czy Wasze silniki czytają Hudi bezpośrednio, czy przez XTable.
| Pytanie | Jeśli odpowiedź brzmi… | …to wskazuje na |
|---|---|---|
| Gdzie już leżą dane? | OneLake / Databricks | Delta Lake |
| Ile silników ma czytać te same tabele? | trzy i więcej, w tym spoza jednego vendora | Apache Iceberg |
| Jak zmieniają się dane? | aktualizacje pojedynczych rekordów co minutę | Apache Hudi |
| Kto prowadzi katalog? | platforma vendora | Delta (Fabric, Databricks) albo Iceberg (Snowflake, AWS, Google) |
| Kto prowadzi katalog? | my, na własnym stosie | Apache Iceberg + Polaris/Lakekeeper |
| Czy zarząd pyta o plan wyjścia? | tak, w pierwszym zdaniu | Iceberg jako format docelowy; Delta z UniForm jako droga do niego |
Gdzie ta decyzja zaszkodzi, jeśli podjąć ją za szybko
Format nie równa się katalog. Można mieć dane w otwartym Icebergu i katalog, do którego ma dostęp tylko jedna platforma. Wtedy „otwartość” kończy się na plikach: uprawnienia, nazwy tabel, wersje i wydawanie poświadczeń do danych zostają u vendora. Przy ocenie oferty pytajcie nie „czy to Iceberg”, lecz „czy katalog ma otwarty interfejs REST i czy inny silnik może się do niego podłączyć bez Waszej platformy”.
Wersje specyfikacji. Iceberg ma trzy przyjęte wersje specyfikacji, Delta ma funkcje tabeli z własnymi wymaganiami co do wersji czytelnika i pisarza (wersjonowanie Delta), Hudi ma wersję tabeli (w 1.2 — dziewiątą). Włączenie nowszej funkcji może zamknąć odczyt starszemu silnikowi. Zanim włączycie wektory usunięć albo liquid clustering, sprawdźcie, czy czyta je każdy silnik z listy — także ten, którego używa raz w miesiącu dział finansów.
Zadania serwisowe to stały koszt. Kompaktowanie małych plików, czyszczenie starych wersji (VACUUM w Delcie, wygaszanie migawek w Icebergu, cleaner w Hudi), przepisywanie manifestów — każdy format ich potrzebuje i żaden nie uruchomi ich za Was poza usługą zarządzaną. Bez właściciela tabeli lakehouse po roku kosztuje więcej niż hurtownia, przed którą uciekał.
Rynek się rusza. W czerwcu 2024 Databricks ogłosił przejęcie Tabular, firmy założonej przez twórców Icebergu, z deklarowanym celem zgodności Delta i Iceberg przez UniForm (komunikat). AWS wprowadził S3 Tables z wbudowanym Icebergiem, Snowflake oparł Open Catalog na Apache Polaris, Microsoft wirtualizuje metadane Delta i Iceberg w OneLake. To są fakty z dokumentacji; co z nich wyniknie za dwa lata, nikt uczciwie nie powie. Dlatego decyzję o formacie podejmujcie na podstawie tego, co Wasze silniki czytają dziś, a nie tego, co vendorzy obiecują na przyszły rok.
Przykład dydaktyczny: grupa po przejęciu z trzema silnikami
To przykład ilustracyjny, nie studium klienta — ma pokazać mechanizm decyzji, nie wynik wdrożenia. Załóżmy firmę handlowo-produkcyjną, około 250 osób po przejęciu mniejszej spółki. Spółka matka ma Microsoft 365 i Fabric, przejęta spółka — zespół analityczny na Snowflake, a nowy zespół AI pracuje na Spark i Trino na własnym stosie. Każdy zespół ma kopię tabeli faktur, zamówień i klientów.
Stan przed. Trzy kopie, trzy harmonogramy ładowania, trzy wersje definicji „aktywny klient”. Raport dla zarządu powstaje w Excelu z trzech eksportów. Żądanie usunięcia danych klienta zgodnie z RODO wymaga trzech zgłoszeń do trzech zespołów.
Decyzja według macierzy. Dane już leżą w OneLake, więc formatem zapisu zostaje Delta Lake — praca przeciw platformie nie ma sensu. Ponieważ Snowflake i Trino mają czytać te same tabele, włączany jest UniForm, który generuje metadane Iceberg obok logu Delta; Snowflake czyta tabele przez katalog, Trino przez katalog REST. Hudi nie wchodzi w grę: dane zmieniają się paczkami z ERP raz na godzinę, nie rekord po rekordzie co minutę.
Co robi system. Jedna kopia plików Parquet w OneLake. Log Delta jako prawda o tabeli, metadane Iceberg jako widok tylko do czytania dla pozostałych silników. Usunięcie klienta to jedno polecenie DELETE w tabeli Delta, a po VACUUM rekord znika również z historii; widok Iceberg odzwierciedla zmianę po kolejnej synchronizacji metadanych.
Co zostaje przy człowieku. Właściciel tabeli decyduje o retencji historii (ile dni podróży w czasie), o tym, kto zatwierdza zmianę schematu, i o tym, kiedy uruchamia się kompaktowanie. Dyrektor finansowy zatwierdza jedną definicję „aktywnego klienta” — żaden format nie zrobi tego za niego.
Czym zmierzyć. Liczba kopii tabeli (cel: jedna), liczba procesów ładowania, które można wyłączyć, czas od żądania RODO do potwierdzenia usunięcia, czas podłączenia nowego silnika do istniejących tabel, koszt składowania przed i po. Liczby wpiszecie sami — tu liczy się kierunek.
Po czym poznać wartość
Mierniki wyniku, które zarząd zobaczy w rachunku, a nie w prezentacji:
- Liczba kopii tych samych danych między silnikami i zespołami. Format tabeli działa, gdy spada do jednej.
- Czas dodania nowego silnika do istniejących tabel — od decyzji do pierwszego poprawnego zapytania. Mierzy otwartość katalogu, nie formatu.
- Koszt zadań serwisowych na terabajt miesięcznie: kompaktowanie, czyszczenie, przepisywanie metadanych. Jeśli rośnie szybciej niż dane, tabela nie ma właściciela.
- Czas realizacji usunięcia zgodnie z RODO — od zgłoszenia do potwierdzenia, że rekord zniknął również z historii i z widoków w innych formatach.
- Odsetek zapytań, które pomijają partycje albo pliki dzięki statystykom — pokazuje, czy projekt partycji i klastrowania pracuje.
Mierniki próżności: liczba tabel, liczba terabajtów, liczba funkcji formatu włączonych w konfiguracji. Żadna z nich nie zmienia marży.
Pierwszy krok
W poniedziałek rano spiszcie na jednej kartce trzy listy: silniki, które mają czytać tabele; silniki, które mają do nich pisać; i jedno nazwisko — kto prowadzi katalog. Dopiero z tą kartką wybierzcie format. Potem jedna tabela, dwa silniki (jeden pisze, drugi czyta), próba zmiany schematu i odczytu wersji z wczoraj. Jeśli ten test przechodzi na Waszych wersjach silników, macie format. Jeśli nie — wiecie to po tygodniu, nie po roku.
Najważniejsze w skrócie
- Delta Lake, Apache Iceberg i Apache Hudi trzymają dane w tych samych plikach Parquet; różnią się tym, gdzie leży prawda o tabeli: log, drzewo ze wskaźnikiem w katalogu, oś czasu z indeksem rekordów.
- Na poziomie funkcji różnice są małe; wracają w wersjach specyfikacji, w katalogach i w tym, które silniki piszą, a które tylko czytają.
- Delta pasuje do ekosystemu Microsoft/Databricks, Iceberg do wielu silników i planu wyjścia, Hudi do ciągłych aktualizacji po kluczu.
- Format nie równa się katalog. Pytajcie o otwarty interfejs REST katalogu, nie tylko o nazwę formatu.
- Zadania serwisowe to stały koszt w każdym z trzech formatów; bez właściciela tabeli żaden format nie obniży kosztów.
- Dane i analityka
- Open Source AI
- Lakehouse
- Porównanie
