Delta Lake: log transakcji, który zrobił z jeziora danych hurtownię
Temat: Open Source AI
Delta Lake dodaje do katalogu plików Parquet jedną rzecz, której brakowało jeziorom danych: ponumerowany log transakcji w JSON, w którym każdy wpis mówi, które pliki doszły, które odpadły i jaki jest schemat. Z tego jednego mechanizmu wynika reszta — transakcje ACID, podróż w czasie, MERGE, strumień i paczka na tej samej tabeli. Delta jest domyślnym formatem Databricks i formatem tabel w OneLake w Microsoft Fabric, więc dla wielu polskich firm z Microsoft 365 jest pierwszym formatem tabel, z jakim się zetkną — często nie wiedząc, że go używają.
Ten profil pokazuje, jak działa log, co dają nowsze funkcje (wektory usunięć, liquid clustering, UniForm), gdzie Delta jest otwarta, a gdzie wygoda platformy zaczyna kosztować. Czym jest format tabeli (table format) i dlaczego sam Parquet nie wystarcza, wyjaśnia poradnik główny o formatach plików i tabel. Dla kogo: dla zespołu w ekosystemie Microsoft albo Databricks, dla dyrektora IT i dla zarządu, który pyta „czy to nas zamyka”.
Co dziś nie działa
— Raport za wrzesień pokazuje pół miesiąca. — Nocne ładowanie padło o 3:14, połowa plików weszła, połowa nie. — Kto to zauważył? — Klient. Dostał fakturę zbiorczą bez drugiej połowy dostaw. (Każdy plik z osobna jest poprawny. Niepoprawna jest tabela, której nikt nie zdefiniował.)
Jezioro danych bez formatu tabeli zna tylko pliki. Zadanie, które pisze czterysta plików i pada po dwustu, zostawia katalog, w którym nie ma błędu — i nie ma prawdy. Drugi proces, który w tym czasie czyta, dostaje stan, którego nikt nie zamawiał. Hurtownia danych nie miała tego problemu, bo trzymała dane w zamkniętym formacie i sama pilnowała transakcji. Delta Lake powstała po to, żeby dać tę samą gwarancję plikom w magazynie obiektowym, nie zamykając ich w jednym silniku.
Jak działa log _delta_log/
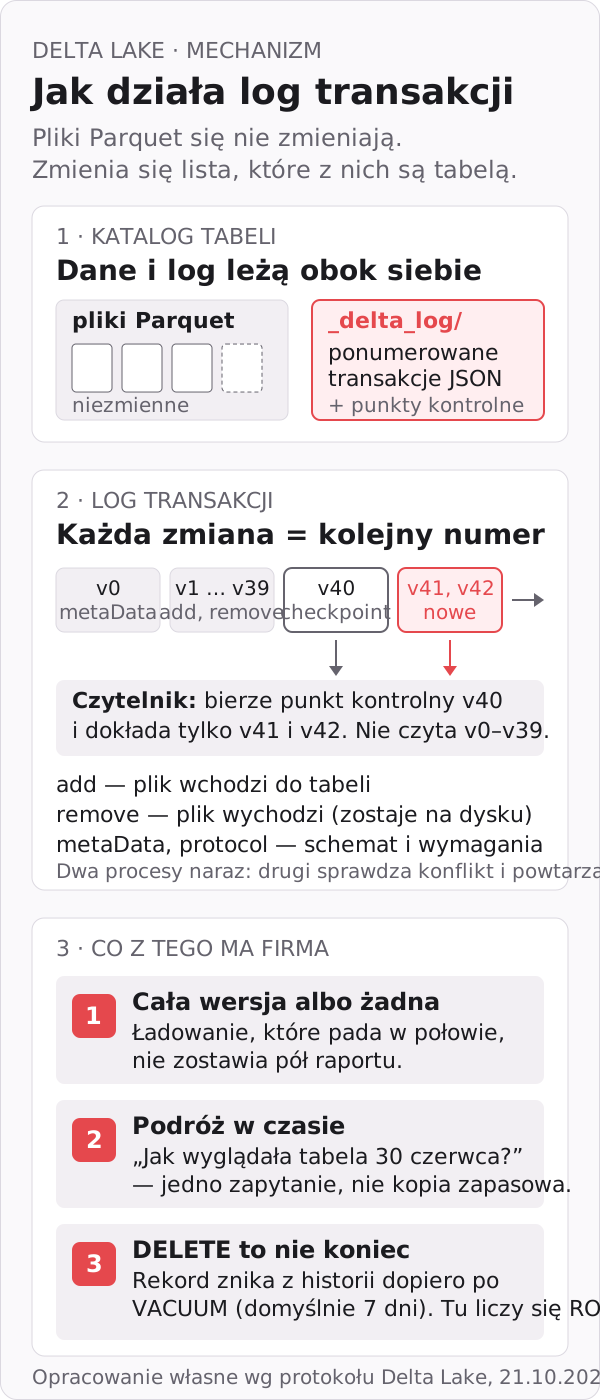
Tabela Delta to katalog z plikami Parquet i podkatalog _delta_log/. W logu leżą pliki JSON nazwane dwudziestocyfrowym numerem wersji: 00000000000000000000.json, …0001.json i tak dalej. Każdy plik to jedna transakcja, a w niej akcje:
| Akcja | Co mówi |
|---|---|
add | ten plik Parquet od tej wersji należy do tabeli (ze statystykami kolumn i wartościami partycji) |
remove | ten plik od tej wersji nie należy do tabeli (plik zostaje na dysku do czasu VACUUM) |
metaData | schemat tabeli, kolumny partycjonowania, właściwości |
protocol | minimalna wersja czytelnika i pisarza oraz włączone funkcje tabeli |
commitInfo | kto, kiedy, jaką operacją |
cdc, txn, domainMetadata | pliki zmian dla Change Data Feed, identyfikatory transakcji strumieniowych, metadane domenowe |
Aktualny stan tabeli to wynik odtworzenia wszystkich akcji od początku. Żeby nie czytać tysięcy plików JSON, Delta zapisuje co pewien czas punkt kontrolny (checkpoint) w Parquet — zrzut stanu na daną wersję — a plik _last_checkpoint wskazuje ostatni. Czytelnik bierze punkt kontrolny i dokłada tylko nowsze pliki JSON (protokół Delta).
Dwa procesy piszące naraz rozwiązuje optymistyczna kontrola współbieżności: każdy zapisuje swój plik logu pod kolejnym numerem; jeśli numer jest już zajęty, proces sprawdza, czy konkurencyjna transakcja dotknęła tych samych plików, i albo powtarza zapis pod nowym numerem, albo zgłasza konflikt. Czytelnik zawsze widzi tabelę na konkretną wersję: całą albo żadną. Noc z 3:14 kończy się nieudaną transakcją i nienaruszoną tabelą.
Z logu wynika też podróż w czasie (time travel): SELECT … VERSION AS OF 41 albo TIMESTAMP AS OF '2026-09-30' odtwarza listę plików na tamtą wersję, o ile pliki jeszcze leżą na dysku. Retencja logu to domyślnie 30 dni, a VACUUM usuwa pliki nienależące do żadnej wersji starsze niż 7 dni (narzędzia Delta). Te dwie liczby decydują, jak daleko w tył da się cofnąć — i kiedy usunięcie zgodnie z RODO staje się ostateczne.
Co dają nowsze funkcje tabeli
Delta rozwija się przez funkcje tabeli (table features), które włącza się per tabela i które podnoszą wymaganą wersję czytelnika i pisarza. Stan według dokumentacji wersjonowania i listy wydań; aktualne wydanie to 4.4.0 z sierpnia 2026 (sprawdzono 21.10.2026).
| Funkcja | Co robi | Dlaczego ma znaczenie dla firmy | Od wydania |
|---|---|---|---|
| Wektory usunięć (deletion vectors) | usunięte wiersze oznacza się w małym pliku pomocniczym zamiast przepisywać cały plik Parquet | DELETE i MERGE tanieją; usunięcie klienta nie przepisuje gigabajtów | 2.3 |
| Liquid clustering | zastępuje sztywne partycje klastrowaniem po wybranych kolumnach, które można zmienić bez przepisywania tabeli | koniec z „źle dobraliśmy partycje, przeładujmy wszystko” | 3.1 |
| Mapowanie kolumn (column mapping) | kolumny mają identyfikatory, więc zmiana nazwy nie przepisuje danych | dział może przemianować kolumnę bez projektu migracji | 1.2 |
| Change Data Feed | tabela wystawia dziennik zmian: co doszło, co odpadło, co się zmieniło | raport przyrostowy i agent AI czytają tylko zmiany, nie całą tabelę | 2.0 |
| Śledzenie wierszy (row tracking) | każdy wiersz ma trwały identyfikator | podstawa dla przyrostowych widoków i audytu „skąd ten wiersz” | 3.2 |
| Rozszerzanie typów (type widening) | kolumna int może stać się long bez przepisywania | zmiana w ERP nie wymusza przeładowania tabeli | GA w 4.0 |
| Typ VARIANT | dane półstrukturalne (JSON) w kolumnie z wydajnym odczytem | zdarzenia o zmiennej strukturze bez spłaszczania na siłę | 4.0 |
| UniForm | obok logu Delta generuje metadane Iceberg (i Hudi w podglądzie) | Snowflake, BigQuery i silniki Iceberg czytają tę samą tabelę | 3.1 (Iceberg), 3.2 (Hudi) |
Dwie uwagi, zanim włączycie wszystko. Po pierwsze, każda z tych funkcji podnosi wymaganą wersję protokołu — silnik, który czyta Deltę przez starszą bibliotekę, przestanie widzieć tabelę. Po drugie, Delta Kernel — biblioteki w Javie i Ruście — istnieje po to, żeby inne silniki nie musiały same implementować protokołu; to, czy Wasz silnik z niego korzysta i w jakiej wersji, decyduje o tym, które funkcje tabeli możecie włączyć.
Delta w Microsoft Fabric i Databricks: gdzie kończy się format, a zaczyna platforma
Silniki Fabric — T-SQL, Spark, Analysis Services — zapisują dane w OneLake „w otwartym formacie Delta Parquet” (dokumentacja OneLake). To znaczy, że lakehouse w Fabric, hurtownia w Fabric i model semantyczny Power BI pracują na tabelach Delta, a Wasz zespół może je czytać Sparkiem albo dowolnym narzędziem obsługującym Delta przez API zgodne z ADLS Gen2. Databricks podobnie: Delta jest formatem domyślnym, a Unity Catalog warstwą nazw, uprawnień i rozliczeń.
Tu leży granica, o którą pyta zarząd. Format jest otwarty: pliki Parquet i log JSON przeczyta inny silnik. Platforma nie jest otwarta w tym sensie: uprawnienia, modele semantyczne, raporty, harmonogramy i rozliczenie pojemności należą do vendora. Plan wyjścia z Fabric albo Databricks obejmuje więc dane (łatwe) i wszystko wokół danych (trudne). Jak to wygląda po stronie kosztów i licencji Fabric, opisuje poradnik o Microsoft Fabric dla firm.
UniForm zmienia ten rachunek o jeden element: tabela Delta z włączonym UniForm ma obok logu metadane Iceberg, generowane asynchronicznie po każdym zatwierdzeniu. Platformy czytające Iceberg widzą ją tylko do odczytu. Wymagania i ograniczenia są w dokumentacji UniForm: mapowanie kolumn włączone, protokół czytelnika co najmniej 2 i pisarza 7, wektory usunięć nieobsługiwane po stronie Iceberg w wersji v2, Change Data Feed niewidoczny przez Iceberg. Więcej o tym mechanizmie i o Apache XTable piszemy w tekście o końcu wojny formatów.
Gdzie Delta zaszkodzi, jeśli potraktować ją jak bazę danych
Małe pliki. Strumień, który co minutę dopisuje kilkaset wierszy, po miesiącu zostawia setki tysięcy plików. Log je opisuje poprawnie, ale zapytanie otwiera pliki, zamiast czytać dane. OPTIMIZE i liquid clustering rozwiązują problem — pod warunkiem, że ktoś je planuje i opłaca.
DELETE to nie usunięcie. Po DELETE wiersz znika z aktualnej wersji, ale fizycznie leży w starym pliku aż do VACUUM. Jeśli retencję ustawicie na 90 dni dla wygody audytu, żądanie usunięcia danych zgodnie z RODO realizujecie w 90 dni — chyba że uruchomicie VACUUM ręcznie dla tej tabeli. Właściciel tabeli musi znać tę zależność, zanim podpisze procedurę RODO.
Funkcje tabeli zamykają czytelników. Włączenie wektorów usunięć w tabeli, którą raz w miesiącu czyta narzędzie finansów ze starą biblioteką, kończy się błędem w dniu zamknięcia miesiąca. Lista silników i ich wersji musi istnieć przed włączeniem funkcji, nie po.
Otwarty format, zamknięty katalog. Dane w Delcie w OneLake są otwarte. Uprawnienia, modele semantyczne i rozliczenie nie. Jeśli plan wyjścia kończy się na zdaniu „mamy Parquet w OneLake”, nie jest planem wyjścia.
Przykład dydaktyczny: producent z Microsoft 365 i nocnym ładowaniem z ERP
To przykład ilustracyjny, nie studium klienta — pokazuje mechanizm, nie wynik wdrożenia. Załóżmy firmę produkcyjną, około 180 osób, z Microsoft 365, ERP i systemem realizacji produkcji (MES). Dane z obu systemów trafiają nocą do lakehouse w Fabric, a rano zarząd czyta raport w Power BI.
Stan przed. Ładowanie nadpisuje katalogi plików. Gdy pada w połowie, raport pokazuje pół nocy. Korekty z ERP (zmieniona cena, anulowane zlecenie) wymagają przeładowania całego miesiąca. Żądanie usunięcia danych byłego pracownika realizuje administrator ręcznie, szukając plików po dacie.
Co robi system po przejściu na tabele Delta. Każde ładowanie jest transakcją: albo cały dzień wchodzi, albo nic, a raport czyta ostatnią zatwierdzoną wersję. Korekty wchodzą przez MERGE po kluczu zlecenia, bez przeładowania miesiąca; wektory usunięć sprawią, że MERGE nie przepisuje całych plików. Change Data Feed wystawia zmiany, więc agent AI analizujący odchylenia kosztów czyta tylko to, co się zmieniło od wczoraj. Usunięcie danych pracownika to jedno polecenie DELETE, a po VACUUM rekord znika także z historii. Podróż w czasie pozwala pokazać audytorowi tabelę na 30 czerwca jednym zapytaniem.
Co zostaje przy człowieku. Właściciel tabeli decyduje o retencji historii (ile dni podróży w czasie wobec procedury RODO), o tym, kto zatwierdza zmianę schematu po zmianie w ERP, i o harmonogramie OPTIMIZE i VACUUM. Dyrektor finansowy zatwierdza, która wersja tabeli jest „zamknięciem miesiąca” — Delta daje numer wersji, decyzję podejmuje człowiek.
Czym zmierzyć. Liczba incydentów „niespójny raport” miesięcznie, czas odtworzenia stanu na dowolny dzień (cel: jedno zapytanie), czas od żądania RODO do potwierdzenia usunięcia, czas ładowania korekt (przeładowanie miesiąca vs MERGE), miesięczny koszt zadań serwisowych. Liczby wpiszecie sami po pierwszym kwartale.
Po czym poznać wartość
- Liczba incydentów niespójnego raportu — raport z pół nocy, dwie liczby z tego samego źródła. Po przejściu na transakcje powinna spaść do zera; jeśli nie spada, problem leży przed tabelą, w źródle.
- Czas odtworzenia stanu na dzień — od pytania audytora do odpowiedzi. Podróż w czasie zamienia poszukiwanie kopii zapasowych w jedno zapytanie.
- Czas realizacji usunięcia RODO — mierzony do
VACUUM, nie doDELETE. - Koszt zadań serwisowych na terabajt —
OPTIMIZE,VACUUM, klastrowanie. Jeśli rośnie szybciej niż dane, tabela nie ma właściciela. - Odsetek plików pominiętych dzięki statystykom — pokazuje, czy klastrowanie pracuje dla Waszych zapytań.
Mierniki próżności: liczba tabel Delta, liczba włączonych funkcji tabeli, liczba wersji w logu. Uczciwie: na czas raportu wpływa też model semantyczny, pojemność Fabric i to, czy ktoś uporządkował definicje w ERP — Delta tego nie naprawi.
Pierwszy krok
W poniedziałek weźcie jedną tabelę ładowaną nocą, która już sprawiła kłopot. Zapiszcie ją jako Delta, włączcie Change Data Feed, zróbcie próbę MERGE z korektą i RESTORE do wczorajszej wersji. Potem jedno pytanie do właściciela: ile dni historii potrzebujemy i co to znaczy dla procedury RODO. Odpowiedź na nie jest ważniejsza niż wybór między Deltą a Icebergiem — bo wraca w każdym formacie.
Najważniejsze w skrócie
- Delta Lake to pliki Parquet plus ponumerowany log transakcji JSON z punktami kontrolnymi; z logu wynikają transakcje ACID, podróż w czasie i
MERGE. - Nowsze funkcje tabeli — wektory usunięć, liquid clustering, Change Data Feed, UniForm — rozwiązują realne problemy, ale każda podnosi wymaganą wersję czytelnika.
- Delta jest formatem natywnym Microsoft Fabric i Databricks; format jest otwarty, katalog, uprawnienia i rozliczenie należą do platformy.
DELETEnie jest usunięciem — jest nimVACUUM. Procedura RODO musi to uwzględniać.- UniForm pozwala czytać tabele Delta jako Iceberg w Snowflake, BigQuery i silnikach otwartych — tylko do odczytu i z listą ograniczeń.
- Dane i analityka
- Open Source AI
- Lakehouse
- Microsoft Fabric
