Po „wielkiej trójce”: Apache Paimon i tabela, która nadąża za strumieniem
Temat: Open Source AI
Delta Lake, Iceberg i Hudi powstały z myślą o paczkach danych i nauczyły się strumieni później; Apache Paimon powstał w ekosystemie Apache Flink z odwrotnym założeniem — tabela ma być celem i źródłem strumienia od pierwszego dnia. Zamiast układać niezmienne pliki i opisywać je logiem, Paimon porządkuje dane w drzewie LSM (log-structured merge-tree) po kluczu głównym, więc aktualizacja rekordu co sekundę nie zamienia tabeli w stertę małych plików. Dla firmy oznacza to jedną tabelę, którą jednocześnie zasila strumień zdarzeń z hali i czyta raport dla zarządu, bez osobnej warstwy „batch” i osobnej „real-time”.
Ten tekst wyjaśnia, co drzewo LSM zmienia w architekturze tabeli, kiedy to ma sens, a kiedy jest przerostem — i jak Paimon ma się do trzech starszych formatów. To tekst o formacie tabeli, nie o Flinku jako silniku; o Flinku piszemy osobno w profilu Apache Flink. Podstawy — czym format tabeli różni się od formatu pliku i dlaczego Parquet sam nie wystarcza — porządkuje poradnik o formatach plików i tabel.
Co dziś nie działa
— Ile mamy dziś na stanie wariantu 40×60 w szarym? — Zależy, gdzie patrzysz. WMS mówi 312, dashboard real-time 298, raport z hurtowni 340. — Który jest prawdziwy? — Raport z hurtowni. Ale on jest z szóstej rano. (Jest 14:30. Od rana wyjechały trzy auta, a handlowiec właśnie obiecał klientowi 320 sztuk.)
Większość firm, które chcą widzieć stan „na teraz”, kończy z dwiema równoległymi warstwami danych. Pierwsza to klasyczna hurtownia albo lakehouse ładowany nocą: spójny, zgodny z księgowością, ale spóźniony o kilkanaście godzin. Druga to „dashboard real-time” — osobna baza, osobny strumień, osobny zespół, który liczy ten sam stan magazynu inaczej, bo nie ma dostępu do korekt i zwrotów z ERP. Dwie warstwy to dwa koszty utrzymania i dwie wersje prawdy, a decyzja handlowca pada na tę, która akurat jest otwarta w przeglądarce.
Formaty tabel pierwszej generacji obiecywały zasypać tę przepaść: jedna tabela dla wsadów i strumieni. W praktyce strumień, który pisze do nich co kilka sekund, uruchamia lawinę problemów, o których za chwilę. Paimon powstał jako odpowiedź na te problemy od strony Flinka — ekosystemu, w którym strumień jest domyślny, a paczka to tylko strumień o skończonej długości.
Dlaczego trzy starsze formaty męczą się ze strumieniem
Delta Lake, Apache Iceberg i Apache Hudi dzielą tę samą ideę: pliki danych są niezmienne (immutable), a tabela to lista plików opisana w metadanych — logiem w Delta, drzewem manifestów w Icebergu, osią czasu w Hudi. To jest dobra idea dla paczek: zadanie zapisuje kilkadziesiąt dużych plików Parquet, zatwierdza nową wersję i wszystko gra.
Strumień łamie trzy założenia tej idei naraz:
| Założenie formatów pierwszej generacji | Co robi z nim strumień | Skutek |
|---|---|---|
| Zapis to duże, rzadkie paczki | zapisuje małe paczki co kilka sekund | tysiące plików po kilkadziesiąt kilobajtów; zapytanie otwiera pliki zamiast czytać dane |
| Rekordy się dopisuje, rzadko zmienia | aktualizuje ten sam rekord (stan zamówienia) wiele razy na minutę | każda zmiana to nowy plik plus plik usunięć albo przepisanie; wersje tabeli rosną szybciej niż dane |
| Kompaktowanie to zadanie serwisowe uruchamiane „czasem” | kompaktować trzeba bez przerwy, bo małe pliki powstają bez przerwy | kompaktowanie staje się stałym kosztem obliczeń i trzeba je koordynować z pisarzem |
Każdy z trzech formatów wypracował obejścia. Delta Lake dodała wektory usunięć (deletion vectors), żeby nie przepisywać plików przy usunięciach, i tryb strumieniowy w Spark Structured Streaming. Iceberg ma pliki usunięć i wektory usunięć w specyfikacji v3, a konektor Flink zapisuje do tabel strumieniowo. Hudi jest tu najbliższym kuzynem Paimona: jego tryb Merge-on-Read dopisuje zmiany do plików dziennika i scala je z plikami bazowymi dopiero przy kompaktowaniu albo odczycie, a indeks rekordów pozwala szybko znaleźć, który plik trzeba zmienić.
Wspólną cechą tych obejść jest to, że dokładają mechanizm do modelu, który strumienia nie zakładał. Paimon odwraca kolejność: zaczyna od struktury danych, która od zawsze służyła do przyjmowania ciągłego strumienia zapisów, i dokłada do niej migawki tabeli.
Drzewo LSM w tabeli: co się zmienia
Drzewo LSM to struktura znana z baz danych zorientowanych na zapis — tak działają pod spodem RocksDB, Cassandra czy HBase. Pomysł jest prosty: nowe rekordy trafiają do małego, posortowanego pliku na „poziomie zero”; gdy takich plików przybędzie, scala się je w większe, posortowane pliki na niższych poziomach. Scalanie (compaction) nie jest tu dodatkiem serwisowym — jest częścią definicji struktury. Bez scalania drzewo LSM nie istnieje.
W Paimonie tabela z kluczem głównym (primary key table) jest zbiorem takich drzew: dane dzielą się na partycje, partycje na kubełki (buckets), a każdy kubełek jest osobnym drzewem LSM posortowanym po kluczu głównym. Rekord o tym samym kluczu, który przychodzi po raz dziesiąty, nie tworzy dziesiątego pliku do odnalezienia przez indeks — trafia do kolejki scalania, która z definicji wie, że ma go złożyć z poprzednimi wersjami. Nad tym Paimon trzyma to, co znacie z pozostałych formatów: migawki (snapshots), manifesty, znaczniki (tags) przypinające wybrane migawki i gałęzie (branches).
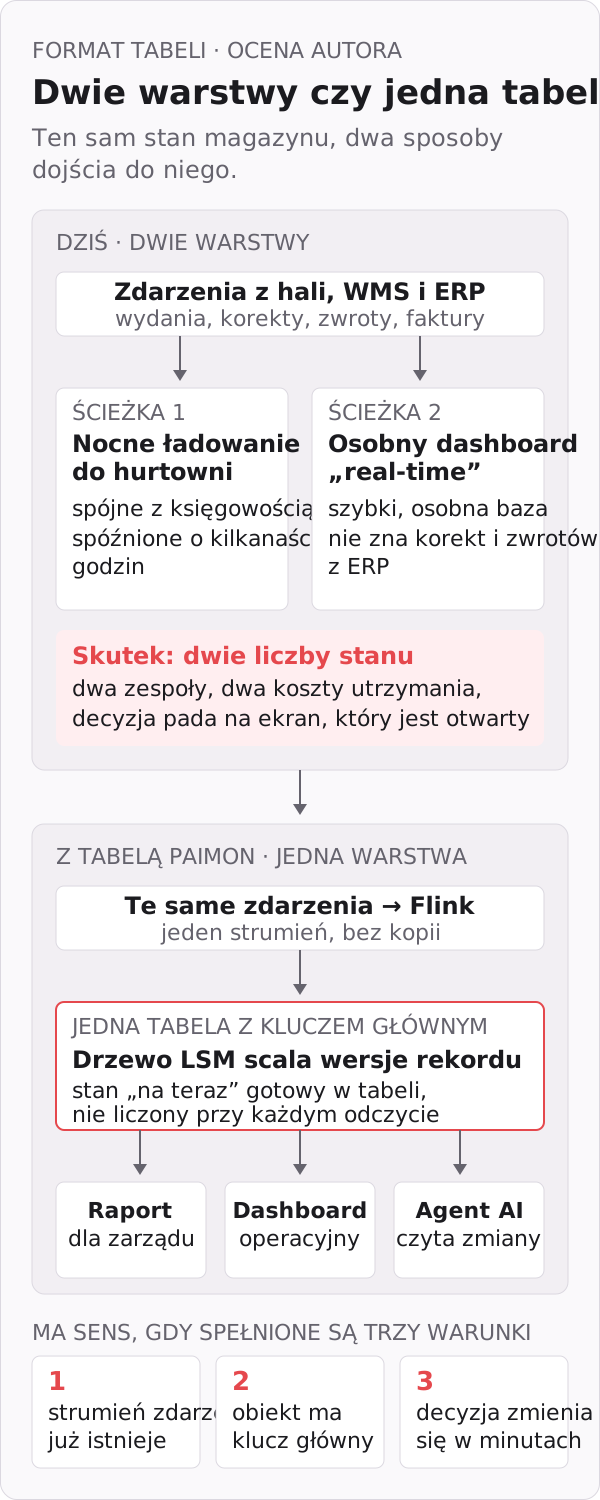
Z tej konstrukcji wynikają trzy konsekwencje, które odróżniają Paimon od trójki:
- Aktualizacja po kluczu jest operacją pierwszej klasy. Nie trzeba indeksu, który odnajdzie plik do zmiany, ani pliku usunięć, który unieważni stary wiersz. Nowa wersja rekordu po prostu ląduje w drzewie i zostanie scalona.
- Logika składania rekordu jest w formacie, nie w kodzie. Silnik scalania (merge engine) decyduje, co znaczy „ten sam klucz przyszedł drugi raz”:
deduplicatezostawia ostatnią wersję,partial-updateuzupełnia tylko pola, które przyszły,aggregationsumuje albo wybiera maksimum,first-rowzachowuje pierwszą wersję. Stan zamówienia składany z trzech systemów to konfiguracja tabeli, a nie zadanie Spark. - Tabela sama produkuje strumień zmian. Producent dziennika zmian (changelog producer:
input,lookup,full-compaction) emituje zmiany każdego rekordu, więc następny etap przetwarzania — agregat dla zarządu, agent AI — czyta tylko to, co się zmieniło.
Tabele bez klucza głównego (append tables) działają w Paimonie jak w pozostałych formatach: dopisują dane i obsługują wsadowe DELETE, UPDATE i MERGE INTO. Przewaga Paimona dotyczy więc wyłącznie obiektów, które mają klucz i zmieniają się często.
Paimon obok trójki: porównanie według tych samych kryteriów
Aktualne wydanie Paimona to 2.0.0 z 7 sierpnia 2026 (sprawdzono 21.10.2026). Poniżej porównanie z pozostałymi formatami według kryteriów, które decydują o wyborze w firmie, a nie o wyniku testu wydajności.
| Kryterium | Delta Lake | Apache Iceberg | Apache Hudi | Apache Paimon |
|---|---|---|---|---|
| Model danych | niezmienne pliki + log transakcji | niezmienne pliki + drzewo manifestów | pliki bazowe + pliki dziennika, oś czasu, indeks rekordów | drzewo LSM po kluczu głównym w kubełkach + migawki |
| Aktualizacja po kluczu | MERGE, wektory usunięć | MERGE, pliki/wektory usunięć | upsert z indeksem, tryb MoR | wbudowana w strukturę |
| Logika składania rekordu | w kodzie (Spark SQL) | w kodzie | precombine, payload | silnik scalania w formacie |
| Strumień jako źródło | Change Data Feed | odczyt przyrostowy migawek | zapytania przyrostowe, CDC | producent dziennika zmian |
| Silnik pierwszego wyboru | Spark / Databricks | wiele (Spark, Trino, Flink, Snowflake) | Spark, Flink | Flink |
| Odczyt w innych silnikach | szeroki | najszerszy | Spark, Flink, Trino, Presto | Spark, Hive, Trino, Presto, StarRocks, Doris |
| Scalanie / kompaktowanie | zadanie serwisowe (OPTIMIZE) | zadanie serwisowe | serwisy tabeli | część modelu, ciągłe |
| Zarządzanie projektem | Linux Foundation | Apache Software Foundation | Apache Software Foundation | Apache Software Foundation |
Dane o silnikach z matrycy w dokumentacji Paimona oraz dokumentacji pozostałych projektów (sprawdzono 21.10.2026). Tabela nie wskazuje zwycięzcy: wskazuje, że Paimon jest wyspecjalizowany, a specjalizacja ma cenę.
Gdzie Paimon zaszkodzi
„Real-time” jako cel sam w sobie. Zanim ktokolwiek wypowie słowo „strumień”, zapiszcie, która decyzja biznesowa naprawdę zmienia się w ciągu minuty. Rezerwacja towaru między kanałami — tak. Limit kredytowy klienta, który właśnie składa zamówienie — tak. Raport marży czytany przez zarząd w poniedziałek rano — nie. Każda minuta opóźnienia, którą zbijacie, kosztuje moc obliczeniową scalania, a Paimon nie zwalnia Was z płacenia tego rachunku; on tylko sprawia, że rachunek jest przewidywalny.
Mniejszy ekosystem. Trójka ma za sobą Databricks, Snowflake, AWS, Google i Microsoft. Paimon czytają silniki z matrycy wyżej, ale jeśli Wasze raporty mają powstawać w Power BI przez Fabric albo w Snowflake, droga prowadzi przez eksport lub Iceberg, a nie „natywnie”. Sprawdźcie to na własnych silnikach przed decyzją, nie po niej.
Klucz główny trzeba zaprojektować. Paimon bez dobrze dobranego klucza i kubełków to tabela dopisywana, czyli Iceberg bez ekosystemu Iceberga. Jeśli w firmie nikt nie potrafi powiedzieć, co jednoznacznie identyfikuje „zamówienie” między ERP, sklepem i WMS, najpierw potrzebny jest cyfrowy model firmy, a dopiero potem format tabeli.
Flink jako warunek. Zapis strumieniowy w pełnym zakresie funkcji wymaga Flinka. Jeśli zespół zna Spark, a Flink jest nowy, do kosztu formatu dochodzi koszt nauki silnika — albo partner, który go zna.
Po czym poznać wartość
Metryki próżności: liczba tabel Paimon, liczba zdarzeń na sekundę, liczba zadań Flink. Mierniki wyniku, które zarząd zobaczy w rachunku:
- Opóźnienie od zdarzenia do raportu — mierzone na jednym obiekcie (stan zapasu, stan zlecenia) przed i po. Jeśli przed wdrożeniem było „nocne ładowanie”, a po — minuty, pytanie brzmi, która decyzja na tym zyskała.
- Liczba równolegle utrzymywanych warstw dla tego samego stanu. Cel to jedna. Jeśli po roku nadal działa osobny dashboard „bo tam są inne liczby”, projekt nie domknął pętli.
- Koszt scalania na terabajt i jego udział w rachunku za obliczenia. To jest stała cena drzewa LSM; ma być znana, nie zaskakująca.
- Liczba kopii stanu „na teraz” w arkuszach, bazach pomocniczych i głowach ludzi. Spada, gdy ta sama tabela karmi operatora, handlowca i zarząd.
Uczciwie: na żadną z tych liczb nie wpływa sam format. Wpływa jakość zdarzeń u źródła, zgoda działów co do klucza i to, czy ktoś jest właścicielem tabeli stanu.
Pierwszy krok
Wybierzcie jeden obiekt, który zmienia się często i o który ludzie dzwonią: stan zapasu konkretnego indeksu albo stan jednego typu zlecenia. Spiszcie jego klucz główny i trzy systemy, które go zmieniają. Zbudujcie jedną tabelę z kluczem głównym i silnikiem partial-update, zasilcie ją strumieniem z Flinka i podłączcie jeden raport czytany co minutę. Po dwóch tygodniach porównajcie tę tabelę z dotychczasowym dashboardem i raportem z hurtowni. Jeśli trzy liczby stały się jedną — wiecie, po co Wam Paimon. Jeśli nikt nie zauważył różnicy — zaoszczędziliście sobie wdrożenia.
Szczegółowy rozkład Paimona od środka, z przykładem producenta seryjnego, znajdziecie w profilu Apache Paimon.
Najważniejsze w skrócie
- Delta, Iceberg i Hudi opierają się na niezmiennych plikach opisanych metadanymi; strumień zamienia to w lawinę małych plików i ciągłe kompaktowanie, które trzeba dokładać z zewnątrz.
- Paimon buduje tabelę z kluczem głównym na drzewie LSM, w którym scalanie jest częścią modelu, a aktualizacja po kluczu — operacją pierwszej klasy.
- Silniki scalania (
deduplicate,partial-update,aggregation,first-row) i producent dziennika zmian przenoszą logikę składania rekordu z kodu do formatu. - Cena specjalizacji: Flink jako praktyczny warunek zapisu, mniejszy ekosystem silników, konieczność zaprojektowania klucza głównego, stały koszt scalania.
- Zacznijcie od pytania, która decyzja zmienia się w minutach — dopiero potem od formatu.
- Dane i analityka
- Open Source AI
- Lakehouse
- Strumienie danych
