Apache Paimon: jedna tabela dla strumienia i raportu — jak biznes analizuje dane w locie bez podziału na batch i real-time
Temat: Open Source AI
Paimon rozwiązuje problem, którego formaty tabel pierwszej generacji nie miały w założeniach: tabelę, do której strumień z Apache Flink pisze bez przerwy, a raport czyta w tej samej chwili, bez osobnej warstwy „na teraz” i osobnej „na wczoraj”. Robi to drzewem LSM po kluczu głównym, silnikami scalania, które składają rekord z kilku źródeł w samym formacie, i dziennikiem zmian, który zasila kolejne etapy przetwarzania. Dla firmy produkcyjnej czy handlowej oznacza to jeden stan zamówienia, zapasu albo maszyny, który jest tym samym stanem dla operatora, handlowca i zarządu — tyle że widzianym z różnych raportów.
Ten profil pokazuje architekturę Paimona od środka, jego miejsce obok Flinka, Spark i silników MPP oraz warunki, pod którymi ma sens. Dlaczego w ogóle potrzebny jest format tabeli nad plikami Parquet, wyjaśnia poradnik o formatach plików i tabel; jak Paimon wypada na tle Delta Lake, Iceberga i Hudi — tekst o Paimonie po „wielkiej trójce”.
Co dziś nie działa
— Zlecenie 4471 jest gotowe do wysyłki? — MES mówi, że ostatnia operacja zamknięta o 11:40. — A WMS? — WMS jeszcze go nie widzi. ERP widzi, ale ze statusem „w produkcji”, bo synchronizacja idzie o 13:00. (Klient na linii. Planista otwiera trzy ekrany i jedną kartkę przypiętą do monitora.)
Stan jednego zlecenia produkcyjnego powstaje w kilku systemach naraz: MES zamyka operacje, ERP prowadzi status handlowy i materiały, WMS wie, co leży na regale. Każdy z nich ma rację o swoim fragmencie i żaden nie ma pełnego obrazu. Firmy sklejają ten obraz na trzy sposoby: nocnym ładowaniem do hurtowni (spójnie, ale za późno), osobnym dashboardem (szybko, ale po swojemu) albo człowiekiem, który dzwoni. Każdy z tych sposobów ma koszt, a dwa pierwsze dają dwie różne liczby.
To zadanie — złożyć jeden rekord z fragmentów, które przychodzą z różnych systemów w różnym czasie, i mieć go gotowego w chwili pytania — jest dokładnie tym, pod co zaprojektowano tabele z kluczem głównym w Paimonie.
Architektura: od zdarzenia do migawki
Aktualne wydanie to Paimon 2.0.0 z 7 sierpnia 2026, wydane razem z biblioteką PyPaimon (sprawdzono 21.10.2026). Tabela Paimon leży w magazynie obiektowym albo na HDFS i składa się z czterech warstw.
Migawki i manifesty. Jak w pozostałych formatach, stan tabeli w danej chwili opisuje migawka (snapshot), która wskazuje manifesty, a te — pliki danych. Zatwierdzenie nowej migawki jest atomowe; czytelnik widzi albo poprzednią, albo nową. Stare migawki wygasają według ustawień retencji; znacznik (tag) przypina wybraną migawkę i jej pliki na dłużej — na przykład stan na koniec miesiąca dla księgowości — a gałęzie (branches) pozwalają prowadzić równoległą wersję tabeli.
Partycje i kubełki. Dane dzielą się na partycje (np. po dacie albo zakładzie), a każda partycja na kubełki (buckets) według klucza. Kubełek jest jednostką równoległości zapisu i odczytu — liczba kubełków to decyzja projektowa, która wyznacza, ilu pisarzy może pracować naraz.
Drzewo LSM w kubełku. W tabeli z kluczem głównym każdy kubełek jest drzewem LSM: nowe rekordy trafiają do posortowanych plików na poziomie zero, scalanie łączy je w większe pliki na niższych poziomach, a odczyt składa wersje rekordu z kilku poziomów. Gdy rekordy przychodzą w złej kolejności, pole sekwencji (sequence field) rozstrzyga, która wersja jest nowsza — dokumentacja zaleca je przy źródłach, które nie gwarantują porządku.
Tabele dopisywane. Tabela bez klucza głównego (append table) przyjmuje tylko nowe wiersze i obsługuje wsadowe DELETE, UPDATE i MERGE INTO — to odpowiednik zwykłej tabeli faktów, dla dzienników zdarzeń, które nikt nie zmienia.
| Warstwa | Co trzyma | Kto decyduje |
|---|---|---|
| Migawki, znaczniki, gałęzie | wersje tabeli, stany przypięte na dłużej | właściciel tabeli: retencja, które stany przypinamy |
| Partycje | podział po czasie, zakładzie, kanale | architekt: pod wzorzec zapytań |
| Kubełki | równoległość zapisu i odczytu | architekt: pod wolumen i liczbę pisarzy |
| Drzewo LSM | wersje rekordu po kluczu, scalanie | format: automatycznie, z kosztem obliczeń |
Silniki scalania i dziennik zmian: logika biznesowa w formacie
Najbardziej odróżniającą cechą Paimona jest to, że sposób składania rekordu o tym samym kluczu jest właściwością tabeli. Dokumentacja opisuje cztery silniki scalania (merge engines):
| Silnik scalania | Co robi z drugą wersją rekordu | Przykład z firmy |
|---|---|---|
deduplicate (domyślny) | zostawia ostatnią wersję; DELETE usuwa rekord | aktualny status zlecenia z MES |
partial-update | uzupełnia tylko te pola, które przyszły; grupy sekwencji pilnują porządku per źródło | stan zlecenia składany z MES (operacje), ERP (status handlowy) i WMS (lokalizacja) |
aggregation | agreguje pola funkcją: sum, max, min, last_value, listagg, bool_or, szkice HLL i inne | liczba sztuk wyprodukowanych na zlecenie, suma minut przestoju maszyny |
first-row | zachowuje pierwszą wersję, ignoruje kolejne | moment pierwszego zgłoszenia reklamacji |
Bez Paimona tę logikę piszecie w zadaniu Spark albo Flink i utrzymujecie jako kod. Z Paimonem jest konfiguracją tabeli, którą widzi każdy, kto ją czyta — także agent AI, który ma zrozumieć, skąd wzięła się liczba.
Drugi mechanizm to producent dziennika zmian (changelog producer). Tabela może emitować strumień zmian dla konsumentów niżej: input przekazuje zmiany wprost ze strumienia wejściowego (gdy źródło samo niesie pełne zmiany, jak CDC), lookup wylicza zmiany przy zapisie przez sprawdzenie poprzedniej wersji, full-compaction emituje je przy pełnym scalaniu. Dzięki temu tabela agregatów dla zarządu nie musi czytać całej tabeli stanów — czyta tylko zmiany.
Trzeci element to lookup join we Flinku: strumień zdarzeń wzbogaca się o dane z tabeli Paimon (np. zlecenie o dane klienta i produktu) z lokalną kopią tabeli w zadaniu, odświeżaną według ustawień. Tabela Paimon jest więc jednocześnie celem strumienia i słownikiem dla innych strumieni.
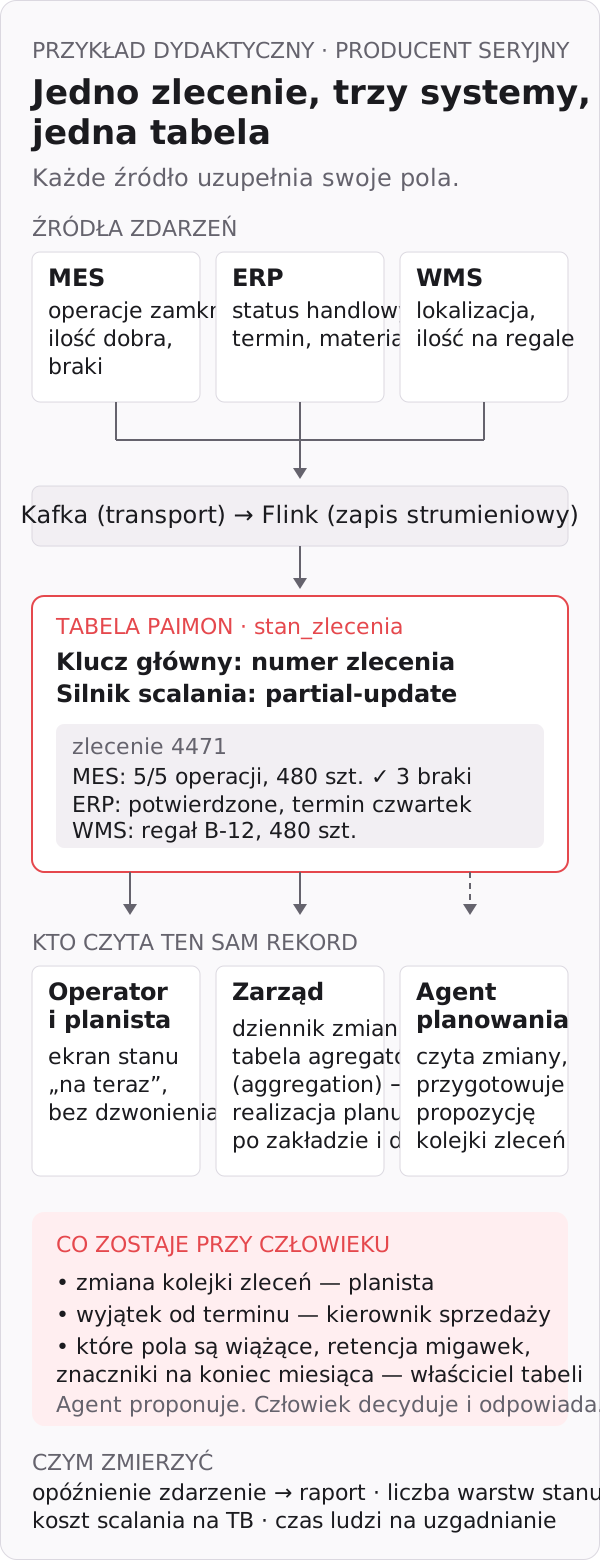
Przykład dydaktyczny: producent seryjny i stan zlecenia
To przykład ilustracyjny, nie studium klienta — firma i wielkości są umowne, mechanizm odpowiada dokumentacji. Załóżmy producenta seryjnego zatrudniającego około 250 osób, z MES na hali, ERP w biurze i WMS w magazynie wyrobów gotowych. Planista, kierownik zmiany i dyrektor operacyjny chcą jednej odpowiedzi na pytanie „na czym stoi zlecenie 4471” — teraz, nie o 6:00 rano.
Stan przed. Trzy systemy, synchronizacja ERP↔MES co godzinę, WMS raportuje do ERP na koniec zmiany. Hurtownia ładowana nocą. Dashboard „produkcja live” z osobnej bazy, który nie zna korekt z ERP. Planista spędza część dnia na dzwonieniu i porównywaniu ekranów.
Co robi system. MES, ERP i WMS publikują zdarzenia do Kafki (przez CDC albo integrację). Zadanie Flink zapisuje je do tabeli Paimon stan_zlecenia z kluczem głównym równym numerowi zlecenia i silnikiem partial-update: MES uzupełnia pola o operacjach i ilościach, ERP — status handlowy i termin, WMS — lokalizację i ilość na regale. Grupy sekwencji pilnują, żeby starsze zdarzenie z MES nie nadpisało nowszego. Producent dziennika zmian lookup emituje zmiany każdego zlecenia do tabeli agregatów realizacja_planu_dzien, z silnikiem aggregation sumującym sztuki i braki po zakładzie i dniu — z niej czyta raport dla zarządu. Agent planowania czyta ten sam dziennik zmian i gdy zlecenie zbliża się do terminu, a WMS nie widzi wyrobu, przygotowuje planiście propozycję: „przesunąć 4471 przed 4480, bo materiał na 4480 ma opóźnienie u dostawcy”. Znacznik tabeli na koniec każdego miesiąca przypina stan do rozliczeń z księgowością.
Co zostaje przy człowieku. Decyzję o zmianie kolejki zleceń podejmuje planista, nie agent. Wyjątek od terminu dla klienta zatwierdza kierownik sprzedaży. Właściciel tabeli stan_zlecenia ustala, które pola z którego systemu są wiążące, retencję migawek i które stany przypinamy znacznikami.
Czym to zmierzyć. Opóźnienie od zdarzenia w MES do widoczności w tabeli i w raporcie (cel: sekundy do minut). Liczba równolegle utrzymywanych warstw stanu — cel: jedna, bez osobnego dashboardu. Koszt zadań Flink i scalania na terabajt jako znana, stała pozycja w rachunku. Czas, jaki planista spędza na „sprawdzaniu, gdzie jest zlecenie” — jeśli potraficie go zmierzyć przed i po, to jest Wasza miara. Z perspektywy całkowitego kosztu posiadania (TCO) zestawiacie: hurtownia + osobny dashboard + godziny ludzi na uzgadnianie kontra Kafka + Flink + Paimon + jeden właściciel tabeli.
Gdzie Paimon zaszkodzi
Bez Flinka to połowa formatu. Spark zapisuje i czyta tabele Paimon wsadowo, ale lookup join, producent dziennika zmian i zapis strumieniowy z pełnym zestawem funkcji to Flink. Jeśli zespół go nie zna, do kosztu formatu dochodzi koszt nauki silnika albo partnera. Czym Flink jest i kiedy warto go wprowadzić, opisuje profil Apache Flink.
Klucz główny, którego nie ma. Jeśli numer zlecenia w MES, ERP i WMS to trzy różne identyfikatory bez tablicy przejścia, partial-update nie ma czego składać. Najpierw cyfrowy model firmy i uzgodnienie klucza, potem format.
Stały koszt scalania. Drzewo LSM scala bez przerwy; to moc obliczeniowa, którą trzeba zasilać i monitorować. Tabela, której scalanie nie nadąża, zwalnia przy odczycie — i nikt nie zobaczy tego w migawce, tylko w czasie zapytania.
Mniejszy ekosystem. Matryca silników wymienia Flink, Spark, Hive, Trino, Presto, StarRocks i Doris. Platformy vendorów nie czytają Paimona natywnie według jego dokumentacji; jeśli raporty mają powstawać w Power BI przez Fabric albo w Snowflake, zaprojektujcie ścieżkę odczytu wcześniej.
Real-time jako cel. Stan zlecenia w minutach ma sens dla planisty, który o nim decyduje. Dla zarządu, który czyta realizację planu raz w tygodniu, wystarczy tabela agregatów odświeżana rzadziej — i taniej.
Po czym poznać wartość
Metryki próżności: liczba zdarzeń na sekundę, liczba tabel, liczba zadań Flink. Mierniki wyniku:
- Opóźnienie zdarzenie → raport dla obiektów, o które ludzie dzwonią.
- Liczba warstw stanu utrzymywanych równolegle (hurtownia, dashboard, arkusz) — cel: jedna tabela.
- Koszt scalania i Flinka na terabajt — znany, stały, raportowany.
- Liczba kopii stanu „na teraz” poza tabelą: arkusze, kartki, bazy pomocnicze.
- Czas ludzi na uzgadnianie stanu między systemami — przed i po.
Na te liczby wpływa też jakość zdarzeń u źródła, zgoda działów co do klucza i to, czy ktoś jest właścicielem tabeli stanu. Paimon daje mechanizm; proces nadal prowadzi człowiek.
Pierwszy krok
Jeden obiekt stanu, który zmienia się często i ma uzgodniony klucz — zlecenie produkcyjne albo zapas jednego indeksu. Jedna tabela z kluczem głównym i silnikiem partial-update, zasilana z dwóch systemów przez Flink. Jeden raport czytany co minutę i jeden człowiek, który dotąd dzwonił. Po dwóch tygodniach porównajcie tę tabelę z dotychczasową warstwą „real-time” i hurtownią. Jeśli planista przestał dzwonić — wiecie, co dalej.
Najważniejsze w skrócie
- Paimon to format tabeli zbudowany pod strumień: tabele z kluczem głównym na drzewie LSM w kubełkach, z migawkami, znacznikami i gałęziami nad nimi.
- Silniki scalania (
deduplicate,partial-update,aggregation,first-row) składają rekord z wielu źródeł w samym formacie; producent dziennika zmian zasila kolejne etapy tylko zmianami. - Flink jest praktycznym warunkiem zapisu strumieniowego i lookup join; Spark, Hive, Trino, Presto, StarRocks i Doris czytają.
- Przewaga dotyczy obiektów z kluczem, które zmieniają się często i o które ludzie pytają „teraz”; dla dzienników zdarzeń i raportów tygodniowych wystarczą tabele dopisywane albo starsze formaty.
- Cena: stały koszt scalania, konieczność uzgodnionego klucza, mniejszy ekosystem silników i brak natywnego odczytu w platformach vendorów.
- Dane i analityka
- Open Source AI
- Lakehouse
- Strumienie danych
