Apache Iceberg: format tabeli, który czytają Snowflake, AWS i Google — i co to znaczy dla planu wyjścia Waszej firmy
Temat: Open Source AI
Apache Iceberg jest dziś formatem tabel, na którym zgadza się najwięcej rywali: Snowflake, AWS, Google Cloud, Databricks, Microsoft Fabric przez OneLake oraz silniki otwarte — Spark, Flink, Trino, DuckDB. Zgoda nie wzięła się z sentymentu, lecz z architektury: Iceberg opisuje tabelę drzewem niezmiennych metadanych, a jedynym miejscem zmiany jest wskaźnik w katalogu, co pozwala wielu silnikom bezpiecznie pisać do tej samej tabeli. Do tego katalog REST jest otwartą specyfikacją, więc firma może zmienić silnik albo chmurę bez przenoszenia danych.
Ten profil rozkłada drzewo metadanych, pokazuje, co daje ukryte partycjonowanie i specyfikacja v3, i uczciwie nazywa miejsca, w których „otwartość” nadal zależy od katalogu. Pojęcie formatu tabeli (table format) i jego relację do plików Parquet wyjaśnia poradnik główny o formatach plików i tabel. Dla kogo: dla architekta budującego stos na wielu silnikach lub chmurach, dla zarządu pytającego o suwerenność danych i dla zespołu, który ma Snowflake albo własne Trino.
Co dziś nie działa
— Ilu mamy aktywnych klientów? — W Fabric jedna liczba. W Snowflake u spółki córki druga. Dział AI w Sparku ma trzecią. — A ilu naprawdę? — Zależy, który zespół pytasz i z której kopii. (Trzy chmury po dwóch przejęciach. Trzy kopie tabeli klientów. Jedna rada nadzorcza.)
Kopie powstają, bo każdy silnik chciał mieć dane „u siebie”, w formacie, który czyta najlepiej. Z czasem firma płaci trzy razy za składowanie, trzy razy za ładowanie i raz — na zarządzie — za spór o liczbę. Iceberg powstał w Netflixie z podobnego bólu: tabele Hive na magazynie obiektowym, których lista plików zależała od listowania katalogów, a zmiana partycjonowania oznaczała przepisanie wszystkiego. Odpowiedzią było przeniesienie prawdy o tabeli z katalogów plików do drzewa metadanych.
Drzewo metadanych i jedno miejsce zmiany
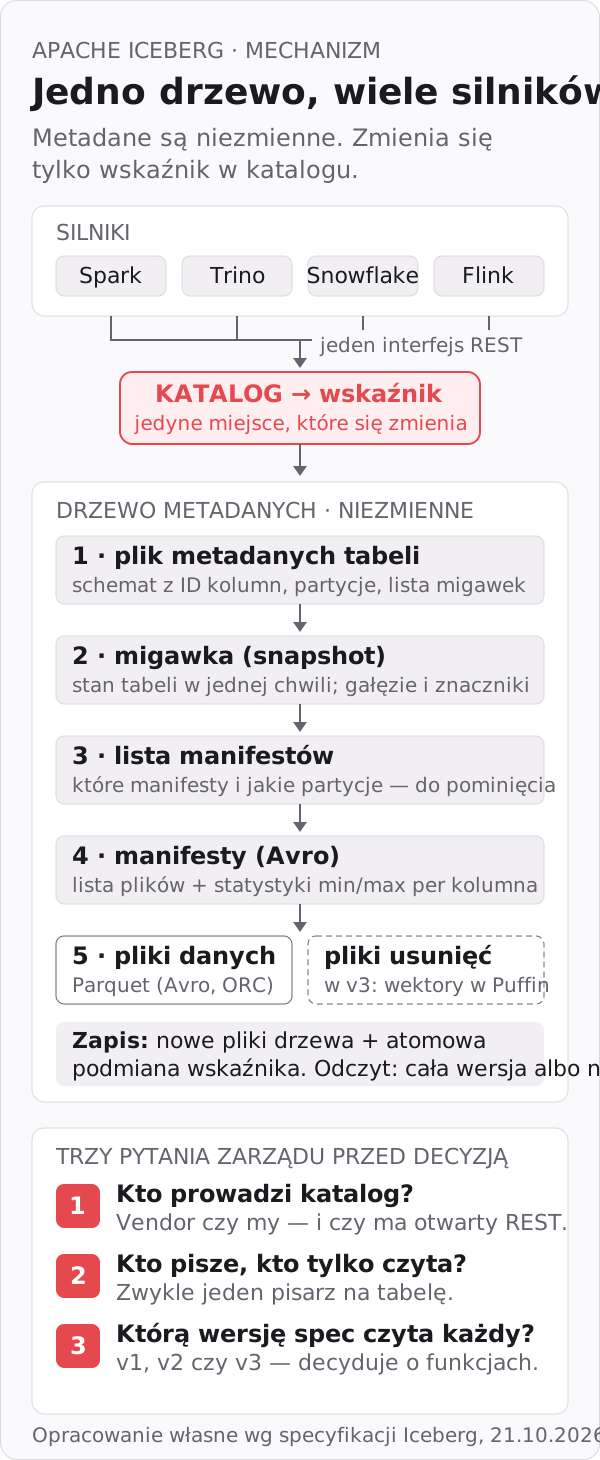
Tabela Iceberg to pliki danych (zwykle Parquet, dopuszczalne też Avro i ORC) i drzewo metadanych nad nimi (specyfikacja):
- Plik metadanych tabeli — schemat (z identyfikatorami kolumn), specyfikacje partycji, lista migawek, aktualna migawka, właściwości.
- Migawka (snapshot) — stan tabeli w jednej chwili; wskazuje jedną listę manifestów.
- Lista manifestów — które manifesty składają się na migawkę, z podsumowaniem partycji (żeby pominąć całe manifesty bez ich otwierania).
- Manifest — plik Avro wyliczający pliki danych i pliki usunięć razem ze statystykami kolumn: minimum, maksimum, liczba wartości pustych.
- Pliki danych i pliki usunięć — Parquet z wierszami; w specyfikacji v3 wektory usunięć w plikach Puffin.
Wszystko w tym drzewie jest niezmienne. Zapis nowej wersji tabeli to zapisanie nowych manifestów, nowej listy i nowego pliku metadanych — a potem atomowa podmiana wskaźnika w katalogu z poprzedniego pliku metadanych na nowy. Katalog jest jedynym elementem, który się zmienia, i jedynym, który musi gwarantować, że dwa procesy nie podmienią wskaźnika naraz. Silnik, który chce pisać, bierze aktualny wskaźnik, buduje nową wersję i próbuje podmienić; jeśli ktoś go uprzedził, powtarza na nowym stanie.
Dla firmy wynika z tego jedno: kto prowadzi katalog, ten prowadzi tabele. Dlatego w Icebergu katalog nie jest dodatkiem, tylko częścią architektury, i dlatego społeczność opisała go otwartym interfejsem — specyfikacją katalogu REST (OpenAPI): przestrzenie nazw, tabele, widoki, commity i transakcje, planowanie skanów, wydawanie poświadczeń do danych. Każdy silnik rozmawia z katalogiem tym samym językiem, a katalog może być Waszym Apache Polaris albo Lakekeeper, albo katalogiem Snowflake, Databricks, AWS czy Google.
Co odróżnia Iceberg od pozostałych formatów
Aktualne wydanie biblioteki to 1.12.0 z września 2026, specyfikacja tabeli v3 jest przyjęta, v4 w pracach i nieprzyjęta (sprawdzono 21.10.2026, katalog wydań ASF, spec).
| Cecha | Jak działa | Dlaczego ma znaczenie dla firmy |
|---|---|---|
| Ukryte partycjonowanie (hidden partitioning) | partycje wyliczane transformacją z kolumny (np. month(data_faktury)); zapytanie po dacie samo trafia w partycję | analityk nie musi znać układu partycji; koniec z pełnym skanem przez brak WHERE rok = … |
| Ewolucja partycji | nowa specyfikacja partycji dostaje nowy identyfikator, stare dane zostają w starym układzie | zmiana z partycji miesięcznych na dzienne bez przepisywania tabeli |
| Ewolucja schematu po identyfikatorach | kolumna ma trwałe ID, nazwa to etykieta | zmiana nazwy, kolejności, usunięcie i dodanie kolumny bez przepisywania danych i bez „pomylonych kolumn” po zmianie |
| Przycinanie po statystykach | manifesty i lista manifestów niosą minimum/maksimum per kolumna | silnik pomija pliki i całe manifesty bez ich otwierania; taniej w chmurze |
| Migawki, gałęzie i znaczniki | każda wersja to migawka; gałęzie (branches) i znaczniki (tags) nazywają wybrane | „stan na zamknięcie miesiąca” jako znacznik, nie kopia tabeli |
| Specyfikacja v3 | wektory usunięć w Puffin, pochodzenie wierszy (row lineage), typy VARIANT, geometry, geography, wartości domyślne kolumn, znaczniki czasu w nanosekundach | tańsze usunięcia, audyt „skąd ten wiersz”, dane półstrukturalne bez spłaszczania |
| Katalog REST | otwarty interfejs HTTP dla wszystkich operacji na katalogu, z wydawaniem poświadczeń do danych | silnik można wymienić, nie wymieniając katalogu; katalog można wymienić, nie przenosząc danych |
Kto to czyta i pisze — według dokumentacji platform na 21.10.2026: Snowflake obsługuje tabele Iceberg w wersjach v1–v3 z katalogiem własnym albo zewnętrznym przez REST; AWS S3 Tables to magazyn z wbudowanym Icebergiem, w tym v3, z automatycznym kompaktowaniem; Google BigQuery ma zarządzane tabele Iceberg i katalog REST z wydawaniem poświadczeń; Databricks oferuje zarządzane tabele Iceberg w Unity Catalog i punkt REST; OneLake w Microsoft Fabric przechowuje tabele Iceberg i wirtualizuje metadane do Delta. Po stronie otwartej: Spark, Flink, Trino, Hive, DuckDB i PyIceberg dla zadań poza Sparkiem; katalogi Apache Polaris (od lutego 2026 projekt najwyższego poziomu ASF, wydanie 1.8.0 z września 2026) i Lakekeeper.
Gdzie otwartość zależy od katalogu — i inne pułapki
Otwarty format, zamknięty katalog. Można trzymać dane w Icebergu u vendora, którego katalog nie wystawia interfejsu REST na zewnątrz albo wystawia go z ograniczeniami. Wtedy pliki są Wasze, ale lista tabel, uprawnienia i poświadczenia — nie. Pytanie do vendora brzmi: „czy inny silnik, poza Waszą platformą, może podłączyć się do tego katalogu przez REST i czytać oraz pisać?”. Odpowiedź „tak, do czytania” to połowa odpowiedzi.
Wersje specyfikacji. „Obsługujemy Iceberg” może znaczyć v1 bez plików usunięć, v2 bez wektorów usunięć w Puffin albo v3 w podglądzie. Tabela zapisana w v3 przez Spark może być nieczytelna dla silnika, który zatrzymał się na v2. Przed włączeniem funkcji v3 spiszcie wersje wszystkich czytelników.
Dojrzałość zapisu z różnych silników. Odczyt Icebergu jest powszechny; zapis z wielu silników do tej samej tabeli to trudniejszy przypadek — konflikty, kompaktowanie uruchamiane z dwóch miejsc, różne biblioteki. W praktyce większość firm ma jednego pisarza na tabelę i wielu czytelników. To rozsądna reguła, nie ograniczenie formatu.
Zadania serwisowe. Kompaktowanie małych plików, przepisywanie manifestów, wygaszanie starych migawek i usuwanie osieroconych plików — Iceberg daje procedury, ale ktoś musi je uruchamiać. Usługi vendorów (S3 Tables, Snowflake, BigQuery) robią to za Was w cenie usługi; na własnym stosie to Wasz harmonogram i Wasz koszt.
Usunięcie zgodnie z RODO. DELETE tworzy nową migawkę bez rekordu; stary plik leży do wygaszenia migawki, która go zawiera. Ostateczne usunięcie następuje po wygaszeniu migawek i usunięciu osieroconych plików. Procedura RODO musi liczyć do tego momentu.
Przykład dydaktyczny: grupa handlowa po przejęciu
To przykład ilustracyjny, nie studium klienta — pokazuje mechanizm decyzji, nie wynik wdrożenia. Załóżmy grupę handlowo-dystrybucyjną, około 300 osób, po przejęciu spółki z własnym zespołem analitycznym. Spółka matka ma raporty na Trino na własnym stosie, spółka córka — Snowflake, a nowy zespół AI trenuje modele w Sparku. Każdy ma kopię tabel klientów, faktur i zamówień.
Stan przed. Trzy kopie, trzy procesy ładowania z ERP, trzy definicje „aktywnego klienta”. Zmiana nazwy kolumny w jednej kopii łamie raport w drugiej. Zmiana partycjonowania z miesięcy na dni oznacza przeładowanie dwóch lat historii.
Decyzja. Dane lądują raz, w Icebergu, na własnym magazynie obiektowym w centrum danych w Polsce. Katalog to Apache Polaris z interfejsem REST. Trino czyta przez katalog, Spark pisze i czyta, Snowflake w spółce córce podłącza ten sam katalog jako zewnętrzny. Jeden pisarz na tabelę (Spark), wielu czytelników.
Co robi system. Jedno drzewo metadanych, jedna migawka „zamknięcie miesiąca” oznaczona znacznikiem, do której wracają audyt i zarząd. Ukryte partycjonowanie sprawia, że analityk w Snowflake pisze WHERE data_faktury BETWEEN … i trafia w partycje bez wiedzy o układzie. Zmiana nazwy kolumny jest zmianą etykiety przy trwałym identyfikatorze — żaden raport się nie łamie. Statystyki w manifestach pozwalają pominąć pliki spoza zakresu dat.
Co zostaje przy człowieku. Właściciel tabeli decyduje, kto pisze, a kto czyta, ile migawek trzymamy i kiedy wygaszamy stare (procedura RODO), oraz kto zatwierdza zmianę schematu. Właściciel katalogu odpowiada za uprawnienia i kopię zapasową Polaris — bo bez katalogu drzewo metadanych nie ma korzenia. Dyrektor finansowy zatwierdza jedną definicję aktywnego klienta; Iceberg zapewnia, że wszyscy czytają tę samą tabelę, nie że czytają ją tak samo.
Czym zmierzyć. Liczba kopii tabeli (cel: jedna), liczba procesów ładowania do wyłączenia, czas podłączenia nowego silnika (od decyzji do pierwszego poprawnego zapytania), koszt składowania przed i po, czas realizacji usunięcia RODO do wygaszenia migawki, odsetek zapytań, które pominęły pliki dzięki statystykom. Liczby wpiszecie po kwartale.
Po czym poznać wartość
- Liczba kopii tych samych danych między silnikami. Format działa, gdy spada do jednej.
- Czas podłączenia nowego silnika do istniejących tabel — mierzy otwartość katalogu, nie formatu.
- Koszt składowania po usunięciu kopii i po wygaszeniu starych migawek.
- Czas realizacji usunięcia RODO — do wygaszenia migawki i usunięcia osieroconych plików.
- Odsetek pominiętych plików i manifestów w typowych zapytaniach — pokazuje, czy partycjonowanie i statystyki pracują.
- Koszt zadań serwisowych na terabajt — na własnym stosie to Wasza linia w budżecie.
Mierniki próżności: liczba tabel Iceberg, liczba silników „zgodnych z Icebergiem” na slajdzie vendora, wersja specyfikacji. Uczciwie: na liczbę aktywnych klientów wpływa definicja, nie format — Iceberg daje jedną tabelę, definicję daje zarząd.
Pierwszy krok
W poniedziałek jedna tabela, którą dziś kopiujecie między dwoma zespołami. Katalog REST — Apache Polaris albo Lakekeeper — na próbę, jeden silnik pisze, drugi czyta przez ten sam katalog. Potem trzy testy: zmiana nazwy kolumny, zmiana partycjonowania z miesięcy na dni, odczyt tabeli na wczorajszą migawkę. Jeśli przechodzą na Waszych wersjach silników, macie fundament. Jeśli któryś pada, wiecie po tygodniu, który silnik zatrzymał się na starszej specyfikacji.
Najważniejsze w skrócie
- Iceberg opisuje tabelę niezmiennym drzewem metadanych; jedynym miejscem zmiany jest wskaźnik w katalogu — kto prowadzi katalog, ten prowadzi tabele.
- Ukryte partycjonowanie, ewolucja partycji i schemat po identyfikatorach kolumn pozwalają zmieniać tabelę bez przepisywania danych.
- Specyfikacja v3 dodaje wektory usunięć, pochodzenie wierszy i typ VARIANT; v4 jest w pracach i nieprzyjęta.
- Katalog REST jest otwartą specyfikacją, którą obsługują Snowflake, AWS, Google, Databricks oraz Apache Polaris i Lakekeeper — to on, nie format, decyduje o planie wyjścia.
- Zadania serwisowe i wygaszanie migawek to Wasz koszt na własnym stosie;
DELETEjest ostateczny dopiero po wygaszeniu migawki.
- Dane i analityka
- Open Source AI
- Lakehouse
- Suwerenność
