Apache Hudi: gdy dane zmieniają się co minutę — CDC i masowe aktualizacje bez przepisywania jeziora
Temat: Open Source AI
Hudi powstał z jednego problemu: jak aktualizować pojedyncze rekordy w jeziorze danych tak szybko, jak zmieniają się w systemie źródłowym, bez przepisywania całych partycji. Odpowiedzią są indeks rekordów, oś czasu transakcji i dwa tryby tabel — Copy-on-Write dla czytania i Merge-on-Read dla pisania — z serwisami tabeli, które porządkują dane w tle. Dla firmy oznacza to, że zmiany z ERP przechwycone przez Debezium mogą lądować w tabeli analitycznej w minutach, a usunięcie danych klienta zgodnie z RODO jest operacją po kluczu, nie poszukiwaniem w plikach.
Ten profil pokazuje architekturę Hudi 1.x, w tym nieblokującą kontrolę współbieżności, i uczciwie mówi, kiedy ta maszyneria jest przerostem. Czym w ogóle jest format tabeli i dlaczego pliki Parquet same nie dają aktualizacji, wyjaśnia poradnik o formatach plików i tabel.
Co dziś nie działa
— Klient pyta, czy może jeszcze dziś zamówić za osiemdziesiąt tysięcy. Jaki ma limit? — W hurtowni widzę sto dwadzieścia wolne. — A w ERP? — ERP mówi czterdzieści. Rano zaksięgowali dwie faktury. (Hurtownia jest „z wczoraj”. Handlowiec obiecuje osiemdziesiąt. Dział kredytowy dowie się jutro.)
Dane transakcyjne w ERP i CRM zmieniają się bez przerwy: zamówienie zmienia status, faktura zostaje opłacona, limit maleje, adres klienta się poprawia. Klasyczne jezioro danych dostaje z tego nocny zrzut albo codzienny eksport. Jeżeli ktoś chce odświeżać częściej, musi przepisać całą partycję, bo pliki Parquet są niezmienne: żeby zmienić jeden wiersz w pliku z milionem wierszy, trzeba zapisać nowy plik z milionem wierszy. Przy tysiącach zmian na godzinę ten rachunek nie ma sensu — ani czasowo, ani finansowo.
Druga połowa problemu to „co się zmieniło od ostatniego razu”. Raport należności, który co godzinę przelicza całą historię faktur, bo nie umie wskazać tylko zmienionych rekordów, kosztuje tyle samo przy dziesięciu zmianach, co przy dziesięciu tysiącach. Hudi od początku traktował oba problemy — aktualizację po kluczu i przetwarzanie przyrostowe — jako jedno zadanie.
Architektura: oś czasu, indeks, dwa tryby tabel
Hudi nadaje każdemu rekordowi klucz (record key) i przypisuje go do partycji; rekordy o tym samym kluczu zawsze trafiają do tej samej grupy plików (file group). Nad tym działają trzy mechanizmy.
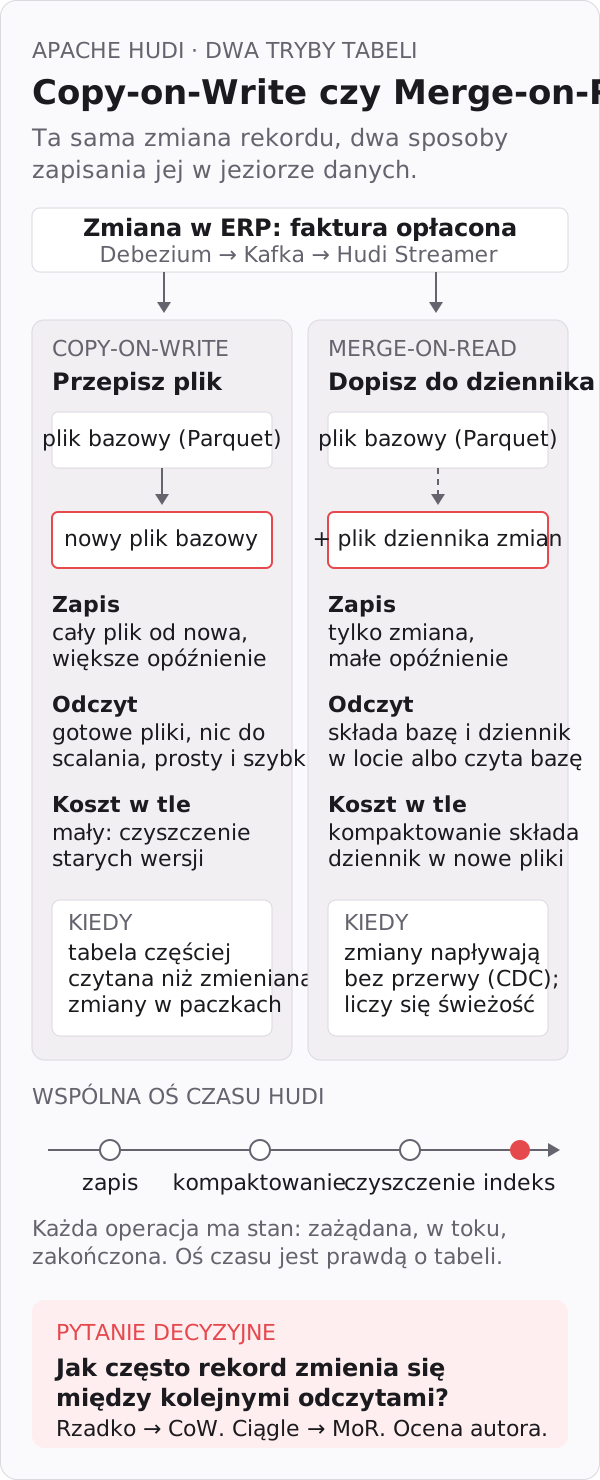
Oś czasu (timeline). Każda operacja na tabeli — commit, deltacommit, kompaktowanie, klastrowanie, czyszczenie, przywrócenie — jest zdarzeniem na osi czasu z trzema stanami: zażądane, w toku, zakończone. Oś czasu jest tym, czym dla Delta Lake jest log, a dla Iceberga drzewo manifestów: jedynym źródłem prawdy o tym, które pliki składają się na tabelę. W wydaniach 1.x aktywna oś czasu leży w katalogu .hoodie/timeline, a jej historia jest archiwizowana w strukturze LSM (Parquet z manifestami), żeby długie tabele nie dusiły się własną historią. Operacje porządkowane są po czasie zakończenia, co ma znaczenie przy wielu pisarzach.
Indeks rekordów. Żeby aktualizować po kluczu, trzeba szybko wiedzieć, w którym pliku leży stara wersja. Hudi trzyma w tabeli metadanych kilka indeksów naraz: filtr Blooma na plik, indeks rekordów (record-level index, globalny lub partycjonowany), a od wydania 1.0.0 także indeksy wtórne (secondary), indeksy wyrażeń (expression) i statystyki partycji. Po stronie pisarza dostępne są też strategie SIMPLE (domyślna), BUCKET, HBASE i FLINK_STATE. W praktyce dla tabel z CDC indeks rekordów jest tym, co odróżnia „minuty” od „godzin”.
Dwa tryby tabel. Copy-on-Write (CoW) przepisuje plik bazowy Parquet przy każdej zmianie grupy plików; nie ma plików dziennika, odczyt jest prosty. Merge-on-Read (MoR) dopisuje zmiany do plików dziennika obok pliku bazowego; odczyt migawkowy scala je w locie, a kompaktowanie co jakiś czas tworzy nowy plik bazowy. MoR ma mniejsze opóźnienie zapisu, CoW szybszy odczyt. Oba tryby obsługują trzy rodzaje zapytań: migawkowe (snapshot), przyrostowe (incremental — ostatni stan albo CDC z obrazem przed i po) oraz, dla MoR, zoptymalizowane pod odczyt (read-optimized), które czytają tylko pliki bazowe.
Co Hudi robi inaczej niż Delta i Iceberg
Aktualne wydanie to Hudi 1.2.1 z 25 września 2026 (wersja tabeli 9); 1.2.0 z maja 2026 dodało typy VECTOR, VARIANT i BLOB oraz Flink Source V2, a 1.0.0 z grudnia 2024 przebudowało oś czasu i indeksy (sprawdzono 21.10.2026).
| Cecha | Co daje w praktyce |
|---|---|
| Upsert i usunięcie po kluczu z indeksem rekordów | zmiana jednego klienta nie przepisuje partycji; usunięcie RODO jest operacją po kluczu |
| Zapytania przyrostowe i CDC z tabeli | raport należności przelicza tylko to, co zmieniło się od ostatniego uruchomienia |
| Precombine i deduplikacja przy zapisie | dwa zdarzenia o tym samym kluczu w jednej paczce — wygrywa to z wyższym znacznikiem, bez kodu w zadaniu |
| Nieblokująca kontrola współbieżności (NBCC) | kilka pisarzy do jednej tabeli MoR bez blokad na danych; blokada tylko na metadane osi czasu; wymaga indeksu kubełkowego i na dziś nie działa z klastrowaniem |
| Serwisy tabeli: kompaktowanie, klastrowanie, czyszczenie, indeksowanie | porządek w tle, ale z kosztem i właścicielem |
| Hudi Streamer | gotowy ingest z Kafki, Debezium, JDBC, Pulsar, Kinesis, zdarzeń S3/GCS, w trybie ciągłym, z rejestrem schematów |
Delta Lake i Iceberg dogoniły Hudi w aktualizacjach dzięki wektorom usunięć i MERGE, ale wciąż traktują zmianę rekordu jak wyjątek od reguły „pliki się dopisuje”. Hudi traktuje ją jak codzienność — i płaci za to większą liczbą ruchomych części.
Przykład dydaktyczny: dystrybutor B2B i limit kredytowy „na teraz”
To przykład ilustracyjny, nie studium klienta — firma i liczby są umowne, mechanizm jest prawdziwy. Załóżmy dystrybutora B2B zatrudniającego około 150 osób, z ERP jako księgą zamówień, faktur i płatności, oraz z CRM, w którym handlowcy widzą klientów. Zarząd chce dwóch rzeczy: raportu należności i limitów kredytowych aktualnego do kilku minut oraz agenta AI, który ostrzeże handlowca, zanim obieca towar klientowi po limicie.
Stan przed. Hurtownia ładowana nocą z pełnego eksportu ERP. Raport należności przelicza co rano całą historię faktur. Limit „na teraz” handlowcy sprawdzają w ERP ręcznie albo w arkuszu, który ktoś prowadzi obok. Żądania usunięcia danych klienta trafiają do IT jako zadanie na kilka dni, bo trzeba odnaleźć wiersze w plikach z kilku lat.
Co robi system. Debezium czyta dziennik zmian baz ERP i CRM i publikuje zdarzenia do Kafki. Hudi Streamer w trybie ciągłym zapisuje je do tabel Merge-on-Read: faktury, platnosci, zamowienia, klienci, z kluczem rekordu równym identyfikatorowi z ERP i precombine po znaczniku czasu zmiany. Indeks rekordów wskazuje, który plik dziennika dostaje zmianę; kompaktowanie co ustalony czas składa dziennik w pliki bazowe. Raport należności czyta zapytaniem przyrostowym tylko faktury i płatności zmienione od ostatniego przebiegu i aktualizuje saldo klienta. Agent limitów czyta ten sam przyrost i kładzie handlowcowi na biurku ostrzeżenie: „klient X — wykorzystanie limitu po dzisiejszych fakturach”. Żądanie RODO to DELETE po kluczu klienta w tabelach z danymi osobowymi; czyszczenie (cleaning) po okresie retencji usuwa stare wersje plików, więc rekord znika także z historii.
Co zostaje przy człowieku. Decyzję o podniesieniu limitu albo o wyjątku dla stałego klienta podejmuje dział kredytowy, nie agent. Właściciel tabeli klienci ustala retencję wersji i podpisuje się pod tym, że po czyszczeniu dane usunięte nie są odtwarzalne. Wybór między CoW i MoR dla każdej tabeli to decyzja architekta, zapisana z uzasadnieniem.
Czym to zmierzyć. Opóźnienie od zmiany w ERP do widoczności w tabeli (cel: minuty, nie noc). Koszt przeliczenia raportu należności: przyrost zamiast pełnego przebiegu — porównajcie czas i rachunek za obliczenia przed i po. Czas realizacji żądania usunięcia od zgłoszenia do potwierdzenia. Koszt serwisów tabeli (kompaktowanie, czyszczenie) na terabajt — to stała cena MoR i ma być znana. Z perspektywy całkowitego kosztu posiadania (TCO) porównujecie: nocny pełny eksport i ręczny arkusz limitów kontra Debezium, Kafka, Hudi Streamer i serwisy tabeli — plus wartość decyzji kredytowej podjętej na danych z dzisiaj, a nie z wczoraj.
Gdzie Hudi zaszkodzi
Więcej ruchomych części. Indeksy, dwa tryby tabel, serwisy tabeli, Hudi Streamer — każdy element ma konfigurację i tryb awarii. Hudi bez właściciela tabeli i bez monitoringu kompaktowania po kilku miesiącach ma tabele MoR z dziennikiem, którego nikt nie składa, i odczytem, który z każdym tygodniem jest wolniejszy.
Rzadkie zmiany nie potrzebują Hudi. Jeśli dane z ERP wystarczy odświeżać raz dziennie, a aktualizacji jest kilkaset, MERGE w Delta Lake albo Icebergu z wektorami usunięć załatwia sprawę mniejszym nakładem. Hudi opłaca się wtedy, gdy zmian jest dużo i mają docierać szybko.
Wsparcie w platformach vendorów. Snowflake, Fabric, BigQuery czytają natywnie Delta i Iceberg; Hudi w tych platformach wymaga Apache XTable, a XTable nie obsługuje dziś tabel MoR. Jeśli raporty mają powstawać w takiej platformie, zaprojektujcie ścieżkę odczytu, zanim wybierzecie Hudi — albo wybierzcie co innego. Porównanie trzech formatów według tych samych kryteriów znajdziecie w tekście Delta Lake, Apache Iceberg czy Apache Hudi?.
Klucz i tryb decydują o wszystkim. Zły klucz rekordu (np. taki, który zmienia się w ERP) albo zły wybór trybu to przebudowa tabeli, nie zmiana parametru.
Po czym poznać wartość
Metryki próżności: liczba tabel Hudi, liczba zdarzeń z Debezium, rozmiar jeziora. Mierniki wyniku:
- Opóźnienie ERP → tabela dla kluczowych obiektów (faktura, płatność, limit).
- Koszt przeliczeń: udział zapytań przyrostowych w stosunku do pełnych przebiegów i rachunek za obliczenia przed i po.
- Czas realizacji żądania usunięcia od zgłoszenia do potwierdzenia, że rekord zniknął również z historii.
- Koszt serwisów tabeli na terabajt — stały, znany, raportowany.
- Liczba decyzji kredytowych podjętych na danych starszych niż godzina — jeśli potraficie ją zmierzyć, to jest Wasza prawdziwa miara.
Na te liczby wpływa też jakość danych w ERP, dyscyplina kompaktowania i to, czy dział kredytowy w ogóle chce dostawać ostrzeżenia. Format tabeli nie naprawi procesu, którego nikt nie prowadzi.
Pierwszy krok
Weźcie jedną tabelę z ERP, o którą ludzie dzwonią do IT: faktury albo limity. Uruchomcie Debezium na tej jednej tabeli źródłowej, Hudi Streamer w trybie ciągłym do tabeli Merge-on-Read, jeden raport przyrostowy. Zmierzcie opóźnienie i koszt przez dwa tygodnie. Jeśli dział kredytowy zacznie patrzeć w ten raport zamiast w arkusz — macie uzasadnienie dla kolejnych tabel. Jak czytać zmiany z baz, opisuje profil Debezium.
Najważniejsze w skrócie
- Hudi rozwiązuje dwa problemy jednocześnie: aktualizację rekordu po kluczu bez przepisywania partycji i przetwarzanie „tylko tego, co się zmieniło”.
- Trzy mechanizmy: oś czasu transakcji (z historią w LSM), indeksy rekordów w tabeli metadanych i dwa tryby tabel — Copy-on-Write pod odczyt, Merge-on-Read pod zapis.
- Hudi Streamer daje gotowy ingest z Kafki i Debezium; NBCC pozwala kilku pisarzom pracować na jednej tabeli MoR bez blokad na danych.
- Usunięcie zgodne z RODO to operacja po kluczu, ale dane znikają z historii dopiero po czyszczeniu starych wersji — retencję podpisuje właściciel tabeli.
- Cena: więcej ruchomych części, słabsze natywne wsparcie w platformach vendorów, konieczność dobrego klucza i trybu. Przy rzadkich zmianach wystarczy
MERGEw Delta albo Icebergu.
- Dane i analityka
- Open Source AI
- Lakehouse
- Change Data Capture
