Co to jest AI OS? Otwarty stos AI – poradnik dla firm
Temat: Open Source AI
AI OS to zestaw warstw technologii, na których działa sztuczna inteligencja w firmie — od serwera i systemu operacyjnego, przez dane i modele, po agentów, uprawnienia i ekran użytkownika — złożony tak, żeby firma kontrolowała najważniejsze z nich. Otwarty AI OS buduje się głównie z oprogramowania open source, które można uruchomić u siebie albo w wybranym centrum danych. Nie jest to produkt z pudełka, tylko architektura i decyzja o tym, kto trzyma klucze do każdej warstwy. Płaci się za nią mniej w licencjach, a więcej w kompetencjach i utrzymaniu.
Poradnik jest dla zarządu i lidera IT firmy od 50 osób, który słyszy o „suwerennej AI” i chce wiedzieć, co to znaczy w praktyce, ile pracy kosztuje i kiedy chmura vendora jest po prostu lepsza. Na końcu jest mapa wszystkich wpisów serii o AI OS, pogrupowanych według warstw. Szerszy kontekst daje przewodnik Open Source AI, a to, jak na takim stosie pracują ludzie i agenci, opisuje strona Inteligentny System Operacyjny Firmy.
Czym jest AI OS: warstwy, które firma kontroluje
System operacyjny komputera łączy sprzęt z programami: przydziela pamięć, pilnuje uprawnień, zapisuje zdarzenia. AI OS robi to samo dla AI w firmie. Łączy procesory i dyski z modelami, modele z danymi firmy, a agentów z ludźmi, którzy zatwierdzają ich pracę.
Różnica polega na tym, że nie ma jednego producenta takiego „systemu”. AI OS składa się z kilkunastu komponentów, z których każdy da się wymienić: inny model, inna baza wektorowa, inny serwer inferencji. Wartość nie leży w żadnym z nich osobno, tylko w tym, że:
- każda warstwa ma właściciela po stronie firmy albo partnera,
- warstwy rozmawiają przez standardowe interfejsy, więc wymiana jednej nie wymusza przepisania pozostałych,
- dane, uprawnienia i ślad działań zostają w miejscu, które wybraliście.
Warto oddzielić dwa pojęcia, które w rozmowach się mieszają. Inteligentny System Operacyjny Firmy to warstwa, w której pracują ludzie i agenci na cyfrowym modelu firmy. AI OS z tego poradnika to stos technologii pod spodem. Ten sam system firmy może stać na otwartym stosie albo na chmurze i oprogramowaniu komercyjnym — rozdział Niezależność systemu opisuje obie drogi i miejsca, w których system może działać.
Po co firmie własny stos AI
Powody są trzy i żaden z nich nie jest ideologiczny.
Suwerenność danych. Obowiązki z RODO i z aktu o AI zostają po stronie firmy niezależnie od tego, gdzie stoją serwery; art. 26 aktu o AI opisuje obowiązki podmiotów stosujących systemy AI wysokiego ryzyka. Własny stos pozwala wskazać dokładnie, gdzie liczą się dane, kto ma do nich dostęp i gdzie zostaje zapis działań agenta. Przy tajemnicy przedsiębiorstwa, danych medycznych czy dokumentacji technicznej to często warunek, a nie preferencja.
Niezależność od vendora. Test jest prosty: czy zmiana cennika, warunków albo wycofanie modelu u jednego vendora wymusza zmianę Waszej strategii? Jeśli tak, część decyzji o firmie podejmuje ktoś inny. Otwarte licencje dają prawa, których nie da się cofnąć jednostronnie — definicja open source zabrania na przykład ograniczania użycia programu do wybranych dziedzin. Prawo do kodu nie wystarczy jednak, jeśli dane i model zostają zamknięte w cudzym formacie.
Koszt w czasie. Usługa w chmurze kosztuje mało na starcie i rośnie z liczbą użytkowników i wywołań. Własny stos kosztuje więcej na początku: sprzęt, wdrożenie, nauka zespołu. Potem koszt zależy głównie od ludzi i energii, a nie od liczby promptów. Która krzywa jest tańsza, zależy od obciążenia — rachunek przy własnych GPU opisuje poradnik NVIDIA AI dla firm.
Dziewięć warstw AI OS od sprzętu do interfejsu
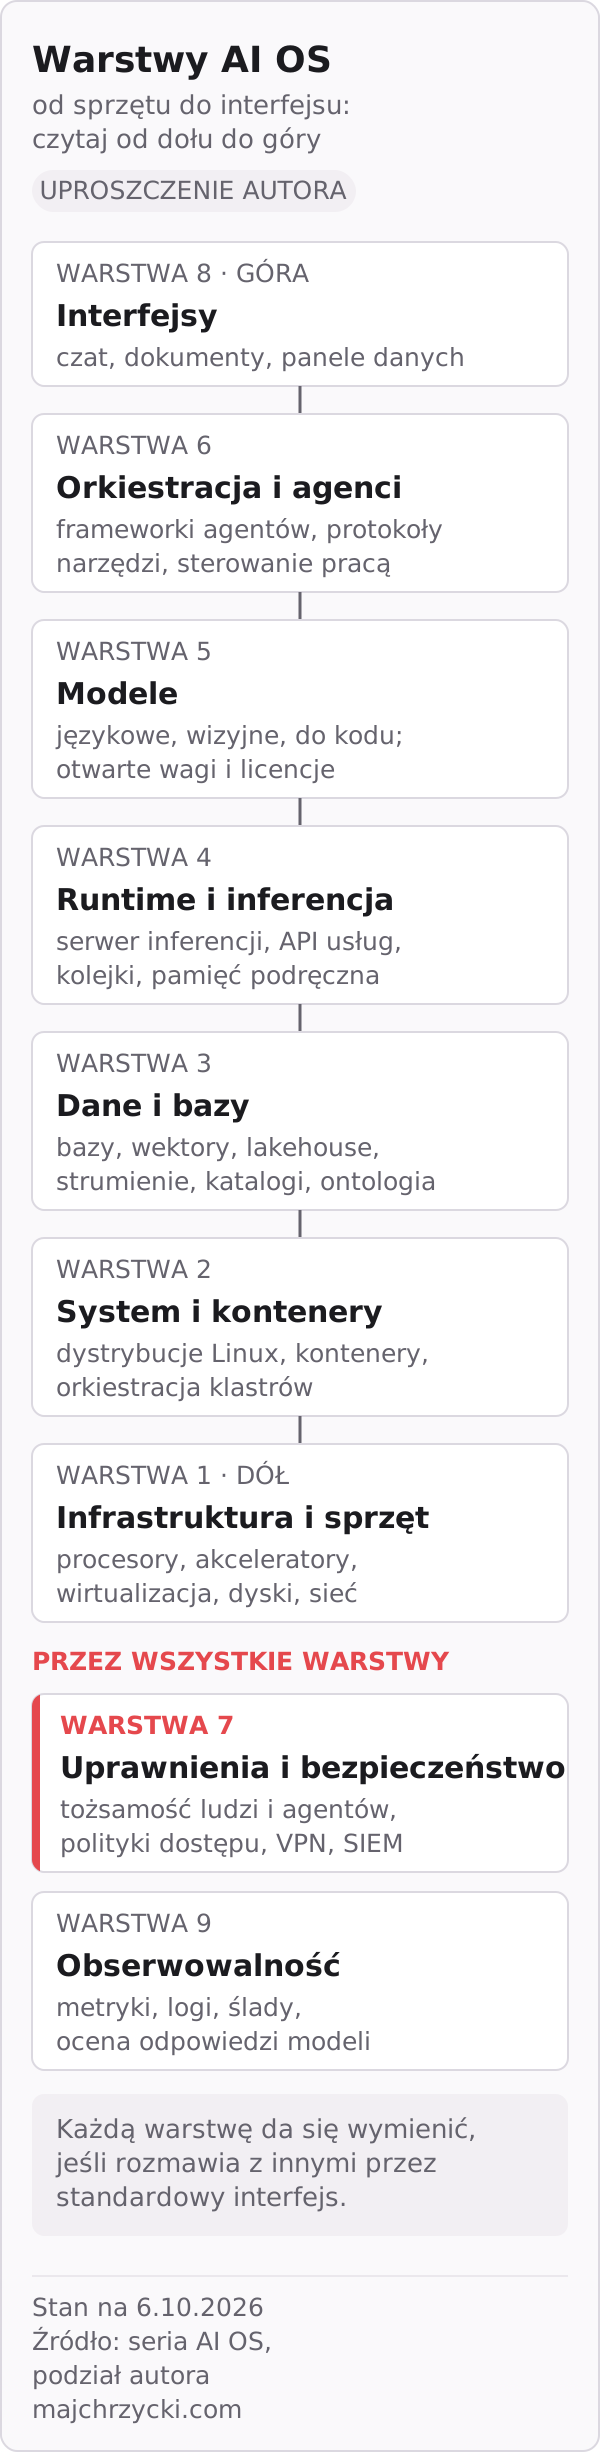
Poniższy podział jest uproszczeniem autora, ale dobrze pokazuje, kto za co odpowiada. Przykłady pochodzą z wpisów serii; to role, nie ranking.
| Warstwa | Rola w systemie | Przykłady z serii | Pytanie dla zarządu |
|---|---|---|---|
| 1. Infrastruktura i sprzęt | procesory, akceleratory, wirtualizacja, dyski, sieć | x64 i Arm64, NVIDIA CUDA, Proxmox VE, XCP-ng, SeaweedFS | gdzie fizycznie liczą się dane? |
| 2. System operacyjny i kontenery | stabilna baza i powtarzalne uruchamianie usług | Debian, Ubuntu, RHEL, Rocky Linux, Kubernetes, K3s, Podman | kto aktualizuje i jak długo trwa wsparcie? |
| 3. Dane i bazy | dane firmy, wektory, strumienie, katalogi, ontologia | PostgreSQL, pgvector, Apache Iceberg, Kafka, Trino, DataHub | czy dane zostają w otwartym formacie? |
| 4. Runtime i inferencja | uruchamianie modeli i usług dla aplikacji | vLLM, ONNX Runtime, FastAPI, Valkey, RabbitMQ | czy model da się wymienić bez zmiany aplikacji? |
| 5. Modele | rozumienie języka, obrazu, kodu | Bielik, PLLuM, Llama, Qwen, DeepSeek, YOLO | na jakiej licencji jest konkretna wersja? |
| 6. Orkiestracja i agenci | planowanie kroków i wywoływanie narzędzi | LangChain Deep Agents, Microsoft Agent Framework, MCP, A2A | co agent może zrobić bez pytania? |
| 7. Uprawnienia i bezpieczeństwo | tożsamość ludzi i agentów, polityki, wykrywanie incydentów | Keycloak, Authentik, Cedar, RBAC/ABAC/ReBAC, WireGuard, Wazuh | czy uprawnienia agenta egzekwuje system, a nie prompt? |
| 8. Interfejsy | miejsce pracy ludzi z AI i dokumentami | Nextcloud, openDesk, LibreOffice, Apache Superset | gdzie pracownik widzi i zatwierdza wynik? |
| 9. Obserwowalność | metryki, logi, ślady i ocena odpowiedzi | OpenTelemetry, Prometheus, Grafana, Langfuse | czy po incydencie odtworzycie, co się stało? |
Infrastruktura, system operacyjny i kontenery
Na dole stoi sprzęt: serwery x64 albo Arm64, akceleratory i dyski. Suwerenność kończy się tu szybciej, niż się wydaje — większość akceleratorów AI wymaga zamkniętych sterowników i bibliotek vendora, co opisuje wpis o NVIDIA i CUDA w AI OS. Nad sprzętem działa Linux, a usługi uruchamia się w kontenerach, zwykle pod Kubernetes.
Ta warstwa ma swój rytm, który trzeba wpisać w budżet. Stan na 6.10.2026: projekt Kubernetes utrzymuje trzy najnowsze wersje minor, każdą z poprawkami przez około rok. Ubuntu LTS ma 5 lat standardowego wsparcia bezpieczeństwa, a w płatnym Ubuntu Pro z dodatkiem Legacy do 15 lat. Debian LTS wydłuża życie wydań stabilnych do co najmniej 5 lat. Wniosek: aktualizacja nie jest projektem raz na kilka lat, tylko stałą pracą w kalendarzu.
Dane i bazy
Tu decyduje się, czy dane firmy są przenośne. Otwarte formaty tabel (Apache Iceberg, Parquet) i bazy na liberalnych licencjach pozwalają zmienić silnik bez migracji danych. Jak złożyć z nich lakehouse i kiedy wystarczy zwykła baza, opisuje poradnik o lakehouse dla firm. PostgreSQL jest wydawany na liberalnej licencji podobnej do BSD i MIT; z rozszerzeniami do wektorów i grafów często wystarcza jako jedna baza dla pierwszych zastosowań — szczegóły zbiera poradnik PostgreSQL dla firm. Na danych stoi warstwa znaczenia, czyli ontologia; opisuje ją poradnik o ontologii firmy.
Runtime, inferencja i modele
Serwer inferencji uruchamia model i wystawia go aplikacjom. vLLM według dokumentacji projektu udostępnia serwer HTTP zgodny z interfejsami API OpenAI. To ważne dla niezależności: aplikacja pisana pod popularny interfejs może przejść z modelu w chmurze na model lokalny przez zmianę adresu, a nie przepisanie kodu.
Modele to warstwa, która zmienia się najszybciej. Seria opisuje polskie modele (Bielik, PLLuM) i modele z otwartymi wagami (Llama, Qwen, DeepSeek). Otwarte wagi nie oznaczają jeszcze open source: definicja Open Source AI 1.0 wymaga dostępu do parametrów, pełnego kodu treningu i uruchomienia oraz wystarczających informacji o danych. Jak dobrać model do zadania, opisuje poradnik o modelach językowych LLM.
Orkiestracja, uprawnienia, interfejsy i obserwowalność
Orkiestracja to warstwa agentów: planuje kroki i wywołuje narzędzia. Narzędzia coraz częściej podłącza się przez Model Context Protocol, otwarty standard łączenia aplikacji AI z systemami zewnętrznymi. Czym agent różni się od asystenta i jak ustawić jego granice, wyjaśnia poradnik o agentach AI.
Uprawnienia i obserwowalność nie są osobnym piętrem, tylko przechodzą przez wszystkie warstwy. Keycloak, projekt w inkubacji Cloud Native Computing Foundation, zarządza tożsamością ludzi i usług. OpenTelemetry zbiera ślady, metryki i logi niezależnie od vendora, ale sam nie jest systemem do ich przechowywania — potrzebuje zaplecza, na przykład Prometheus i Grafana. Interfejsy to miejsce, w którym człowiek widzi wynik i go zatwierdza: czat, dokumenty, panel z danymi. Jak zbudować interfejs aplikacji z agentem — od gotowego czatu po własny ekran zatwierdzeń — opisuje poradnik o stosie AI native.
Model językowy chętnie zaprojektuje Wam cały taki stos w pięć minut. Dostaniecie piętnaście komponentów, ładny diagram i ani jednej osoby, która ma dyżur w sobotę.
Ryzyka otwartego stosu
Utrzymanie. Każdy komponent ma własny cykl wydań, poprawki bezpieczeństwa i koniec wsparcia. Przy kilkunastu komponentach ktoś musi co tydzień sprawdzać, co wymaga aktualizacji, i testować, czy po niej wszystko działa. Bez tego otwarty stos po roku zamienia się w zbiór przestarzałych wersji, których nikt nie odważy się ruszyć.
Kompetencje. Linux, Kubernetes, bazy danych, serwer inferencji i bezpieczeństwo to różne specjalizacje. Firma od 50 osób rzadko ma je wszystkie w zespole. Realne opcje to partner z umową utrzymaniową, wsparcie komercyjne dystrybucji (RHEL, SUSE, Ubuntu Pro) albo ograniczenie liczby warstw, które utrzymujecie sami. Bez nazwanej osoby, która odpowiada za stos, nie zaczynajcie.
Bezpieczeństwo łańcucha dostaw. Otwarty kod można sprawdzić, ale ktoś musi to robić. OWASP opisuje w LLM03:2025 Supply Chain ryzyka podatnych zależności, zatrutych modeli i niezaufanych komponentów. Każdy pobrany model i obraz kontenera to zależność, którą trzeba wersjonować, skanować i móc wycofać.
Licencje. Licencje różnią się obowiązkami. AGPLv3 wymaga udostępnienia kodu zmodyfikowanej wersji użytkownikom, którzy korzystają z niej przez sieć — to istotne, gdy firma udostępnia zmieniony serwer AI klientom. Kryteria oceny licencji zbiera poradnik o licencjach open source; ocenę konkretnej umowy zostawcie prawnikowi.
Otwarty stos czy chmura vendora?
Uczciwie: dla wielu firm chmura vendora jest lepszym wyborem, przynajmniej na start. Jest szybsza do uruchomienia, zgodność i wsparcie przychodzą razem z umową, a vendorzy oferują regiony w UE i warianty uruchamiane lokalnie. Prawo też idzie w stronę łatwiejszej zmiany: Data Act stosuje się od 12 września 2025 r. i wprowadza ramy przenoszenia się klientów między usługami przetwarzania danych w chmurze.
| Kryterium | Za otwartym stosem | Za chmurą vendora |
|---|---|---|
| Dane | nie mogą opuścić firmy albo kraju | mogą być przetwarzane w regionie UE vendora |
| Obciążenie | stałe i przewidywalne | małe, zmienne albo nieznane |
| Zespół | jest osoba lub partner do utrzymania i dyżuru | brak ludzi do utrzymania infrastruktury |
| Modele | wystarczają modele, które da się uruchomić u siebie | potrzebne są modele dostępne tylko przez API |
| Ekosystem | systemy firmy są rozproszone albo otwarte | zespół już pracuje w jednym ekosystemie, np. Microsoft |
| Czas | jest czas na pilot i naukę zespołu | wynik potrzebny w kilka tygodni |
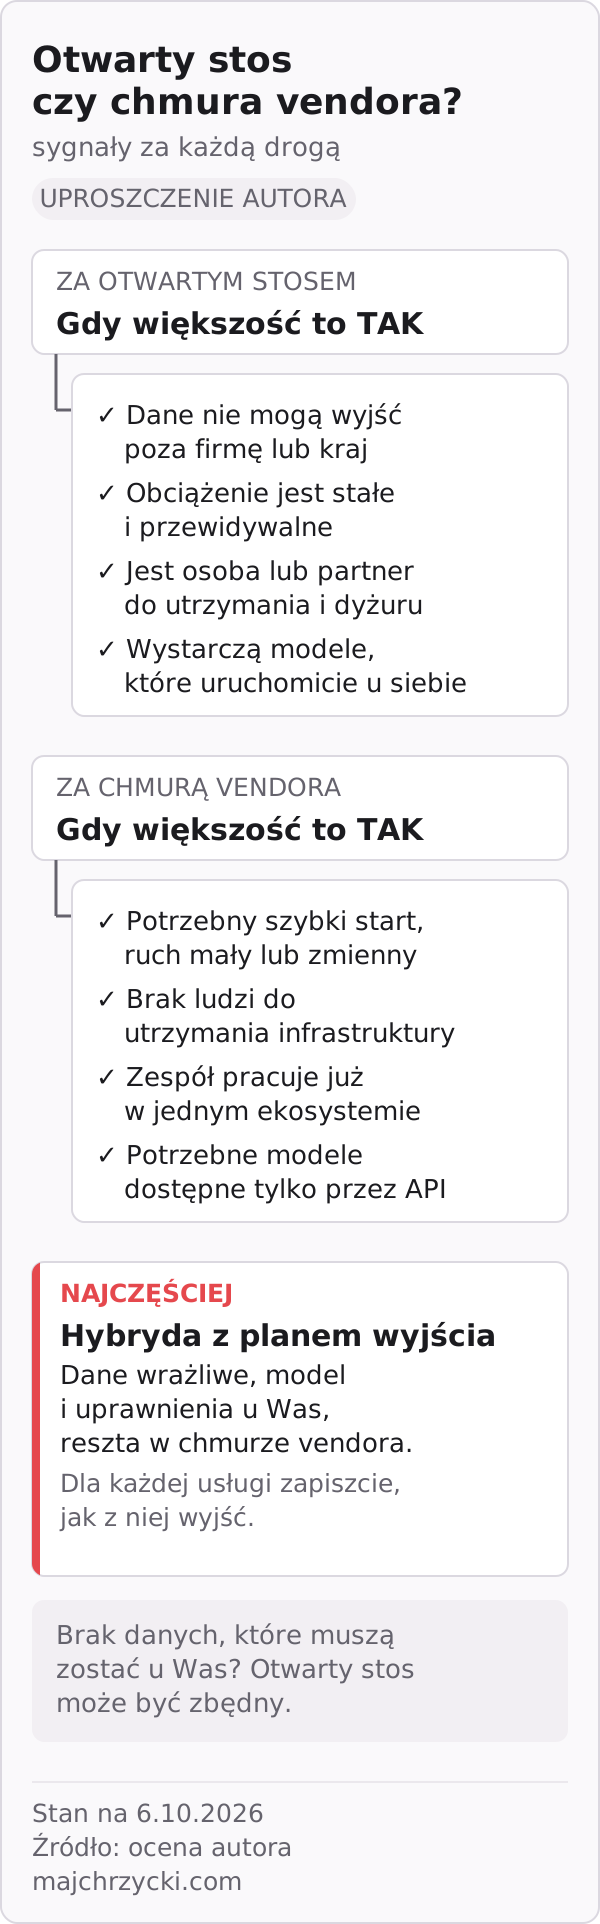
W praktyce najczęściej wygrywa hybryda. Dane wrażliwe, model, który musi zostać u Was, i uprawnienia stoją na otwartym stosie; poczta, dokumenty i część analityki zostają w chmurze vendora. Warunek jest jeden: dla każdej usługi zapisujecie od pierwszego dnia, jak z niej wyjść. Suwerenność nie polega na tym, żeby wszystko robić samemu, tylko na tym, żeby móc zmienić zdanie.
Jak zacząć: jedna warstwa, jeden proces, plan wyjścia
Krok 1. Nazwijcie dane, które nie mogą wyjść. Zacznijcie od klasyfikacji: które dokumenty i rekordy nie mogą trafić do chmury vendora ani poza kraj. Jeśli takich danych nie ma, otwarty stos może być zbędny — i to też jest dobra odpowiedź.
Krok 2. Wybierzcie warstwy do kontroli. Rzadko trzeba kontrolować wszystkie dziewięć. Najczęściej wystarczą dane, model i uprawnienia. Pozostałe warstwy mogą być usługą, jeśli mają standardowy interfejs.
Krok 3. Pilot na jednym procesie. Jeden proces, w którym wynik da się sprawdzić, na wynajętym serwerze w Polsce lub w UE: baza z danymi, serwer inferencji z jednym modelem, interfejs i zapis działań. Mierzcie jakość odpowiedzi, czas obsługi sprawy i godziny pracy zespołu przy utrzymaniu — porównajcie to z tym samym procesem w chmurze vendora.
Krok 4. Zapiszcie plan wyjścia i właściciela. Dla każdej warstwy: kto ją utrzymuje, jak często aktualizuje, w jakim formacie są dane i ile pracy wymaga zmiana komponentu. Dopiero z tą kartą decydujcie o zakupie sprzętu.
Jeśli po kroku 1 nie wiecie, które dane muszą zostać w firmie, albo nikt nie chce podpisać się pod utrzymaniem stosu, problem nie leży w wyborze technologii. Wtedy pomaga rozmowa zarządu o tym, co firma naprawdę musi kontrolować. Na tym polega prezentacja dla zarządu: nazwiemy dane, warstwy i koszt utrzymania, niezależnie od vendora i partnera.
Mapa wpisów o otwartym AI OS
Wszystkie wpisy serii o otwartym, suwerennym stosie AI, pogrupowane według warstw. Zacznijcie od warstwy, o którą pytacie, i od wpisów o suwerenności sprzętowej oraz o wyborze partnera.
1. Infrastruktura i sprzęt
Procesory, akceleratory, wirtualizacja, przechowywanie danych, sieć i automatyzacja centrum danych oraz zarządzane platformy do porównania.
- Suwerenność sprzętowa AI OS w Europie: plan bez złudzeń
- x64 i Arm64 w AI OS: dojrzałość kontra zależności
- RISC-V 64 w Europie: otwarta ISA, trudna droga do AI
- LoongArch64 i AArch64 w Chinach: dwie różne drogi
- NVIDIA i CUDA w AI OS: wydajność i koszt zależności
- Graphcore IPU i Poplar: europejski projekt, obca kontrola
- Huawei Ascend i CANN: chiński stos AI a suwerenność UE
- Proxmox VE: wirtualizacja dla prywatnego AI OS
- XCP-ng: Xen jako suwerenny hypervisor dla AI OS
- Pacemaker i Corosync: HA dla usług AI OS
- Apache Ozone w suwerennym AI OS
- SeaweedFS w suwerennym AI OS
- RustFS w suwerennym AI OS
- Ansible w suwerennym datacenter: konfiguracja jako kod
- Semaphore UI: panel uruchamiania automatyzacji AI OS
- Nginx w suwerennym AI OS
- Caddy w suwerennym AI OS
- Apache HTTP Server w suwerennym AI OS
- Cloudflare Platform w suwerennym AI OS
- Vercel Agentic Infrastructure w suwerennym AI OS
2. Systemy operacyjne Linux i kontenery
Dystrybucje serwerowe i stanowiskowe, cykle wsparcia oraz uruchamianie usług w kontenerach.
- Debian w suwerennym AI OS: stabilna baza pod własne modele
- Debian w lokalnym centrum danych AI OS
- Ubuntu w AI OS: wygodna baza dla GPU i zespołów AI
- Red Hat Enterprise Linux w AI OS: wsparcie i kontrola
- Rocky Linux w AI OS: społecznościowa baza enterprise
- SUSE Linux Enterprise w AI OS: kontrola środowiska hybrydowego
- Fedora Linux w AI: szybkie eksperymenty, świadomy cykl zmian
- Slackware Linux w AI OS: maksymalna kontrola, wysoki koszt pracy
- Kali Linux w AI OS: narzędzie audytu, nie serwer modeli
- Omarchy: Linux jako stanowisko pracy z agentami AI
- Azure Linux w AI OS: host kontenerów pod kontrolą Azure
- Google Linux w AI OS: COS i gLinux to różne systemy
- Docker w suwerennym AI OS
- Podman w suwerennym AI OS
- Kubernetes w suwerennym AI OS
- K3s w suwerennym AI OS
- OKD w suwerennym AI OS
- Rancher w suwerennym AI OS
- Headlamp w suwerennym AI OS
- Portainer CE w suwerennym AI OS
3. Dane i bazy
Najliczniejsza grupa: bazy, analityka, lakehouse, przepływy danych, katalogi i warstwa znaczenia. Podgrupy idą od miejsca zapisu do opisu znaczenia danych.
Bazy operacyjne, wektorowe i wyszukiwanie:
- PostgreSQL w suwerennym AI OS
- PostgreSQL JSONB w suwerennym AI OS
- pgvector w suwerennym AI OS
- Apache AGE w suwerennym AI OS
- PostgresML w suwerennym AI OS
- Supabase w suwerennym AI OS
- WarehousePG w suwerennym AI OS
- Chroma w suwerennym AI OS
- Elasticsearch w suwerennym AI OS
- OpenSearch w suwerennym AI OS
Analityka i hurtownie:
- ClickHouse w suwerennym AI OS
- DuckDB w suwerennym AI OS
- StarRocks w suwerennym AI OS
- Apache Doris w suwerennym AI OS
- Apache Druid w suwerennym AI OS
- Databend w suwerennym AI OS
- Dremio OSS w suwerennym AI OS
- Trino w suwerennym AI OS
- BigQuery w suwerennym AI OS
- Snowflake w suwerennym AI OS
- Amazon Redshift w suwerennym AI OS
Lakehouse i formaty:
- Apache Iceberg: fundament suwerennego lakehouse
- PyIceberg w suwerennym AI OS
- Apache Parquet w suwerennym AI OS
- Delta Lake w suwerennym AI OS
- OpenUSD w suwerennym AI OS
Przetwarzanie i przepływy danych:
- Apache Spark w suwerennym AI OS
- Apache DataFusion w suwerennym AI OS
- DataFusion Comet w suwerennym AI OS
- Daft w suwerennym AI OS
- Apache Kafka w suwerennym AI OS
- Apache Flink w suwerennym AI OS
- Debezium w suwerennym AI OS
- Apache Airflow w suwerennym AI OS
- Apache Hop w suwerennym AI OS
- dbt Core w suwerennym AI OS
- SQLMesh w suwerennym AI OS
Katalogi, pochodzenie danych i governance:
- DataHub w suwerennym AI OS
- OpenMetadata w suwerennym AI OS
- Apache Atlas w suwerennym AI OS
- OpenLineage w suwerennym AI OS
- Unity Catalog w suwerennym AI OS
- Apache Polaris w suwerennym AI OS
- Lakekeeper: dostęp agentów AI
Semantyka i ontologia:
- Ontologia AI OS: semantyka, działania i decyzje
- RDF, OWL 2 i SHACL: standardy ontologii AI OS
- Protégé Desktop i WebProtégé: ontologia dla AI OS
- Apache Jena TDB2 w suwerennym AI OS
- Eclipse RDF4J ShaclSail w suwerennym AI OS
- Apache Ossie w suwerennym AI OS
- Cube Core w suwerennym AI OS
- dbt Semantic Layer w suwerennym AI OS
- Open Knowledge Format: wiedza firmy w plikach
4. Runtime i inferencja
Uruchamianie modeli, API usług, kolejki zadań i pamięć podręczna.
- vLLM w suwerennym AI OS
- ONNX Runtime w suwerennym AI OS
- FastAPI w suwerennym AI OS
- Node.js w suwerennym systemie AI: rola runtime
- Valkey w suwerennym AI OS
- RabbitMQ w suwerennym AI OS
- Celery w suwerennym AI OS
5. Modele
Polskie modele, modele z otwartymi wagami, katalog modeli i widzenie komputerowe.
- Bielik: polski model dla suwerennego AI
- PLLuM: polski model dla administracji i firm
- Llama od Meta: własne wdrożenie modelu AI
- Qwen od Alibaba: kodowanie i własny hosting
- DeepSeek: otwarte modele do kodu i analityki
- Hugging Face: modele i narzędzia AI dla firmy
- Ultralytics YOLO w suwerennym AI OS
6. Orkiestracja, agenci i protokoły
Frameworki agentów, płaszczyzna sterowania i protokoły łączące agentów z narzędziami, innymi agentami i sklepem.
- LangChain Deep Agents w suwerennym AI OS
- Microsoft Agent Framework po AutoGen i Semantic Kernel
- Paperclip w suwerennym AI OS
- Model Context Protocol w suwerennym AI OS
- Agent2Agent A2A w suwerennym AI OS
- Universal Commerce Protocol UCP w suwerennym AI OS
7. Uprawnienia i bezpieczeństwo
Modele uprawnień agentów, tożsamość, dostęp sieciowy i obsługa incydentów. Jak ustawić tożsamość, polityki, zatwierdzenia i audyt agenta niezależnie od narzędzia, opisuje poradnik o uprawnieniach agentów AI.
- RBAC: dostęp agentów AI
- ABAC: dostęp agentów AI
- ReBAC: dostęp agentów AI
- Cedar Policy: dostęp agentów AI
- Keycloak w AI OS: tożsamość ludzi i agentów
- Authentik w AI OS: SSO i brama do starszych aplikacji
- Authelia: lekka kontrola dostępu przed panelem AI
- Casdoor: SSO z interfejsem dla aplikacji AI OS
- Univention Nubus: katalog tożsamości dla AI OS
- FreeIPA: tożsamość serwerów Linux pod kontrolą firmy
- WireGuard dla AI OS: bezpieczny tunel, nie cała polityka
- Defguard: WireGuard z tożsamością i kontrolą dostępu
- Wazuh w AI OS: widoczność hostów, alertów i agentów
- TheHive w AI OS: obsługa incydentów i koszt licencji
- Cortex w SOC dla AI OS: analiza i kontrolowana odpowiedź
8. Interfejsy i miejsce pracy
Gdzie ludzie pracują z dokumentami, danymi i asystentem AI.
- Nextcloud: suwerenne dokumenty i współpraca dla AI OS
- Nextcloud Assistant w suwerennym AI OS
- openDesk: suwerenne cyfrowe miejsce pracy
- Euro-Office: europejski edytor dokumentów online
- LibreOffice i ODF: dokumenty bez zależności od licencji
- Apache Superset w suwerennym AI OS
9. Obserwowalność
Ślady, metryki, logi i ocena odpowiedzi agentów — otwarte narzędzia i usługi komercyjne do porównania. Co mierzyć i od czego zacząć, niezależnie od narzędzia, opisuje poradnik o obserwowalności AI.
- OpenTelemetry w suwerennym AI OS
- Prometheus w suwerennym AI OS
- Grafana w suwerennym AI OS
- LGTM w suwerennym AI OS
- ClickStack w suwerennym AI OS
- Langfuse w suwerennym AI OS
- Datadog w suwerennym AI OS
- Splunk w suwerennym AI OS
10. Wytwarzanie na otwartym stosie (AI SDLC)
Języki, notatniki, śledzenie eksperymentów i agenci kodujący, z których zespół buduje moduły AI OS.
- Python w AI SDLC
- Rust w AI SDLC
- TypeScript: kontrakty dla suwerennej aplikacji AI
- Jupyter Notebook w suwerennym AI OS
- MLflow w suwerennym AI OS
- Mistral Vibe w suwerennym AI OS
- LangChain dcode w suwerennym AI OS
11. Licencje i wybór partnera
Przekrój przez wszystkie warstwy: co wolno z kodem i kto pomoże go utrzymać. Zasady zbiera poradnik o licencjach open source.
- Jak wybrać partnera do wdrożenia open source AI?
- Licencja MIT: wolność użycia a suwerenność biznesowa
- Apache 2.0: licencja open source dla firmowego AI
- BSD 2-Clause: prosta licencja dla przenośnego kodu
- BSD 3-Clause: otwarty kod bez prawa do cudzej marki
- MPL 2.0: copyleft na poziomie pliku w firmowym AI
- EPL 2.0: otwarty komponent w ekosystemie enterprise
- LGPLv3: biblioteka otwarta, aplikacja może pozostać własna
- GPLv2: źródła dla odbiorcy i granice suwerenności
- GPLv3: copyleft, patenty i prawo do zmiany urządzenia
- AGPLv3: otwarty serwer AI także przy dostępie przez sieć
12. Poza głównym stosem: rejestry rozproszone i obliczenia kwantowe
Technologie, które dołącza się do AI OS przy konkretnej potrzebie: wspólny zapis między firmami albo eksperymenty z optymalizacją.
- Co to jest blockchain? DLT i Web3 w firmie – poradnik — kiedy wspólny rejestr ma sens, a kiedy wystarczy baza z audytem.
- Hyperledger Fabric: ślad partii między firmami
- Hyperledger Besu: prywatne kontrakty EVM w biznesie
- Corda: poufne transakcje między partnerami AI OS
- Hedera Hashgraph: publiczny znacznik czasu dla AI OS
- Obliczenia kwantowe w firmie: stan na 2026 – poradnik — co komputer kwantowy potrafi dziś i dlaczego kryptografia postkwantowa jest zadaniem na teraz.
- Qiskit: programowanie obwodów kwantowych dla badań AI OS
- Q#: język Microsoftu do programów kwantowych
- D-Wave Ocean SDK: kwantowe eksperymenty z planem fabryki
- QUBO: jak zapisać harmonogram fabryki w bitach
- AI OS
- Open Source AI
- Suwerenność
- Zarząd