Co to jest PostgreSQL? Baza pod AI — poradnik dla firm
Temat: Open Source AI
PostgreSQL to otwarta, relacyjna baza danych, którą firmy coraz częściej wybierają jako warstwę danych dla systemów AI. Powód jest praktyczny: w jednej bazie można trzymać zamówienia, klientów, dokumenty, wektory do wyszukiwania semantycznego (rozszerzenie pgvector) i reguły, kto co może zobaczyć (Row Level Security). Agent AI dostaje wtedy jedno źródło prawdy zamiast trzech systemów do zsynchronizowania. PostgreSQL nie jest jednak odpowiedzią na wszystko: przy bardzo dużej skali wyszukiwania albo ciężkiej analityce potrzebne są inne narzędzia, a bazę trzeba utrzymywać — kopie, wersje, aktualizacje.
Ten poradnik jest dla lidera IT i zarządu firmy od 50 osób, która planuje pierwsze systemy AI na własnych danych. Wyjaśnia, czym jest PostgreSQL, dlaczego pasuje do AI, kiedy wystarczy, a kiedy dołożyć osobną bazę wektorową, oraz jak wybrać między usługą zarządzaną a własną instalacją. Gdzie baza danych stoi w całym systemie, obok modeli, agentów i uprawnień, pokazuje poradnik o AI OS. Szersze tło otwartego stosu daje filar Open Source AI.
Czym jest PostgreSQL
PostgreSQL to relacyjna baza danych rozwijana od lat przez społeczność PostgreSQL Global Development Group. Dane są w tabelach, zapytania pisze się w SQL, a zmiany zapisują się w transakcjach: albo wszystkie, albo żadna. Dla firmy to po prostu solidne miejsce na dane aplikacji — ERP, sklep, CRM, system zgłoszeń.
Trzy cechy mają znaczenie przy decyzji:
- Licencja. PostgreSQL jest wydawany na licencji PostgreSQL License, liberalnej licencji open source podobnej do BSD i MIT. Można go używać, modyfikować i rozpowszechniać w dowolnym celu bez opłat licencyjnych.
- Przewidywalne wersje. Według polityki wersji nowa wersja główna wychodzi mniej więcej raz w roku, każda jest wspierana 5 lat, a wersje poprawkowe z łatkami bezpieczeństwa wychodzą co najmniej raz na trzy miesiące.
- Rozszerzenia. PostgreSQL jest projektowany jako rozszerzalny: rozszerzenie dodaje nowe typy danych i funkcje, które działają jak wbudowane. Tak działają pgvector (wektory), Apache AGE (graf) czy PostGIS (dane przestrzenne).
| Wersja | Status (stan na 6.10.2026) | Koniec wsparcia według projektu |
|---|---|---|
| PostgreSQL 19 | w testach (Beta 4 z 24.09.2026) | — |
| PostgreSQL 18 | aktualna, wersja 18.6 | 14.11.2030 |
| PostgreSQL 17 | wspierana, 17.11 | 8.11.2029 |
| PostgreSQL 16 | wspierana, 16.15 | 9.11.2028 |
| PostgreSQL 15 | wspierana, 15.19 | 11.11.2027 |
| PostgreSQL 14 | wspierana, 14.24 | 12.11.2026 |
Źródło: postgresql.org — Versioning Policy i strona główna projektu. Jeśli firma ma dziś bazy na PostgreSQL 14 albo starszym, to jest pierwsza pozycja na liście zadań — niezależnie od AI.
Dlaczego PostgreSQL pod AI
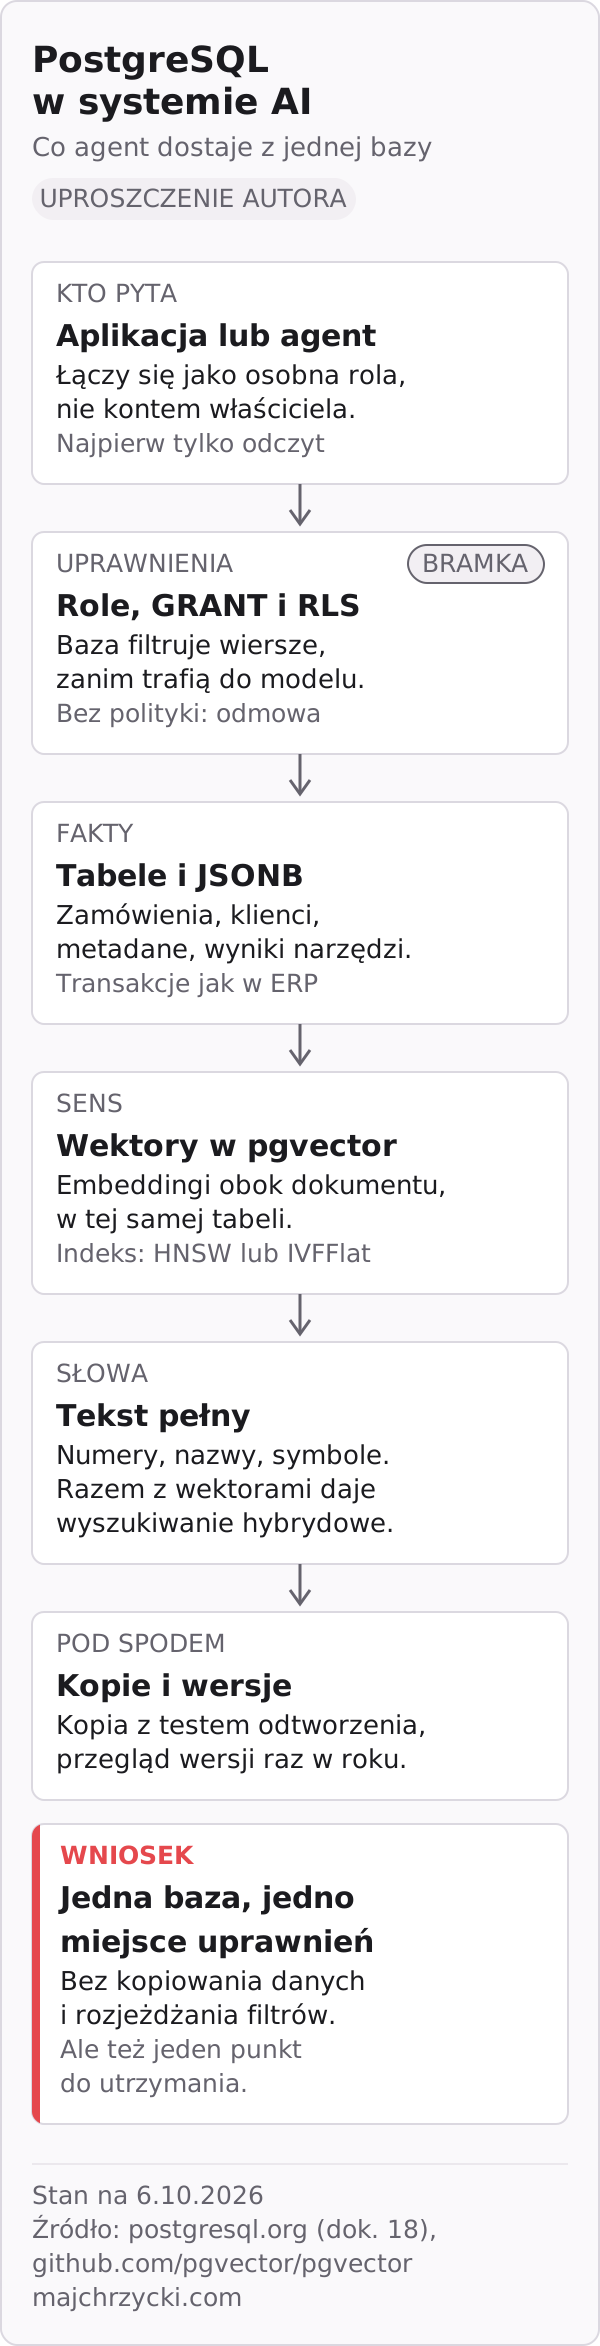
System AI w firmie potrzebuje trzech rzeczy z warstwy danych: faktów (zamówienie, faktura, status), tekstu do wyszukania (procedury, opisy, notatki) i reguł dostępu. W wielu architekturach każda z tych rzeczy trafia do innego systemu: baza transakcyjna, baza wektorowa, osobny mechanizm uprawnień. Każda kopia danych to jednak kolejna synchronizacja, kolejne opóźnienie i kolejne miejsce, gdzie uprawnienia mogą się rozjechać.
PostgreSQL pozwala zebrać to w jednej bazie:
- Dane relacyjne — tabele z kluczami i transakcjami, czyli to, w czym firma już trzyma zamówienia i klientów.
- Dane półstrukturalne — typ JSONB na zmienne metadane dokumentu albo wynik narzędzia agenta, obok zwykłych kolumn.
- Wektory — rozszerzenie pgvector przechowuje embeddingi w tej samej tabeli co dokument i jego metadane, z tymi samymi transakcjami.
- Tekst pełny — wbudowane wyszukiwanie pełnotekstowe znajduje dokumenty po słowach i sortuje je według trafności.
- Relacje jako graf — rozszerzenie Apache AGE pozwala pytać o powiązania klient → zamówienie → zasób językiem openCypher.
- Uprawnienia — role, GRANT i Row Level Security działają na wszystkich powyższych naraz.
pgvector w skrócie
pgvector dodaje do PostgreSQL typ vector i operatory odległości: euklidesowej, kosinusowej, iloczynu skalarnego i kilku innych. Według dokumentacji projektu (stan na 6.10.2026, wersja 0.8.7, PostgreSQL 13 i nowszy) warto znać cztery fakty:
- Domyślnie wyszukiwanie jest dokładne. Baza porównuje pytanie z każdym wektorem. Przy małym zbiorze to wystarcza i daje pełną trafność.
- Indeks przyspiesza kosztem dokładności. HNSW daje lepszy stosunek szybkości do trafności, ale buduje się wolniej i zużywa więcej pamięci. IVFFlat buduje się szybciej i zajmuje mniej pamięci, za to odpowiada słabiej.
- Indeks ma limit wymiarów. Typ
vectorprzechowa do 16 000 wymiarów, ale zindeksuje do 2000; typhalfvec(połowa precyzji) — do 4000. Wymiar embeddingu zależy od wybranego modelu, więc to warto sprawdzić przed wyborem modelu, a nie po. - Filtr działa po indeksie. Przy wyszukiwaniu przybliżonym warunek
WHERE(np. dział, data, klient) jest stosowany po przeszukaniu indeksu, więc wyników może być mniej niż zamówiono. Od wersji 0.8 pomaga iteracyjne skanowanie indeksu, które w takiej sytuacji dociąga kolejnych kandydatów.
Do tego licencja pgvector to także PostgreSQL License. Szczegóły zastosowania w otwartym stosie opisuje wpis pgvector w suwerennym AI OS.
Wyszukiwanie hybrydowe w jednej bazie
Wektory dobrze łapią sens („zwrot towaru” ≈ „reklamacja”), ale gubią dokładne nazwy: numer produktu, symbol normy, nazwisko. Wyszukiwanie pełnotekstowe robi odwrotnie. Dokumentacja pgvector wprost proponuje łączyć oba w wyszukiwaniu hybrydowym i scalać listy wyników, na przykład metodą Reciprocal Rank Fusion albo modelem oceniającym (cross-encoder).
W PostgreSQL oba wyszukiwania działają na tej samej tabeli, z tym samym filtrem uprawnień, w jednym zapytaniu. To jest właściwa przewaga nad układem „baza firmowa + osobna baza wektorowa”, a nie sama szybkość. Jak wyszukiwanie wpisuje się w cały system odpowiedzi z dokumentów firmy, wyjaśnia poradnik o RAG.
Uprawnienia: co widzi agent
Model AI nie wie, kto pyta. Uprawnienia musi pilnować system wokół niego — najlepiej sama baza, zanim jakikolwiek wiersz trafi do kontekstu modelu.
PostgreSQL daje do tego dwa poziomy. Pierwszy to role i GRANT: agent łączy się jako osobna rola z dostępem tylko do potrzebnych tabel i tylko do odczytu, jeśli nie ma niczego zapisywać. Drugi to Row Level Security (RLS): polityki, które dla danego użytkownika ograniczają, które wiersze widzi i które może zmienić. Dzięki RLS jedna tabela dokumentów z wektorami może obsłużyć wiele działów albo klientów, a każdy dostaje tylko swoje wiersze.
Cztery zasady z dokumentacji, które warto znać przed wdrożeniem:
- Po włączeniu RLS bez żadnej polityki obowiązuje domyślna odmowa — nie widać żadnych wierszy. Bezpieczny punkt startu.
- Superużytkownicy i role z atrybutem
BYPASSRLSzawsze omijają RLS. Agent nigdy nie powinien łączyć się takim kontem. - Właściciel tabeli zwykle też omija RLS, chyba że ustawi się
FORCE ROW LEVEL SECURITY. Aplikacja łącząca się kontem właściciela „przechodzi przez ścianę”. - RLS działa dodatkowo do
GRANT, nie zamiast niego.
Agent, któremu na prośbę „pokaż wszystko” baza grzecznie zwraca wszystko, nie jest złośliwy. Po prostu nikt mu nie powiedział, że „wszystko” ma granice. Jak dobrać model uprawnień dla agentów — role, atrybuty czy relacje — porównuje wpis RBAC, ABAC i ReBAC: uprawnienia agentów AI.
Kiedy PostgreSQL, a kiedy osobna baza wektorowa
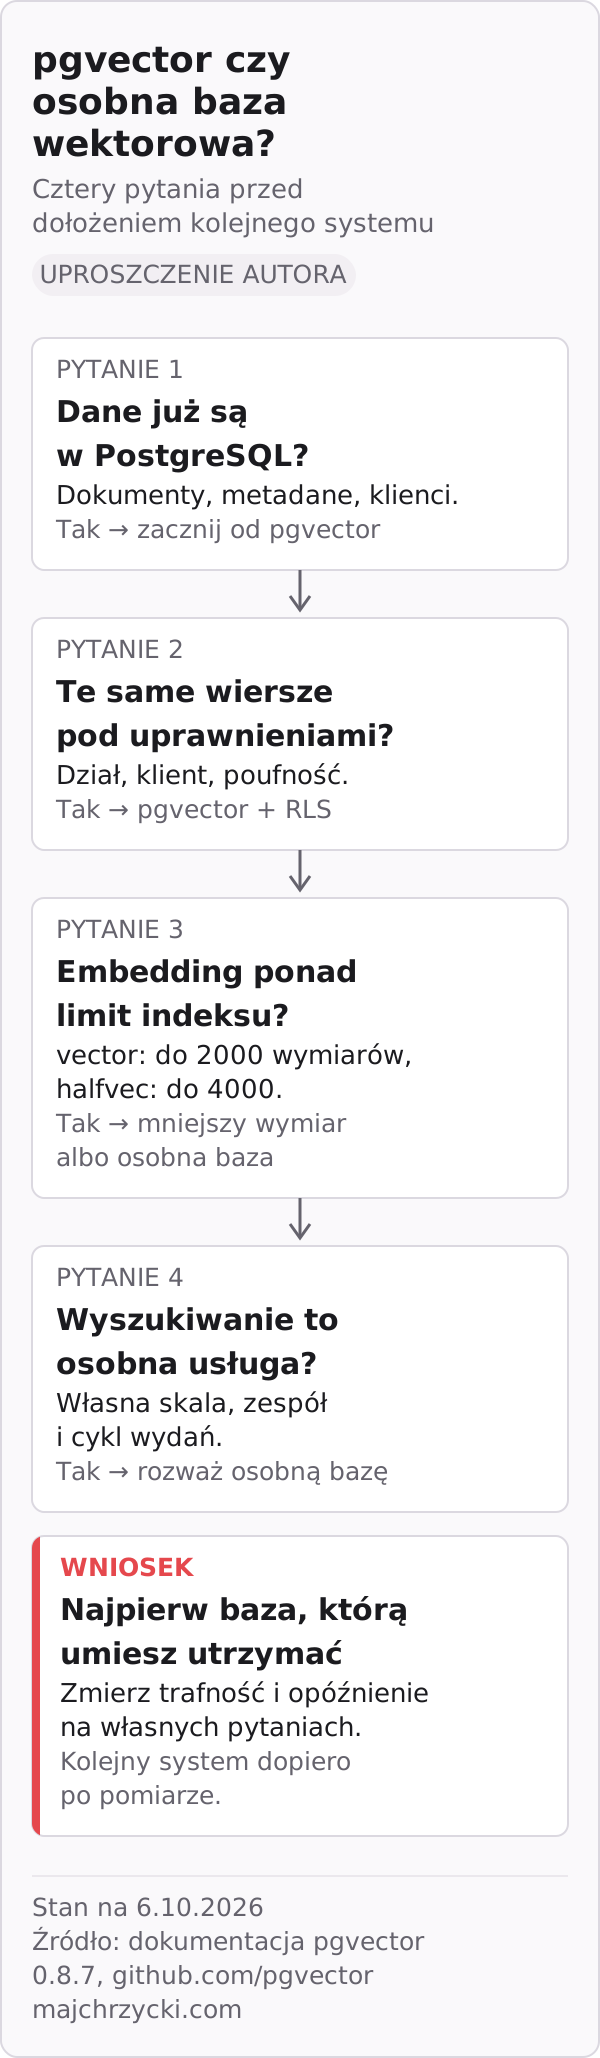
Nie ma jednej odpowiedzi, ale jest rozsądna kolejność: najpierw sprawdzić, czy wystarczy baza, którą firma już ma i umie utrzymać. Osobna baza wektorowa albo wyszukiwarka to kolejny system z własnymi kopiami, uprawnieniami i aktualizacjami. Ma sens, gdy daje coś, czego nie da się uzyskać w PostgreSQL przy rozsądnym nakładzie.
| Sytuacja | Rekomendacja autora |
|---|---|
| Dokumenty, metadane i uprawnienia już są w PostgreSQL | pgvector w tej samej bazie |
| Ten sam wiersz musi podlegać RLS i wyszukiwaniu | pgvector + RLS, bez kopiowania danych |
| Potrzebne słowa kluczowe i sens naraz | wyszukiwanie hybrydowe w PostgreSQL |
| Embedding ma więcej wymiarów niż limit indeksu | halfvec, model z mniejszym wymiarem albo osobna baza |
| Wyszukiwanie to główna usługa z własną skalą, zespołem i cyklem wydań | rozważ osobną bazę wektorową lub wyszukiwarkę |
| Pomiar na własnych danych pokazał, że opóźnienie lub trafność nie wystarczają | porównaj z osobną bazą na tym samym zestawie testowym |
Dwie uwagi do karty. Po pierwsze, porównania wydajności publikowane przez vendorów baz wektorowych mierzą zwykle ich mocne strony — wiarygodny jest tylko test na Waszych dokumentach, z Waszymi filtrami i Waszym modelem embeddingów. Po drugie, osobna baza nie zwalnia z uprawnień: filtr dostępu trzeba wtedy odtworzyć drugi raz i pilnować, żeby nie rozjechał się z bazą źródłową. Przykłady osobnych rozwiązań opisują wpisy Chroma w suwerennym AI OS i OpenSearch w suwerennym AI OS.
Utrzymanie: kopie, wersje i rozszerzenia
Baza pod AI to nadal baza. Wszystko, co dotyczy utrzymania zwykłego PostgreSQL, dotyczy jej w całości, a rozszerzenia dokładają kilka spraw.
Kopie zapasowe. Dokumentacja PostgreSQL opisuje trzy podejścia do kopii: zrzut SQL, kopię na poziomie systemu plików i ciągłą archiwizację (odtworzenie do punktu w czasie). Wybór zależy od tego, ile danych firma może stracić i jak długo może czekać na odtworzenie. Agent kodujący napisze skrypt kopii w minutę i z pełnym przekonaniem ogłosi sukces. Kopia, z której nikt nigdy nie odtworzył bazy, jest jednak tylko hipotezą — test odtworzenia trzeba zrobić i powtarzać.
Wersje. Według dokumentacji aktualizacji wersja poprawkowa nie zmienia formatu danych: wystarczy podmienić program i zrestartować serwer. Wersja główna może zmienić format, więc wymaga zaplanowanej migracji: pg_dumpall, pg_upgrade albo replikacji logicznej, przy której przestój można skrócić do sekund. Raz w roku warto mieć w kalendarzu przegląd wersji, a nie czekać na koniec wsparcia.
Rozszerzenia. Każde rozszerzenie ma własne wersje i musi pasować do wersji PostgreSQL. W usługach zarządzanych lista dozwolonych rozszerzeń i ich wersji jest ustalana przez vendora i bywa starsza niż w repozytorium projektu. Przykład ze stanu na 6.10.2026: projekt pgvector wydał wersję 0.8.7, w tabeli rozszerzeń Amazon RDS najnowsza to 0.8.2, a w Google Cloud SQL — 0.8.5. Jeśli projekt potrzebuje konkretnej funkcji rozszerzenia, sprawdźcie ją w usłudze, zanim podpiszecie architekturę.
Indeksy wektorowe. Zmiana modelu embeddingów oznacza przeliczenie wektorów i przebudowę indeksu. To praca porównywalna z migracją danych, nie z kliknięciem w konfiguracji — trzeba ją ująć w planie utrzymania.
Zarządzany czy własny PostgreSQL
Każdy duży vendor chmury ma usługę zgodną z PostgreSQL. Ich rola jest podobna: vendor przejmuje część utrzymania, firma oddaje część kontroli.
| Usługa | Rola według dokumentacji vendora (stan na 6.10.2026) |
|---|---|
| Azure Database for PostgreSQL | w pełni zarządzana usługa na społecznościowej wersji PostgreSQL; łatanie w oknie serwisowym, automatyczne kopie (domyślnie 7 dni, do 35), wysoka dostępność; pgvector po dodaniu do listy dozwolonych rozszerzeń |
| Amazon RDS for PostgreSQL | zarządzany PostgreSQL z ustaloną listą rozszerzeń, w tym pgvector |
| Amazon Aurora PostgreSQL | w pełni zarządzany silnik zgodny z PostgreSQL; AWS zarządza łataniem, kopiami i odtwarzaniem; może być bazą wiedzy dla Amazon Bedrock |
| Google Cloud SQL for PostgreSQL | zarządzany PostgreSQL z listą rozszerzeń, w tym pgvector |
| Google AlloyDB for PostgreSQL | zarządzana baza zgodna z PostgreSQL; obok pgvector własne indeksy ScaNN i generowanie embeddingów z bazy |
Ceny zależą od regionu, warstwy i wielkości, więc ich tu nie podaję — liczcie je w kalkulatorach vendorów dla własnego profilu obciążenia.
Kryteria wyboru, które rekomenduję:
- Kompetencje zespołu. Jeśli nikt w firmie nie odtworzył bazy z kopii ani nie przeprowadził aktualizacji wersji głównej, usługa zarządzana jest bezpieczniejszym startem.
- Rozszerzenia. Potrzebujecie Apache AGE, PostgresML albo najnowszej wersji pgvector? Sprawdźcie listę w usłudze. Własna instalacja nie ma tego ograniczenia.
- Suwerenność i przenośność. Społecznościowy PostgreSQL można przenieść między chmurami i serwerownią zwykłym zrzutem. Funkcje własne vendora (np. specjalne indeksy) ułatwiają start, ale wiążą — zapiszcie, które z nich wykorzystujecie.
- Miejsce danych. Region usługi i umowa przetwarzania danych to decyzja prawna i biznesowa, nie tylko techniczna.
Platformy budowane na PostgreSQL, takie jak Supabase, dokładają API, logowanie i przechowywanie plików — także w wersji do samodzielnego uruchomienia. Opisuje to wpis Supabase w suwerennym AI OS.
Od czego zacząć
Kolejność, którą rekomenduję dla pierwszego systemu AI na PostgreSQL:
- Inwentarz. Jakie bazy PostgreSQL już macie, w jakich wersjach, kto je utrzymuje i kiedy ostatnio odtworzono je z kopii. Wersja 14 i starsze — do planu aktualizacji.
- Pytania i dane. Spiszcie pytania, na które system ma odpowiadać, i tabele, w których są odpowiedzi. Fakty z tabel, tekst z dokumentów.
- Rola agenta. Osobna rola bazy, tylko potrzebne tabele, tylko odczyt na start. RLS tam, gdzie jedna tabela obsługuje wielu odbiorców.
- Próba z pgvector. Jedna tabela dokumentów, embeddingi, wyszukiwanie hybrydowe, zestaw kilkudziesięciu pytań testowych z oczekiwaną odpowiedzią. Zmierzcie trafność i opóźnienie.
- Decyzja o architekturze. Dopiero po pomiarze: zostajecie przy pgvector, dokładacie indeks, zmieniacie model embeddingów albo porównujecie z osobną bazą.
- Plan utrzymania. Kopie z testem odtworzenia, przegląd wersji raz w roku, procedura przebudowy indeksu przy zmianie modelu.
Taką warstwę danych buduje zwykle inżynier, który rozumie jednocześnie bazę, uprawnienia i zachowanie agenta. Jeśli takiej osoby nie macie, przygotowuje do tej roli kurs Forward Deployed AI Engineer.
Mapa wpisów o PostgreSQL w AI
Wpisy o PostgreSQL i jego rozszerzeniach, pogrupowane według roli w systemie AI.
| Grupa | Wpis | O czym |
|---|---|---|
| Fundament | PostgreSQL w suwerennym AI OS | baza jako źródło prawdy: stan procesu, użytkownicy, audyt |
| Fundament | PostgreSQL JSONB w suwerennym AI OS | zmienne metadane i wyniki narzędzi obok kolumn relacyjnych |
| Wyszukiwanie i wiedza | pgvector w suwerennym AI OS | wektory i wyszukiwanie podobieństwa w tej samej bazie co dokument i uprawnienia |
| Wyszukiwanie i wiedza | Apache AGE w suwerennym AI OS | graf relacji klient → zamówienie → zasób w PostgreSQL, zapytania openCypher |
| Modele przy danych | PostgresML w suwerennym AI OS | operacje uczenia maszynowego uruchamiane blisko danych |
| Platforma aplikacji | Supabase w suwerennym AI OS | PostgreSQL z API, logowaniem, plikami i funkcjami jako backend aplikacji agentowej |
| Analityka | WarehousePG w suwerennym AI OS | rozproszona hurtownia MPP wywodząca się z PostgreSQL dla dużych zapytań |
Powiązane poradniki i wpisy:
- Co to jest AI OS — gdzie baza danych stoi obok modeli, agentów i uprawnień.
- Jak wykorzystać dane firmy w AI? RAG — wyszukiwanie dokumentów jako podstawa odpowiedzi modelu.
- Co to jest ontologia firmy — cyfrowy model firmy, który można trzymać m.in. w grafie Apache AGE.
- RBAC, ABAC i ReBAC: uprawnienia agentów AI — model uprawnień, który RLS realizuje w bazie.
- Osobne bazy i wyszukiwarki: Chroma, OpenSearch.
Najważniejsze w skrócie
- PostgreSQL to otwarta baza relacyjna na liberalnej licencji, z przewidywalnym cyklem wersji: 5 lat wsparcia na wersję główną.
- Pod AI liczy się to, że dane, wektory (pgvector), tekst pełny i uprawnienia (RLS) mogą być w jednej bazie — bez kopiowania i rozjeżdżania się filtrów.
- pgvector domyślnie szuka dokładnie; indeks przyspiesza kosztem trafności i ma limit wymiarów.
- Osobna baza wektorowa ma sens, gdy wyszukiwanie jest osobną usługą albo pomiar na własnych danych pokaże, że pgvector nie wystarcza.
- Agent łączy się jako osobna rola, nigdy kontem superużytkownika ani właściciela tabel.
- Kopia bez testu odtworzenia to hipoteza; wersja 14 kończy wsparcie 12.11.2026.
- Usługa zarządzana przejmuje utrzymanie, ale ustala listę i wersje rozszerzeń.
- Dane i analityka
- Agenci AI
- Bezpieczeństwo
- AI SDLC