NVIDIA AI w firmie: kiedy własne GPU, a kiedy chmura?
Temat: NVIDIA AI
Większość firm od 50 osób nie potrzebuje na start własnych kart NVIDIA. Korzysta z nich i tak — pośrednio, bo modele w chmurze i usługi API zwykle działają na GPU tego vendora. Własna infrastruktura NVIDIA ma sens w czterech sytuacjach: dane nie mogą opuścić firmy, model musi działać bez sieci (na linii produkcyjnej, w pojeździe), obciążenie jest stałe i wysokie albo firma musi kontrolować wersję modelu i środowiska. Wtedy kupuje się nie „kartę”, tylko cały stos: sprzęt, CUDA, serwer modeli, a coraz częściej także warstwę bezpieczeństwa agentów.
Ten poradnik jest dla zarządu i lidera IT, którzy słyszą „postawmy model u siebie na NVIDIA” i chcą wiedzieć, co to oznacza w pracy, koszcie i zależności. Czym jest sam model językowy i jak go wybrać, opisuje poradnik o LLM dla firm. Na blogu jest kilkanaście szczegółowych wpisów o produktach NVIDIA — tutaj są zebrane w jedną mapę. Statusy produktów podaję ze stanem na 6.10.2026.
NVIDIA to nie jeden produkt: cztery warstwy
Kiedy ktoś w firmie mówi „NVIDIA”, zwykle ma na myśli kartę graficzną. Dla projektu AI ważniejsze jest to, co leży nad nią. Stos NVIDIA dla firmy da się opisać w czterech warstwach. Każda stoi na poprzedniej i każda ma innego właściciela po stronie firmy.
- Sprzęt. GPU w serwerach i komputerach AI liczą model. Do tego dochodzą procesory i układy sieciowe, które NVIDIA projektuje pod agentów: Vera CPU i BlueField DPU.
- Platforma CUDA. NVIDIA opisuje CUDA jako platformę obliczeń równoległych i model programowania dla swoich GPU. To sterowniki, kompilator i biblioteki, z których korzystają frameworki AI. Tu powstaje główna zależność od vendora.
- Modele i serwowanie. NIM uruchamia model jako kontener z API, NeMo służy do budowy, oceny i dostrajania agentów, a Cosmos to modele świata dla robotów i systemów wizyjnych. Pakietem licencyjnym i wsparciem jest NVIDIA AI Enterprise.
- Agenci i bezpieczeństwo. OpenShell izoluje agenta i egzekwuje polityki, Sentry ma go nadzorować spoza hosta, a NemoClaw składa agenta w gotowym sandboxie.
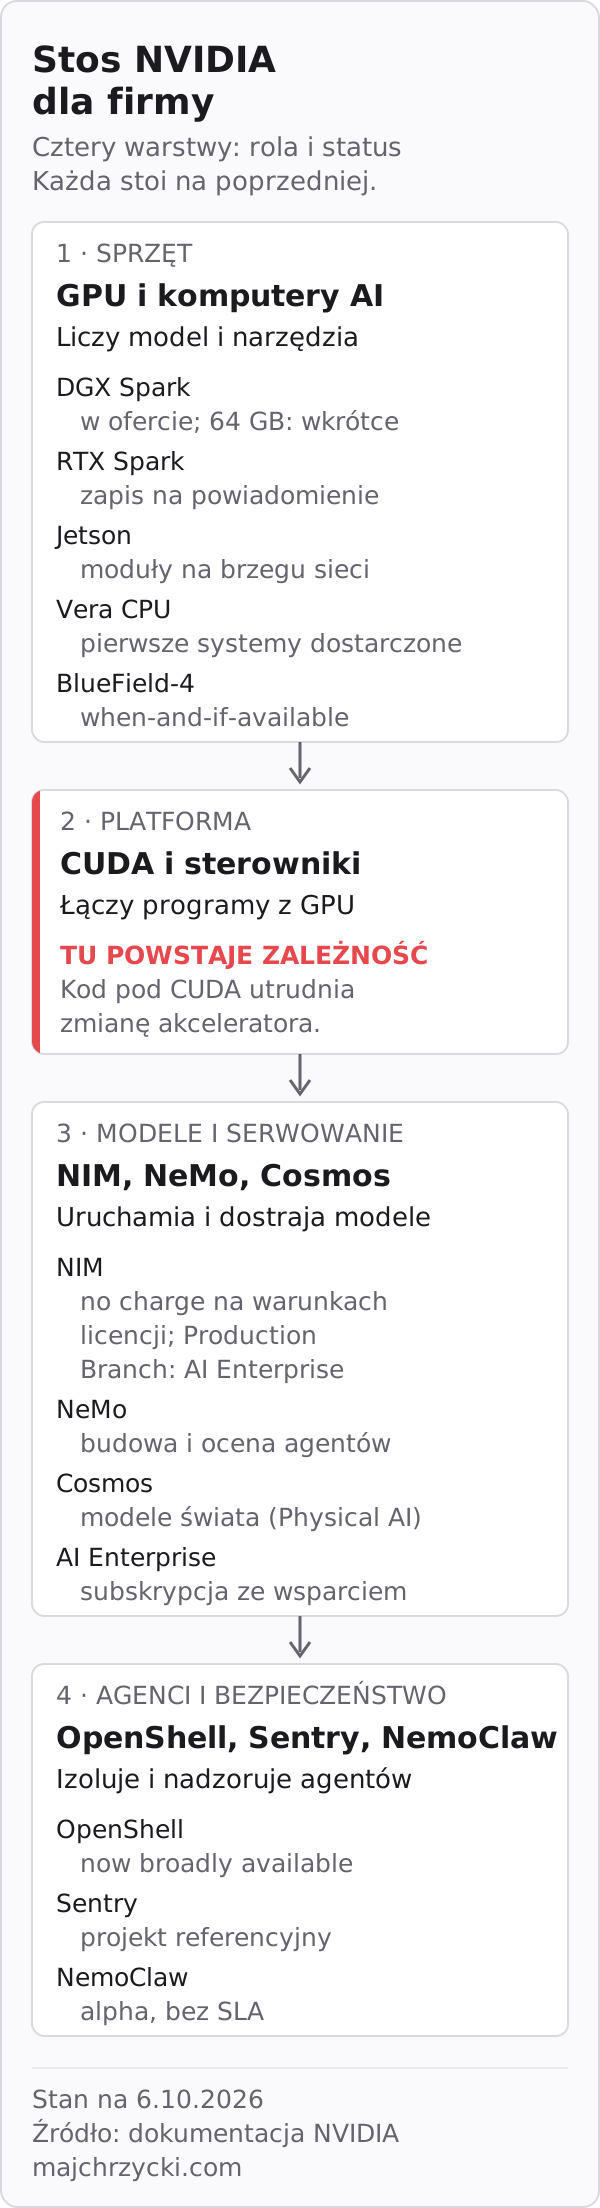
| Warstwa | Rola | Przykłady | Status (stan na 6.10.2026) |
|---|---|---|---|
| Sprzęt | liczy model i narzędzia agentów | DGX Spark, RTX Spark, Jetson, Vera CPU, BlueField-4 | od produktów w ofercie po zapowiedzi — szczegóły niżej |
| CUDA | łączy programy z GPU | CUDA, sterowniki, biblioteki | dojrzała platforma; zależność od vendora |
| Modele i serwowanie | uruchamia, dostraja i ocenia modele | NIM, NeMo, Cosmos, AI Enterprise | NIM „no charge” na warunkach licencji; Production Branch z AI Enterprise |
| Agenci i bezpieczeństwo | izoluje i nadzoruje agentów | OpenShell, Sentry, NemoClaw | OpenShell „now broadly available”, Sentry projekt referencyjny, NemoClaw alpha |
Dla zarządu z tej tabeli wynika jedno: zakup sprzętu to dopiero pierwsza warstwa. Ktoś musi utrzymywać sterowniki i wersje CUDA, ktoś wybiera i aktualizuje modele, a jeśli w grę wchodzą agenci — ktoś ustala, do czego mają dostęp.
Kiedy firma potrzebuje NVIDIA we własnej infrastrukturze
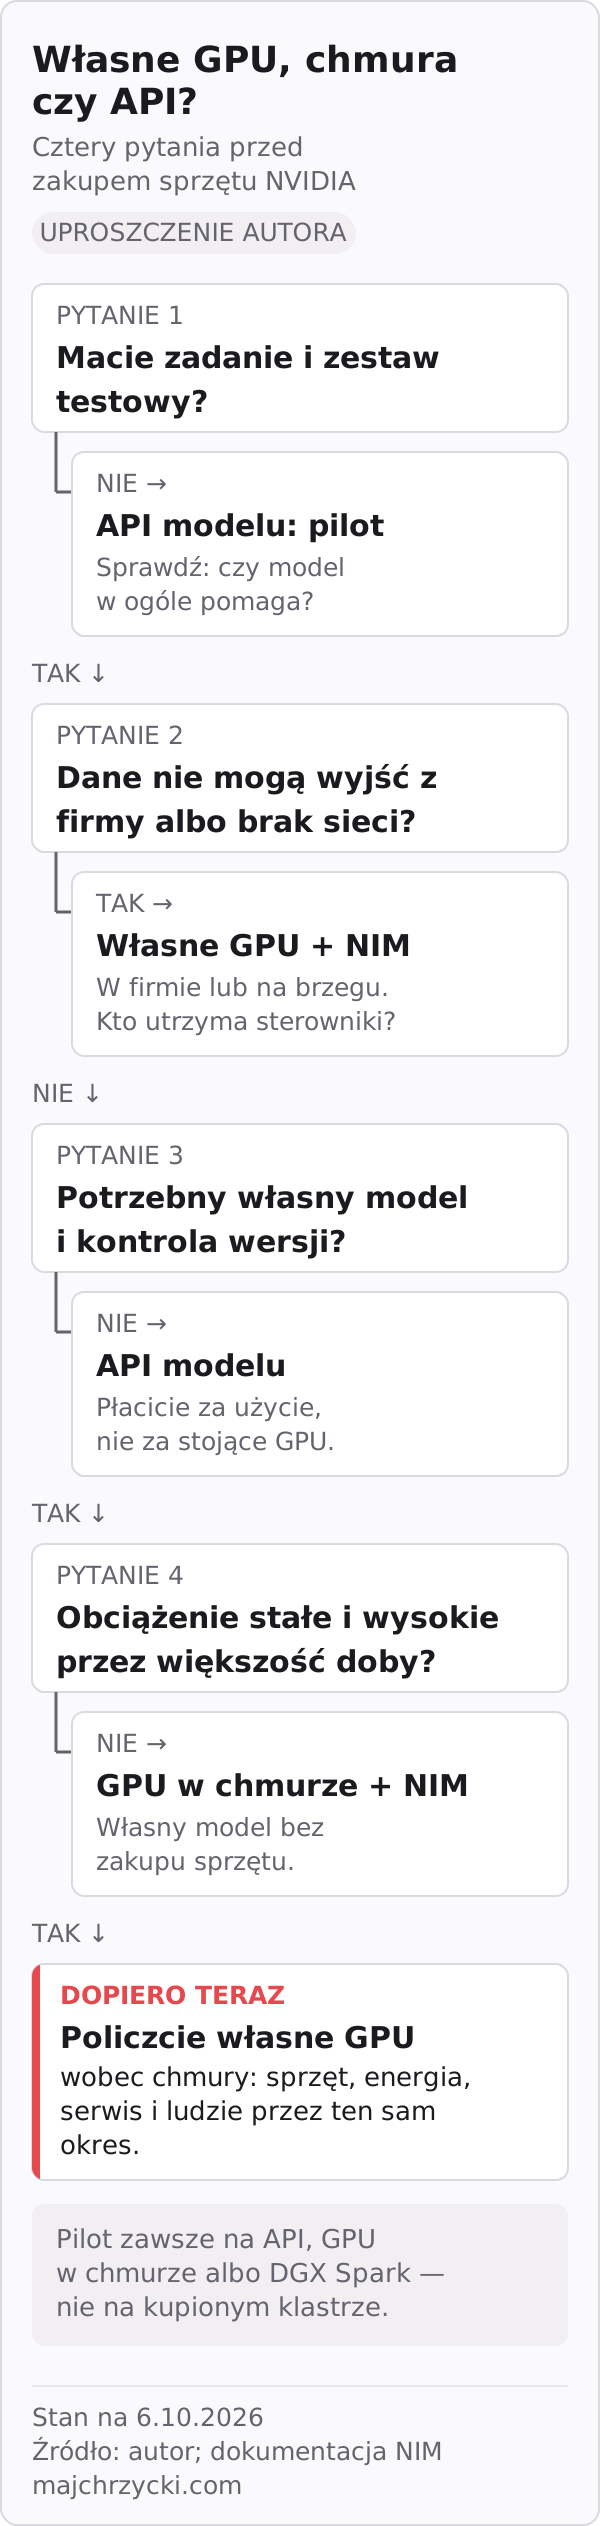
Własne GPU to decyzja o kosztach stałych i o ludziach, nie o mocy obliczeniowej. Warto ją rozważyć, gdy spełniony jest co najmniej jeden z warunków:
- Dane nie mogą opuścić firmy. Umowa z klientem, tajemnica przedsiębiorstwa albo polityka bezpieczeństwa wyklucza wysyłanie treści do usługi zewnętrznej. NIM działa też bez dostępu do internetu: wagi przygotowuje się na maszynie z siecią i przenosi do izolowanego środowiska.
- Model musi działać przy maszynie. Kamera na linii, robot, pojazd albo zakład ze słabym łączem. To obszar modułów Jetson i Jetson Linux, a przy robotach także modeli Cosmos.
- Obciążenie jest stałe i wysokie. Gdy GPU pracuje przez większość doby, własny sprzęt może wyjść taniej niż płacenie za każde wywołanie. „Może” — dopóki ktoś tego nie policzy z energią, serwisem i dyżurem.
- Trzeba kontrolować wersję. Regulowany proces wymaga, by ten sam model w tej samej wersji odpowiadał przez lata, a zmiana przechodziła przez odbiór.
Brak tych warunków to dobra wiadomość: firma może zacząć od API albo GPU w chmurze i odłożyć decyzję o sprzęcie do chwili, gdy będzie miała pomiary.
Kiedy wystarczy chmura albo API
Usługa API modelu (ChatGPT, Claude, Gemini, Azure, Bedrock i podobne) oznacza, że firma płaci za użycie, a sprzętem zarządza operator usługi. To najlepszy start, gdy przypadek użycia nie jest jeszcze sprawdzony, ruch jest nieregularny albo zespół nie ma kompetencji do utrzymania serwerów GPU. Szerzej o wyborze modelu i jego miejsca uruchomienia piszę w poradniku o LLM.
Wariant pośredni to GPU w chmurze: firma wynajmuje maszyny z kartami NVIDIA i sama uruchamia na nich model, na przykład w kontenerze NIM. Dokumentacja NIM opisuje wdrożenia na Kubernetes i u operatorów chmury: Google Cloud, AWS, Azure i Oracle. Firma kontroluje model i jego wersję, ale nie kupuje sprzętu.
| Kryterium | API modelu | GPU w chmurze (np. z NIM) | Własne GPU |
|---|---|---|---|
| Start | dni | tygodnie | miesiące (zakup, instalacja) |
| Koszt | za użycie | za czas maszyny | stały: sprzęt, energia, serwis, ludzie |
| Kontrola modelu i wersji | ograniczona do oferty usługi | pełna nad obrazem i modelem | pełna, łącznie ze sprzętem |
| Dane | trafiają do usługi na jej warunkach | w wybranym regionie chmury | w firmie, także bez sieci |
| Kto utrzymuje | operator usługi | zespół firmy (bez sprzętu) | zespół firmy w całości |
| Kiedy | pilot, ruch nieregularny | potrzebny własny model bez zakupu | dane nie mogą wyjść, brzeg sieci, stałe obciążenie |
Tabela to uproszczenie autora. Czasy startu są orientacyjne i zależą od procedur zakupowych firmy, nie od NVIDIA.
Sprzęt: od DGX Spark po Vera i BlueField
Na tej warstwie łatwo kupić coś, czego firma nie potrzebuje. Kilka produktów, o które pytają zarządy:
- DGX Spark to biurkowy komputer do rozwoju AI. Specyfikacja NVIDIA podaje 128 GB pamięci współdzielonej przez CPU i GPU, 20-rdzeniowy procesor Arm, łącze ConnectX-7 200 Gb/s i system DGX OS; wariant 64 GB jest oznaczony jako „Coming Soon”. Według NVIDIA obsługuje inferencję modeli do 200 mld parametrów i dostrajanie do 70 mld. To dobre stanowisko na pilota i testy, a nie serwer dla całej firmy.
- RTX Spark to linia komputerów AI PC z Windows 11. Stan na 6.10.2026: strona produktu zaprasza do zapisu na powiadomienie o dostępności. Nie planujcie zakupu na konkretny termin.
- Jetson to moduły do inferencji na brzegu sieci, z własnym systemem Jetson Linux. DGX OS i Jetson Linux to dwa różne systemy dla dwóch różnych sprzętów.
- Vera CPU to procesor NVIDIA do wykonywania narzędzi i sandboxów agentów. Strona produktu podaje 88 rdzeni i 176 wątków oraz pierwsze systemy dostarczone Anthropic, OpenAI, Oracle Cloud Infrastructure i SpaceXAI. Daty ogólnej dostępności i cen strona nie podaje.
- BlueField-4 to procesor DPU, na którym ma działać nadzór agentów. NVIDIA zastrzega, że produkty platformy bezpieczeństwa będą oferowane „when-and-if-available”.
Cen sprzętu tu nie podaję: zależą od konfiguracji, producenta komputera i momentu zakupu. Liczby typu „1 PFLOP FP4” to deklaracje dla określonej precyzji obliczeń. Nie mówią, jak szybko odpowie Wasz model przy Waszej liczbie użytkowników.
CUDA: wydajność i koszt zależności
CUDA jest powodem, dla którego NVIDIA jest punktem odniesienia w AI: większość frameworków, gotowych obrazów i optymalizacji zakłada właśnie tę platformę. Ten sam powód tworzy zależność. Kod pisany bezpośrednio pod CUDA albo model skompilowany do formatu zoptymalizowanego pod jedno GPU może wymagać dużej pracy przy zmianie akceleratora. Do tego dochodzą sterowniki, firmware i dostępność kart.
Zależność nie musi być zła, ale powinna być świadoma. Trzy zasady, które ją ograniczają: model stoi za standardowym API (na przykład zgodnym z OpenAI, które wystawia NIM), logika biznesowa nie zawiera wywołań CUDA, a zespół zapisuje wersje sterownika, CUDA i bibliotek razem z wynikami testów. Wtedy inny akcelerator da się porównać na tych samych zadaniach. Szczegółowo, z próbą migracji, opisuje to wpis NVIDIA i CUDA w AI OS: wydajność i koszt zależności.
NIM, NeMo i AI Enterprise: oprogramowanie i licencje
NIM to gotowe kontenery z serwerem modelu. NIM dla modeli językowych jest zbudowany na vLLM i wystawia API zgodne z OpenAI, więc aplikacja napisana pod usługę chmurową może przejść na model we własnej infrastrukturze bez przepisywania. Warunki licencji są ważne dla budżetu. Dokumentacja NVIDIA mówi, że NIM jest dostępny „at no charge under the applicable license terms”, ale bez wsparcia NVIDIA Enterprise. Wariant Production Branch wymaga aktywnej subskrypcji NVIDIA AI Enterprise. Licencja modelu jest osobna od licencji kontenera.
NeMo to według NVIDIA otwarty pakiet bibliotek do budowy, monitorowania i optymalizacji agentów. Obejmuje m.in. przygotowanie danych (Curator), ocenę modeli i agentów (Evaluator), zabezpieczenia rozmów (Guardrails) i dostrajanie (Customizer). Dla firmy to narzędzia zespołu, który już ma model i chce go dopasować albo zmierzyć.
Cosmos to platforma modeli świata dla Physical AI: robotów, pojazdów i systemów wizyjnych. Firmowy asystent nad dokumentami jej nie potrzebuje. Magazyn z autonomicznymi wózkami — być może.
NVIDIA AI Enterprise to platforma oprogramowania w subskrypcji: obejmuje m.in. NIM, NeMo, sterowniki i operatory Kubernetes, z gałęziami o różnym okresie wsparcia. To pozycja, którą trzeba ująć w budżecie, jeśli firma chce wsparcia producenta w produkcji. Cen NVIDIA nie publikuje na sprawdzonych stronach — dostaje się je w ofercie.
Agenci i bezpieczeństwo: OpenShell, Sentry, NemoClaw
Agent AI nie tylko odpowiada — uruchamia kod, czyta pliki i wywołuje API. Czym agent różni się od asystenta i kiedy go w ogóle wdrażać, opisuje poradnik o agentach AI dla firm. NVIDIA ogłosiła 28 września 2026 r. platformę, która ma dać takim agentom techniczne granice. Szczegóły i jej ograniczenia opisuje wpis NVIDIA Open Agent Safety Platform: granice autonomii AI.
| Element | Co robi | Status (stan na 6.10.2026) |
|---|---|---|
| OpenShell | sandbox agenta: pliki, procesy, sieć i sekrety pod polityką egzekwowaną poza agentem | otwarte oprogramowanie, Apache 2.0, „now broadly available”; wydania 0.1.x |
| Sentry | nadzorca poza hostem, na BlueField-4 DPU | projekt referencyjny (reference system design), nie produkt do pobrania |
| NemoClaw | gotowy stos: agent (np. OpenClaw, Hermes) w sandboxie OpenShell z politykami | alpha, „Early preview”, bez SLA |
| BlueField-4 i Vera | sprzęt dla nadzoru i wykonania agentów | „when-and-if-available” (BlueField-4); pierwsze systemy Vera u wybranych firm |
Według NVIDIA OpenShell obsługuje m.in. Codex, Claude Code, Pi i Hermes, a domyślny tryb polityk to audyt: naruszenia są zapisywane, ale ruch przechodzi. Agent w trybie audytu chętnie zrobi wszystko, o co go poproszono, i jeszcze grzecznie to zaloguje. Dlatego przejście na egzekwowanie polityk jest osobną decyzją, z właścicielem i datą.
OpenShell działa bez BlueField-4, więc firma może zacząć od oprogramowania na zwykłym serwerze albo stacji roboczej. Sprzętowy nadzór to krok, na który trzeba poczekać.
Jak zacząć: pilot w chmurze albo na DGX Spark
Kolejność, którą rekomenduję (rekomendacja autora, nie norma vendora):
- Zadanie i test. Jeden proces, lista prawdziwych pytań albo przypadków i oczekiwanych wyników. Bez tego żadne porównanie sprzętu nie ma sensu.
- Pierwsza próba przez API. Sprawdźcie, czy model w ogóle rozwiązuje zadanie. NVIDIA udostępnia w serwisie build.nvidia.com katalog modeli do wywołania przez API, a te same zadania można sprawdzić u innych vendorów.
- Model u siebie, jeśli dane tego wymagają. NIM na GPU w chmurze albo na DGX Spark w biurze, gdy danych nie wolno wysłać na zewnątrz. Dostęp do kontenerów NIM daje członkostwo w NVIDIA Developer Program; jest też 90-dniowa licencja ewaluacyjna AI Enterprise.
- Pomiar. Jakość na zestawie testowym, czas odpowiedzi przy realnej liczbie użytkowników, zużycie pamięci GPU i praca zespołu przy utrzymaniu.
- Decyzja o sprzęcie. Dopiero teraz porównajcie trzy warianty przez ten sam okres: API, GPU w chmurze i własne GPU. Dla każdego koszt stały, zmienny i ryzyko niedostępności.
Agent poproszony o „wybór najlepszego GPU dla firmy” chętnie przygotuje piękną tabelę porównawczą. Bez Waszego obciążenia i bez źródeł to wciąż tylko piękna tabela.
Jeśli zarząd nie potrafi dziś powiedzieć, które dane nie mogą wyjść z firmy i jakie zadanie ma rozwiązać model, rozmowa o kartach graficznych jest przedwczesna. Najpierw warto nazwać zadanie, dane i obciążenie — po to jest prezentacja dla zarządu.
Mapa wpisów o NVIDIA AI
Wpisy pogrupowane według warstw stosu. Szersze kryteria wyboru infrastruktury zbiera filar NVIDIA AI.
A. Sprzęt i lokalna infrastruktura
- NVIDIA DGX Spark: lokalny komputer do rozwoju AI — biurkowe stanowisko do pilota, testów i dostrajania.
- NVIDIA RTX Spark: AI PC czy alternatywa dla DGX Spark? — komputer z Windows do lokalnych modeli i jego różnice wobec DGX Spark.
- NVIDIA Linux dla AI: DGX OS i Jetson Linux — systemy dla serwerów DGX i urządzeń brzegowych.
- NVIDIA i CUDA w AI OS: wydajność i koszt zależności — gdzie powstaje lock-in i jak zostawić drogę wyjścia.
B. Modele i inferencja
- NVIDIA NIM: inferencja modeli AI we własnej infrastrukturze — kontenery z modelem, licencje i wymagania.
- NVIDIA Cosmos: modele świata dla Physical AI — modele dla robotów, pojazdów i systemów wizyjnych.
C. Agenci i bezpieczeństwo
- NVIDIA Open Agent Safety Platform: granice autonomii AI — wpis nadrzędny cyklu o bezpieczeństwie agentów.
- NVIDIA OpenShell: autonomia agentów pod kontrolą — sandbox i polityki dla agenta.
- NVIDIA Sentry: nadzorca poza zasięgiem agenta AI — projekt referencyjny nadzoru spoza hosta.
- NVIDIA BlueField: sprzętowa granica dla agentów AI — DPU jako miejsce nadzoru.
- NVIDIA Vera CPU: procesor dla narzędzi agentów AI — procesor do sandboxów i orkiestracji.
- NVIDIA NemoClaw: izolacja agenta w AI SDLC — gotowy stos agenta w sandboxie OpenShell, w fazie alpha.
Najważniejsze w skrócie
- Większość firm korzysta z NVIDIA pośrednio, przez chmurę i API. Własne GPU są potrzebne, gdy dane nie mogą wyjść z firmy, model działa przy maszynie, obciążenie jest stałe albo trzeba kontrolować wersję.
- Stos NVIDIA ma cztery warstwy: sprzęt, CUDA, modele i serwowanie, agenci i bezpieczeństwo. Zakup sprzętu to dopiero pierwsza.
- Główna zależność od vendora powstaje w CUDA. Ogranicza ją standardowe API przed modelem i zapisane wersje.
- NIM jest dostępny na warunkach licencji bez opłaty, ale wsparcie produkcyjne i Production Branch wymagają NVIDIA AI Enterprise.
- Statusy są różne: OpenShell dostępny, Sentry to projekt referencyjny, NemoClaw jest w fazie alpha, BlueField-4 „when-and-if-available”.
- Pilot robi się na API, GPU w chmurze albo DGX Spark. Decyzję o własnym sprzęcie podejmuje się po pomiarze.
- NVIDIA AI
- Modele i LLM
- Agenci AI
- Zarząd