Co to jest LLM? Modele językowe — poradnik dla firm
Temat: Architektura systemów AI
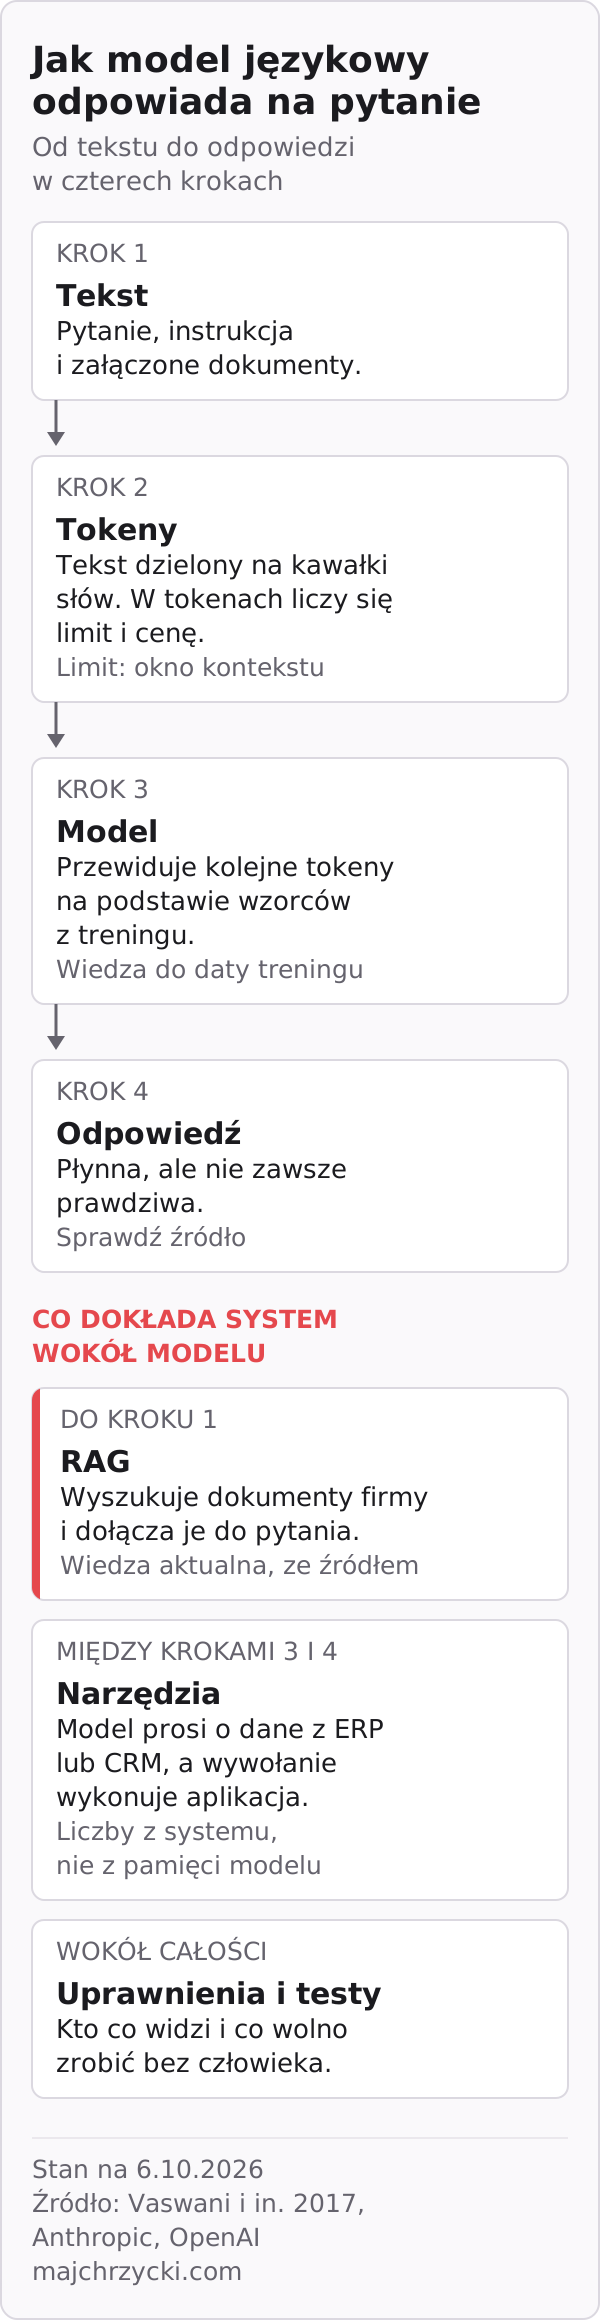
Model językowy (LLM, large language model) to program, który nauczył się z ogromnej ilości tekstu przewidywać kolejne fragmenty wypowiedzi — i dzięki temu potrafi pisać, streszczać, tłumaczyć i analizować. Nie jest bazą wiedzy ani systemem firmy. Zna to, co było w danych treningowych do określonej daty, nie widzi Waszych dokumentów, dopóki ich nie dostanie, i potrafi się pomylić z pełnym przekonaniem. Dlatego w firmie wybiera się najpierw zadanie i sposób sprawdzenia wyniku, a dopiero potem model.
Poradnik jest dla zarządu i liderów IT w firmach od 50 osób, którzy słyszą „wdróżmy LLM” i chcą rozumieć, co kupują: czym różni się duży model od małego, otwarty od zamkniętego i gdzie model może działać. Na końcu jest mapa wszystkich wpisów o modelach na blogu. Szerszy kontekst — jak model łączy się z wiedzą, narzędziami i orkiestracją — daje filar architektura systemów AI.
Czym jest model językowy — prosto
Współczesne modele językowe stoją na architekturze Transformer, opisanej w pracy Attention Is All You Need (Vaswani i in., 2017). Mechanizm uwagi pozwala modelowi brać pod uwagę zależności między wszystkimi fragmentami tekstu naraz. Dla zarządu ważniejsze od architektury są trzy pojęcia: tokeny, trening i okno kontekstu.
Tokeny: w czym model liczy tekst
Model nie czyta liter ani całych słów. Tekst jest dzielony na tokeny: krótkie słowa, części dłuższych słów, znaki interpunkcyjne. W tokenach vendorzy podają limity i ceny. Anthropic w porównaniu modeli Claude podaje cenę za milion tokenów wejścia i wyjścia oraz zastrzega, że ta sama liczba tokenów mieści różną liczbę słów zależnie od tokenizera danego modelu. Wniosek praktyczny: koszt i limit długości zależą od modelu, więc porównujcie je na tym samym tekście.
Trening: wiedza do określonej daty
Model powstaje w dwóch etapach. Najpierw uczy się na ogromnym zbiorze tekstów przewidywać kolejne tokeny. Potem jest dostrajany, żeby wykonywał polecenia i odpowiadał w pożądany sposób, na przykład metodą RLHF opisaną w pracy Ouyang i in. (2022): ludzie oceniają odpowiedzi, a model uczy się preferowanych wariantów. Badacze ze Stanford nazwali takie modele, trenowane szeroko i dostosowywane do wielu zadań, modelami fundamentalnymi (Bommasani i in., 2021).
Skutek dla firmy: wiedza modelu kończy się na dacie treningu. Anthropic podaje dla każdego modelu osobno datę „wiarygodnej wiedzy” i datę danych treningowych — dla Claude Haiku 4.5 to odpowiednio luty i lipiec 2025 r. (stan na 6.10.2026). Wasz cennik z zeszłego tygodnia w treningu nie był. Wewnętrzna procedura też nie, bo nigdy nie była publiczna.
Okno kontekstu: pamięć robocza
Okno kontekstu to cały tekst, który model bierze pod uwagę przy jednej odpowiedzi: instrukcja, historia rozmowy, załączone dokumenty, wyniki narzędzi i sama odpowiedź. Anthropic w dokumentacji okna kontekstu nazywa je „pamięcią roboczą” modelu, w odróżnieniu od danych treningowych. Okna są duże — w obecnych modelach Claude od 200 tys. do 1 mln tokenów (stan na 6.10.2026) — ale ta sama dokumentacja zaznacza, że wraz z liczbą tokenów spada trafność i przywoływanie informacji. Więcej tekstu nie znaczy lepszej odpowiedzi. Znaczy wyższy rachunek.
Co model potrafi, a czego nie
Model świetnie radzi sobie z językiem: przekształca, streszcza, porządkuje, klasyfikuje i proponuje. Słabo radzi sobie z tym, co wymaga aktualnych faktów firmy, dokładnych obliczeń i odpowiedzialności za decyzję.
| Model potrafi | Model nie potrafi sam |
|---|---|
| streścić dokument, który dostał | znać dokumentów, których nie dostał |
| wyciągnąć pola z maila lub faktury | zagwarantować, że pole jest poprawne |
| sklasyfikować zgłoszenie | wiedzieć, kto w firmie może co zobaczyć |
| napisać szkic odpowiedzi | sprawdzić, czy rabat w szkicu jest dozwolony |
| zaproponować plan analizy | wziąć odpowiedzialności za decyzję |
Halucynacje. NIST w profilu ryzyka generatywnej AI (NIST AI 600-1) używa słowa „konfabulacja” dla pewnie podanej treści, która jest fałszywa. Wynika ona z samej konstrukcji modelu, który przewiduje prawdopodobny ciąg dalszy. Badacze OpenAI w pracy Why Language Models Hallucinate (2025) dodają, że trening i testy częściej nagradzają zgadywanie niż przyznanie się do niepewności. Model zapytany o nieistniejący paragraf regulaminu chętnie go zacytuje. Z numerem strony.
Brak dostępu do danych firmy. Model nie widzi Waszego ERP, CRM ani dysku, dopóki aplikacja mu czegoś nie poda. Są cztery drogi, żeby korzystał z wiedzy firmy: prompt z dokumentem, RAG, fine-tuning i RAFT. Opisuje je poradnik o RAG i danych firmy w AI. Krótko: brakuje wiedzy — RAG; model działa niespójnie — dopiero wtedy trening.
Szczegółowy przegląd zadań, w których LLM wnosi wartość, i testów przed wdrożeniem jest we wpisie Duże modele językowe: możliwości i ograniczenia.
LLM i SLM: duży czy mały model
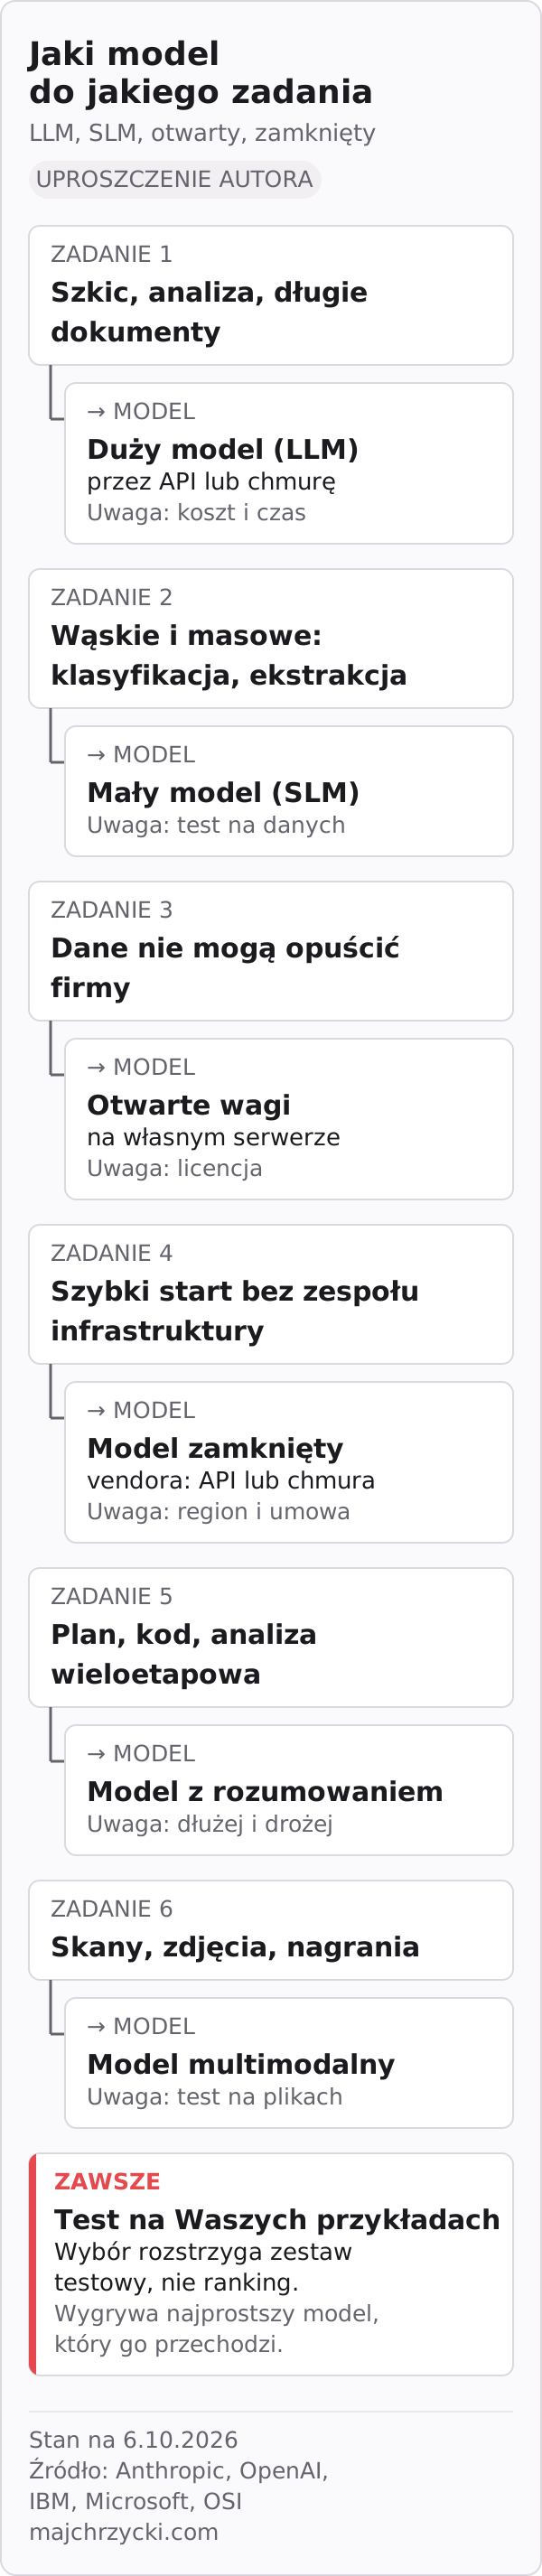
Nie ma jednej granicy między dużym a małym modelem. IBM opisuje małe modele językowe (SLM) jako mające od kilku milionów do kilku miliardów parametrów, ale to jedno źródło, nie norma. Microsoft nazywa swoją rodzinę Phi małymi modelami i podkreśla, że mogą działać w chmurze, na brzegu sieci i bezpośrednio na urządzeniu, bez połączenia z chmurą.
| Duży model (LLM) | Mały model (SLM) | |
|---|---|---|
| Typowe zadania | złożona analiza, długie dokumenty, pisanie, kod | wąskie i powtarzalne: klasyfikacja, ekstrakcja, routing |
| Gdzie działa | zwykle API vendora lub chmura | także laptop, serwer w firmie, urządzenie |
| Koszt jednego wywołania | wyższy | niższy |
| Ryzyko | koszt i czas przy prostych zadaniach | słabsza jakość przy zadaniach spoza wąskiego zakresu |
Coraz częściej firmy łączą oba rodzaje: mały model obsługuje większość prostych przypadków, a trudniejsze przekazuje dużemu. Anthropic opisuje taki wzorzec w poradniku wyboru modelu: tańszy model wykonuje pracę, a droższy rozstrzyga trudne decyzje. Więcej o małych modelach: Małe modele językowe SLM: kiedy mają sens w firmie.
Modele otwarte i zamknięte
Model zamknięty udostępnia vendor przez swoją aplikację, API albo chmurę partnera — tak działają na przykład modele Claude, GPT czy Gemini. Wag modelu nie dostajecie. Płacicie za użycie, a warunki określa umowa.
Model z otwartymi wagami można pobrać i uruchomić na własnym sprzęcie. Daje to kontrolę nad tym, gdzie trafiają dane, ale przenosi na firmę utrzymanie, bezpieczeństwo i aktualizacje. „Otwarte wagi” to jeszcze nie open source. Open Source AI Definition 1.0 organizacji OSI wymaga swobody użycia, badania, zmiany i udostępniania oraz dostępu do kodu, informacji o danych treningowych i parametrów.
Licencje modeli otwartych bardzo się różnią. Przykłady, stan na 6.10.2026:
- Gemma 4 od Google ma licencję Apache 2.0.
- Llama 4 od Meta ma własną licencję społecznościową: firmy z ponad 700 mln aktywnych użytkowników miesięcznie muszą prosić Meta o osobną licencję, a produkt ma oznaczenie „Built with Llama”.
- Mistral część modeli udostępnia na Apache 2.0, a część jako modele komercyjne na innych warunkach.
Licencję czyta się dla konkretnego modelu i wersji, nie dla całej rodziny. Ocenę licencji i otwartych narzędzi zbiera filar Open Source AI, a co oznacza sama licencja Apache 2.0, wyjaśnia wpis Apache 2.0: licencja open source dla firmowego AI. Umowę i licencję ocenia prawnik — ten poradnik pokazuje, o co zapytać.
Rozumowanie i multimodalność
Modele z rozumowaniem przed odpowiedzią wykonują dodatkowy etap „myślenia”: rozkładają zadanie na części i rozważają kilka podejść. OpenAI w przewodniku o modelach rozumujących wyjaśnia, że te dodatkowe tokeny zajmują okno kontekstu i są rozliczane jak tokeny wyjścia, a parametr wysiłku pozwala wybrać między szybkością a dokładnością. Anthropic w modelach Claude stosuje podobny mechanizm, w którym model sam dobiera ilość myślenia. Rozumowanie pomaga przy planowaniu, kodzie i analizie wieloetapowej. Przy streszczeniu maila to zwykle przepłacanie. Historię pierwszego takiego modelu opisuje wpis OpenAI o1 w Azure: rozumowanie i migracja modelu.
Modele multimodalne przyjmują nie tylko tekst. Wszystkie obecne modele Claude przyjmują tekst i obrazy, a modele Gemini także wideo i dźwięk (stan na 6.10.2026). W firmie oznacza to czytanie skanów, zdjęć z hali, wykresów i nagrań. Zasada jest ta sama co przy tekście: model może źle odczytać liczbę z rozmazanego zdjęcia faktury, więc wynik trafia do walidacji, a nie prosto do księgowości.
Gdzie uruchomić model
Ten sam model bywa dostępny w kilku miejscach. Wybór zależy od danych, regionu i tego, kto ma utrzymywać infrastrukturę.
| Miejsce | Jak to działa | Dla kogo |
|---|---|---|
| API vendora | aplikacja wysyła zapytanie do OpenAI, Anthropic, Google | szybki start, mały zespół |
| Chmura | model w Microsoft Foundry, Amazon Bedrock albo Google Vertex AI, w ramach umowy z chmurą | firmy, które już mają chmurę i jej zasady bezpieczeństwa |
| Własny serwer | model z otwartymi wagami na własnych GPU, na przykład z vLLM albo NVIDIA NIM | dane nie mogą opuścić firmy, jest zespół do utrzymania |
Dwa pytania o dane trzeba zadać przy każdym wariancie. Pierwsze: czy vendor używa zapytań do trenowania? Microsoft w opisie przetwarzania danych w Foundry podaje, że prompty i odpowiedzi nie są dostępne dla OpenAI ani innych vendorów modeli i nie służą do trenowania modeli bazowych. Drugie: gdzie dane są przetwarzane? W tej samej dokumentacji wdrożenie typu „Global” może przetwarzać zapytania w dowolnym regionie, a „Data Zone” w Unii Europejskiej — tylko w państwach UE. Sposób wdrożenia modeli w Foundry opisuje wpis MaaS w Microsoft Foundry: wybór wdrożenia.
Jak wybrać model: pięć kryteriów
Vendorzy mówią tu zaskakująco zgodnie. Anthropic w poradniku wyboru modelu wskazuje zestaw testów na własnych danych jako najważniejszy krok. OpenAI w przewodniku wyboru modelu radzi zostać przy najlżejszym ustawieniu, które spełnia próg jakości. Na tej podstawie proponuję pięć kryteriów, w tej kolejności:
- Zadanie. Jedno, konkretne: „wyciągnij pięć pól z reklamacji”, a nie „AI dla działu obsługi”. Bez zadania nie ma czego porównywać.
- Jakość na Waszych testach. Zestaw prawdziwych przykładów z oczekiwanym wynikiem, w tym przypadki trudne i bez odpowiedzi. Publiczny ranking mierzy cudze zadania.
- Koszt jednego poprawnego zadania. Cena tokenów plus wyszukiwanie, integracja, nadzór i poprawki człowieka. Tańszy model, który dwa razy częściej trafia do poprawki, nie jest tańszy.
- Dane. Jakie dane trafią do modelu, czy vendor może ich użyć i jak długo je przechowuje. To decyduje, czy wystarczy API, czy potrzebny jest własny serwer.
- Region i umowa. Gdzie dane są przetwarzane, kto odpowiada za incydent i co się stanie, gdy vendor wycofa wersję modelu.
Ramę zarządzania ryzykiem daje NIST AI RMF 1.0 — dobrowolny standard z czterema funkcjami: Govern, Map, Measure i Manage. Dla zarządu to prosta lista kontrolna: kto odpowiada, gdzie model działa, jak mierzymy wynik, co robimy po błędzie.
Jeśli dziś w firmie nikt nie potrafi wskazać jednego zadania i osoby, która oceni wynik modelu, porównywanie modeli jest przedwczesne. Najpierw warto nazwać proces, dane i kryterium „dobrze” — po to jest prezentacja dla zarządu, niezależnie od vendora i partnera.
Od asystenta do agenta
Sam model tylko odpowiada tekstem. Żeby coś zrobił — sprawdził stan magazynu, założył zgłoszenie, policzył marżę — aplikacja daje mu narzędzia. Anthropic w dokumentacji narzędzi opisuje to tak: model decyduje, kiedy wywołać narzędzie, i zwraca ustrukturyzowane wywołanie, a wykonuje je aplikacja. To ważne dla bezpieczeństwa: uprawnienia nadaje system, nie model.
Gdy model sam planuje kolejne kroki i wywołuje narzędzia aż do celu, mówimy o agencie AI. Czym agent różni się od asystenta i chatbota i kto zatwierdza jego działania, opisuje poradnik o agentach AI. Konkretne produkty, w których modele działają jako asystenci, opisują poradnik o ChatGPT i poradnik o Claude. Ryzyka aplikacji z modelami zbiera OWASP LLM Top 10 2026.
Mapa wpisów o modelach językowych
Wszystkie wpisy o modelach na blogu, w sześciu grupach. Zacznijcie od grupy, która odpowiada Waszemu pytaniu.
A. Podstawy: czym są modele
- Duże modele językowe: możliwości i ograniczenia — zadania, w których LLM wnosi wartość, i testy przed wdrożeniem.
- Małe modele językowe SLM: kiedy mają sens w firmie — granica rozmiaru, koszt i prywatność małych modeli.
- Modele fundamentalne AI: zastosowania i ograniczenia — model bazowy jako punkt wyjścia aplikacji.
- Modele generatywne AI w Azure: jak wybrać — model generatywny, zadanie i pomiar.
- Narrow AI: czym jest wąska AI i kiedy ją stosować — dlaczego każde wdrożenie w firmie jest wąskie.
B. Jak model się uczy i dostosowuje
- RLHF: co wnosi informacja zwrotna człowieka — jak oceny ludzi zmieniają zachowanie modelu.
- Fine-tuning modelu: kiedy warto go przeprowadzić — trening na przykładach i jego koszt.
- RAG, fine-tuning czy RAFT: jak wybrać — porównanie dróg do wiedzy firmy.
- RAFT: trening modelu dla domenowego RAG — model trenowany pod wyszukiwanie.
- Microsoft Olive: kiedy optymalizować model AI — kwantyzacja i konwersja pod konkretny sprzęt.
C. Rozumowanie, multimodalność i inne kategorie modeli
- OpenAI o1 w Azure: rozumowanie i migracja modelu — kiedy dodatkowe rozumowanie się opłaca.
- GPT-4o w Azure: zastosowania i plan migracji — model łączący tekst i obraz.
- Jev od TypeSafe AI: model decyzji, nie chatbot — model, który oddaje wartości i prawdopodobieństwa zamiast tekstu.
- NVIDIA Cosmos: modele świata dla Physical AI — modele dla robotów i świata fizycznego.
D. Gdzie uruchomić model
- MaaS w Microsoft Foundry: wybór wdrożenia — model przez API w chmurze Microsoft.
- NVIDIA NIM: inferencja modeli AI we własnej infrastrukturze — gotowe kontenery z modelami na własnych GPU.
- vLLM w suwerennym AI OS — otwarty serwer do uruchamiania modeli.
- ONNX Runtime w suwerennym AI OS — uruchamianie zoptymalizowanych modeli.
- Open WebUI: własny interfejs do modeli AI — okno czatu do modeli na własnym serwerze.
- LM Studio Bionic: agent z modelem lokalnym czy chmurowym? — model lokalny na komputerze programisty.
E. Modele z otwartymi wagami
- Hugging Face: modele i narzędzia AI dla firmy — gdzie szukać modeli i co sprawdzić przed użyciem.
- Llama od Meta: własne wdrożenie modelu AI — licencja społecznościowa Meta i własny hosting.
- Gemma od Google: mały model pod kontrolą firmy — otwarte modele na licencji Apache 2.0.
- DeepSeek: otwarte modele do kodu i analityki — publiczny endpoint a wagi uruchamiane u siebie.
- Qwen od Alibaba: kodowanie i własny hosting — wybór konkretnego wariantu modelu.
- Bielik: polski model dla suwerennego AI — polska rodzina modeli SpeakLeash.
- PLLuM: polski model dla administracji i firm — różne licencje w jednej rodzinie.
F. Modele vendorów
Modele zamknięte opisują osobne poradniki: ChatGPT i modele OpenAI oraz Claude i modele Anthropic. Wpisy o pojedynczych modelach:
- OpenAI: GPT-5 w biznesie, GPT-5.6 Terra, GPT-6 Astra, GPT-6 Sol, GPT-6 Luna.
- Anthropic: Claude Haiku, Claude Sonnet, Claude Opus, Claude Fable, Claude Mythos.
- Microsoft: Modele MAI Microsoftu: który wybrać do firmy?, małe modele Fara 1.5, MagenticBrain 14B, OptiMind i Big tasks. Small models.
- Inni vendorzy: Google Gemini w firmie, Grok: tekst, kod i agentowe zadania firmy, Cohere: jak ocenić model i platformę, IBM watsonx, Amazon Q.
Najważniejsze w skrócie
- Model językowy przewiduje kolejne tokeny. Pisze płynnie, ale nie odczytuje faktów z bazy i może się mylić z pełnym przekonaniem.
- Wiedza modelu kończy się na dacie treningu, a danych firmy model nie zna, dopóki ich nie dostanie — przez RAG albo narzędzia.
- Okno kontekstu to pamięć robocza. Większe okno nie oznacza lepszej odpowiedzi, tylko wyższy koszt.
- Mały model wystarczy do wąskich, masowych zadań; duży do złożonej analizy. Często najlepiej działają oba razem.
- Otwarte wagi to nie zawsze open source. Licencję czyta się dla konkretnego modelu i wersji.
- Model wybiera się po zadaniu, testach na własnych przykładach, koszcie poprawnego zadania, danych i regionie — w tej kolejności.
- Modele i LLM
- Strategia
- Bezpieczeństwo
- Zarząd