Co to jest obserwowalność AI? Poradnik dla firm
Temat: Bezpieczeństwo i utrzymanie AI
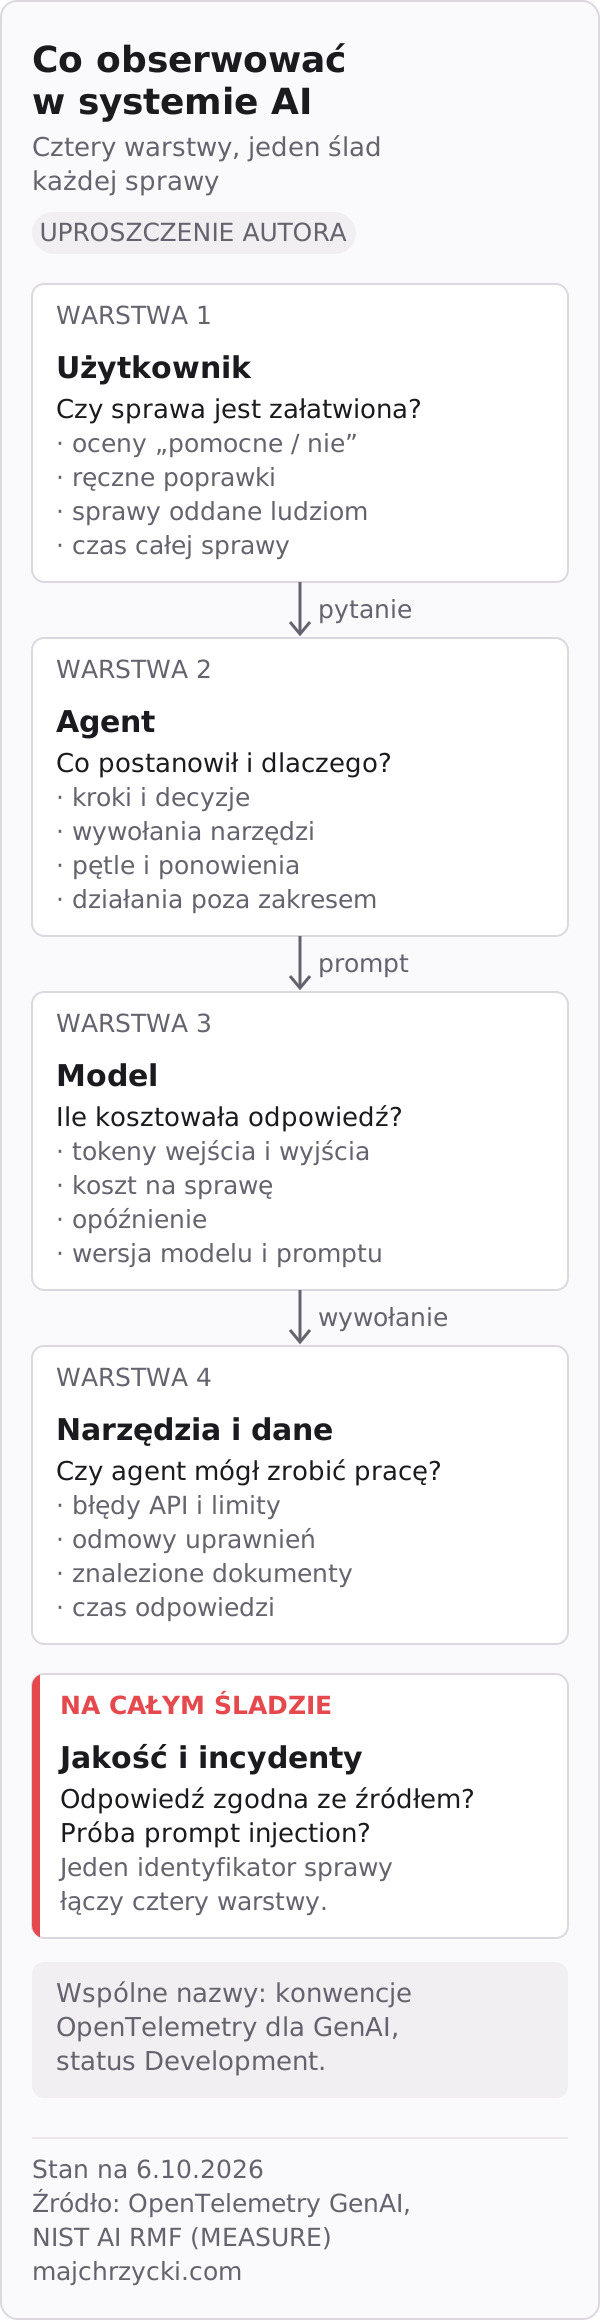
Obserwowalność AI to zdolność odpowiedzi na pytanie, co dokładnie zrobił system AI, ile to kosztowało i czy wynik był dobry — dla każdej sprawy, a nie tylko „średnio”. Zwykły monitoring powie, że serwer działa i odpowiada w dwie sekundy. Nie powie, że agent przez tydzień podawał klientom nieaktualny cennik, bo wyszukiwanie znajdowało stary dokument. Dlatego system AI obserwuje się na czterech warstwach: użytkownik, agent, model i narzędzia. Zaczyna się od śladów wywołań i małego zestawu testowego, a nie od zakupu platformy.
Poradnik jest dla zarządu i lidera IT firmy od 50 osób, która ma już pilota z AI albo właśnie go planuje. Na końcu jest mapa wszystkich wpisów o obserwowalności na blogu. Szerszy kontekst odpowiedzialności daje przewodnik bezpieczeństwo i utrzymanie AI.
Dlaczego system AI obserwuje się inaczej niż zwykłą aplikację
Zwykła aplikacja na to samo wejście daje to samo wyjście. Gdy coś się psuje, widać to po błędzie, kodzie odpowiedzi albo czasie. System z modelem językowym psuje się ciszej. Są cztery różnice, które zarząd powinien znać.
Odpowiedzi są niedeterministyczne. To samo pytanie zadane dwa razy może dać dwie różne odpowiedzi. Test „raz zadziałało” niczego nie dowodzi. Jakość trzeba mierzyć na zestawie przypadków i śledzić w czasie.
Błąd nie wygląda jak błąd. Agent zwraca poprawną technicznie odpowiedź, z kodem 200 i w ładnym formacie, a w treści z pełnym przekonaniem cytuje regulamin, który wygasł w zeszłym roku. Pewny ton odpowiedzi nie mówi nic o jej poprawności. Monitoring infrastruktury tego nie wychwyci, bo z jego punktu widzenia wszystko działa.
Koszt zależy od treści. W zwykłej aplikacji koszt rośnie z liczbą użytkowników. W systemie AI płaci się za tokeny, czyli za długość promptu, kontekstu i odpowiedzi. Agent, który wpadnie w pętlę albo dołącza do każdego pytania cały katalog produktów, może podnieść rachunek bez wzrostu ruchu.
Bezpieczeństwo ma nowe wejścia. Złośliwa treść w mailu albo dokumencie może zmienić zachowanie agenta (prompt injection). Agent z narzędziami może wywołać operację, której nikt nie przewidział. Te zdarzenia trzeba widzieć w śladach, bo log serwera pokaże tylko „żądanie obsłużone”.
NIST AI Risk Management Framework ujmuje to w funkcji MEASURE: działanie systemu AI i jego komponentów powinno być monitorowane na produkcji, a firma powinna mieć ludzi i metody do regularnego śledzenia ryzyk, także tych nieprzewidzianych (MEASURE 2.4 i 3.1, stan na 6.10.2026). To nie jest jednorazowy test przed wdrożeniem.
Co mierzyć: sześć grup sygnałów
Obserwowalność nie polega na zbieraniu wszystkiego. Polega na tym, żeby dla każdej sprawy dało się odtworzyć przebieg i ocenić wynik. Proponuję sześć grup sygnałów (podział autora). Każda ma innego odbiorcę w firmie.
| Grupa | Co obejmuje | Pytanie, na które odpowiada | Kto czyta |
|---|---|---|---|
| Ślady wywołań | cała ścieżka sprawy: pytanie, kroki agenta, wywołania modelu i narzędzi, z jednym identyfikatorem | co dokładnie się stało w tej sprawie? | IT, osoba prowadząca agenta |
| Koszt | tokeny wejścia i wyjścia, liczba wywołań modelu na sprawę, koszt na sprawę | ile kosztuje jedna obsłużona sprawa? | IT, finanse, właściciel procesu |
| Opóźnienie | czas całej sprawy, czas modelu, czas narzędzi, czas do pierwszej odpowiedzi | gdzie użytkownik czeka? | IT |
| Jakość i ugruntowanie | ocena odpowiedzi, zgodność ze źródłem, odsetek poprawek, oceny użytkowników | czy odpowiedź była dobra i oparta na właściwym dokumencie? | właściciel procesu |
| Błędy narzędzi | nieudane wywołania API, odmowy uprawnień, przekroczone limity, ponowienia | czy agent może wykonać swoją pracę? | IT |
| Incydenty i eskalacje | wykryte próby prompt injection, działania poza zakresem, sprawy oddane człowiekowi | co poszło źle i kto to przejął? | bezpieczeństwo, właściciel procesu |
Najważniejszy jest pierwszy wiersz. Ślad (trace) łączy wszystkie kroki jednej sprawy w całość. Bez niego koszt, opóźnienie i błąd są osobnymi liczbami, których nie da się przypisać do konkretnej rozmowy. Z nim można zapytać: „pokaż mi wszystkie sprawy z wczoraj, w których agent dał rabat, i dokumenty, na których się oparł”.
Druga uwaga dotyczy jakości. Opóźnienie i koszt mierzy się automatycznie. Jakość wymaga definicji, którą musi dać biznes: co to jest dobra odpowiedź na reklamację? Bez tej definicji narzędzie pokaże piękne wykresy, ale nie odpowie, czy system pomaga.
Standard: OpenTelemetry i konwencje dla generatywnej AI
OpenTelemetry to otwarty framework do generowania, eksportu i zbierania śladów, metryk i logów, niezależny od vendora. Jest projektem Cloud Native Computing Foundation. Ważne zastrzeżenie: OpenTelemetry nie przechowuje ani nie pokazuje danych. Zbiera je i wysyła do zaplecza, na przykład Prometheus i Grafany albo platformy komercyjnej.
Dla AI istotne są konwencje semantyczne, czyli wspólne nazwy dla tego, co się mierzy: operacja modelu, wywołanie agenta, wykonanie narzędzia, zużycie tokenów. Dzięki nim ślad z aplikacji w Pythonie i ślad z usługi w .NET można oglądać w jednym narzędziu. Stan na 6.10.2026:
- konwencje dla generatywnej AI mają status Development, czyli mogą się jeszcze zmieniać (dokument konwencji),
- od wydania v1.42.0 głównych konwencji (12.06.2026) definicje GenAI żyją w osobnym repozytorium semantic-conventions-genai, które nie ma jeszcze żadnego wydania; najnowsze wydanie głównych konwencji to v1.44.0 z 4.08.2026,
- konwencje obejmują spany modelu i agenta, metryki (m.in. czas operacji, czas wywołania agenta, liczbę wywołań modelu i narzędzi), zdarzenia, wyjątki, Model Context Protocol oraz konwencje dla OpenAI, Anthropic, AWS Bedrock i Azure AI Inference,
- zapis treści promptów, odpowiedzi i instrukcji systemowych jest opcjonalny (opt-in), a dokumentacja ostrzega, że może on zawierać dane wrażliwe, w tym dane osobowe.
Co z tego wynika dla zarządu? Wymagajcie od vendora i partnera, żeby system eksportował ślady w formacie OpenTelemetry (OTLP). To chroni przed zamknięciem historii działania systemu w jednym narzędziu. Jednocześnie zaplanujcie, że nazwy atrybutów zmienią się co najmniej raz, zanim standard się ustabilizuje. Nazwy metryk tokenów zmieniły się już przy przenosinach do nowego repozytorium.
Szczegóły techniczne i wdrożenie opisuje wpis OpenTelemetry w suwerennym AI OS.
Narzędzia: jaka jest ich rola
Narzędzi jest dużo i często robią podobne rzeczy. Zamiast rankingu — role. Wersje i licencje sprawdzone w repozytoriach projektów, stan na 6.10.2026.
| Rola | Przykłady | Licencja / forma | Uwagi |
|---|---|---|---|
| Standard i zbieranie danych | OpenTelemetry, Collector v0.162.0 | Apache-2.0 | zbiera i przekazuje, nie przechowuje |
| Metryki i alerty | Prometheus v3.15.0 | Apache-2.0 | opóźnienia, błędy, zużycie GPU, progi alarmowe |
| Dashboardy i eksploracja | Grafana v13.2.3, zestaw LGTM | AGPL-3.0 | wspólny widok metryk, logów i śladów |
| Ślady i ewaluacje aplikacji LLM | Langfuse v4.53.0 | MIT dla rdzenia, osobna licencja dla katalogów ee/ | przyjmuje ślady OpenTelemetry, koszt, prompty, zbiory testowe |
| Ślady i ewaluacje aplikacji LLM | LangSmith | usługa LangChain: chmura, hybryda, samodzielny hosting | przyjmuje ślady OpenTelemetry, ewaluacje offline i online |
| Ślady i ewaluacje aplikacji LLM | Arize Phoenix v20.19.0 | Elastic License 2.0 | oparty na OpenTelemetry i OpenInference, do samodzielnego hostowania |
| Platformy komercyjne | Datadog, Splunk, ClickStack | usługi vendorów lub stos open source | sensowne, gdy firma już ich używa do APM i logów |
| Bezpieczeństwo i incydenty | Wazuh, TheHive, Cortex | różne licencje, zobacz wpisy | widoczność hostów, obsługa incydentu, analiza |
Trzy uwagi przy wyborze.
Najpierw sprawdźcie, co już macie. Jeśli IT używa Grafany albo platformy APM, ślady z agenta zwykle da się tam wysłać przez OpenTelemetry. Narzędzie specjalizowane dokładacie, gdy zespół zaczyna regularnie oceniać jakość odpowiedzi.
Licencja to nie formalność. Langfuse ma rdzeń na licencji MIT, ale część funkcji na osobnej licencji. Phoenix jest na Elastic License 2.0, która ogranicza m.in. oferowanie oprogramowania jako usługi zarządzanej. Grafana jest na AGPL-3.0. Każdą z tych licencji przy wdrożeniu powinien ocenić prawnik; zasady porządkuje poradnik o licencjach open source.
Gdzie leżą ślady. Ślady z treścią promptów to dane firmy, często także dane klientów. Samodzielny hosting zatrzymuje je we własnym środowisku. Usługa w chmurze wymaga sprawdzenia regionu, retencji i dostępu operatorów vendora.
Zespoły, które budują agentów na LangChain i LangGraph, zwykle zaczynają od LangSmith. Jego miejsce w ekosystemie LangChain opisuje poradnik LangChain.
Ewaluacje offline i online
Ślady mówią, co się stało. Ewaluacje mówią, czy to było dobre. Dokumentacja LangSmith dzieli je na dwa rodzaje, i ten podział warto przyjąć niezależnie od narzędzia.
Ewaluacja offline to test przed zmianą. Macie zestaw przypadków z oczekiwanym wynikiem: pytania typowe, trudne i takie, które wcześniej skończyły się błędem. Każda zmiana — nowy model, nowa instrukcja, nowe źródło wiedzy — przechodzi przez ten zestaw, a wynik porównuje się z poprzednią wersją. To odpowiednik testów regresji w zwykłym oprogramowaniu. W praktyce opisuje to wpis jak testować zmianę agenta przed sezonem.
Ewaluacja online to ocena działającego systemu na prawdziwym ruchu. Próbka odpowiedzi trafia do oceny, użytkownicy klikają „pomocne / niepomocne”, a system liczy odsetek spraw oddanych człowiekowi i poprawianych ręcznie. Tu wychodzą problemy, których nie było w zestawie testowym, bo klienci pytają inaczej, niż zakładał zespół.
Kto ocenia? Są trzy możliwości:
- człowiek — najdroższy, ale najlepszy przy ocenie, czy odpowiedź jest merytorycznie dobra; od tego warto zacząć,
- reguła w kodzie — sprawdza rzeczy jednoznaczne: czy odpowiedź nie jest pusta, czy zawiera numer zamówienia, czy nie przekracza progu kwoty,
- model jako sędzia — ocenia dużą liczbę odpowiedzi, na przykład zgodność ze źródłem.
Model oceniający też jest modelem. Ma te same wady co oceniany, więc jego oceny trzeba regularnie porównywać z oceną człowieka na tej samej próbce. Jeśli się rozjeżdżają, zmieniacie sędziego, a nie wynik.
Ewaluacje są częścią wytwarzania oprogramowania z AI, nie osobnym projektem. Miejsce testów i bramek w całym cyklu pokazuje poradnik AI SDLC.
Kto odpowiada za obserwowalność
Narzędzie zbiera dane. Nie decyduje, co jest błędem i kto zatrzymuje system. To trzeba ustalić w firmie, najlepiej przed uruchomieniem pilota.
| Rola | Za co odpowiada |
|---|---|
| Właściciel procesu | definicja dobrej odpowiedzi, zestaw testowy przypadków, progi jakości, decyzja o zatrzymaniu |
| IT | instrumentacja, przechowywanie śladów, retencja, dostęp, koszty infrastruktury |
| Osoba prowadząca agenta | codzienny przegląd śladów i ocen, poprawki instrukcji, eskalacje |
| Bezpieczeństwo | wykrywanie i obsługa incydentów, przegląd prób nadużycia |
| Inspektor ochrony danych i prawnik | ocena, co wolno zapisywać w śladach i jak długo |
Najczęstsza luka jest w pierwszym wierszu. IT potrafi zebrać ślady, ale nie wie, która odpowiedź na reklamację jest dobra. Jeśli właściciel procesu nie da definicji i przykładów, ewaluacja sprowadzi się do pytania „czy odpowiedź brzmi rozsądnie”, a na to modele są wyjątkowo dobrze przygotowane.
Obserwowalność dotyczy każdego agenta, nie tylko dużych systemów. Z czego składa się agent i gdzie w nim są narzędzia i uprawnienia, wyjaśnia poradnik o agentach AI. Na wypadek, gdy pomiar pokaże, że system trzeba wyłączyć, potrzebny jest też plan opisany we wpisie kto przejmie pracę, gdy automatyzacja się zatrzyma.
Jak zacząć: ślady i zestaw testowy
Nie zaczynajcie od wyboru platformy. Zacznijcie od jednego procesu, w którym AI już działa albo zaraz ruszy pilot.
Krok 1. Ślady od pierwszego dnia. Każda sprawa dostaje jeden identyfikator, a każde wywołanie modelu i narzędzia zapisuje się w śladzie przez OpenTelemetry. Zapis treści promptów włączcie świadomie: z maskowaniem danych osobowych i ustaloną retencją.
Krok 2. Koszt i czas na sprawę. Policzcie koszt tokenów i czas obsługi jednej sprawy, nie średnią miesięczną. Dopiero to pozwala porównać system AI z dzisiejszym procesem.
Krok 3. Zestaw testowy od właściciela procesu. Kilkadziesiąt prawdziwych przypadków z oczekiwanym wynikiem, w tym trudne i takie, które już kiedyś poszły źle. Każda zmiana przechodzi przez ten zestaw przed wdrożeniem.
Krok 4. Ocena próbki na produkcji. Co tydzień człowiek ocenia próbkę odpowiedzi. Gdy ocen jest za dużo, dokładacie regułę albo model jako sędziego — i sprawdzacie go na tej samej próbce.
Krok 5. Progi i reakcja. Ustalcie z góry, przy jakim odsetku złych odpowiedzi, kosztów albo błędów narzędzi system przechodzi w tryb z zatwierdzeniem człowieka albo się zatrzymuje. I kto o tym decyduje.
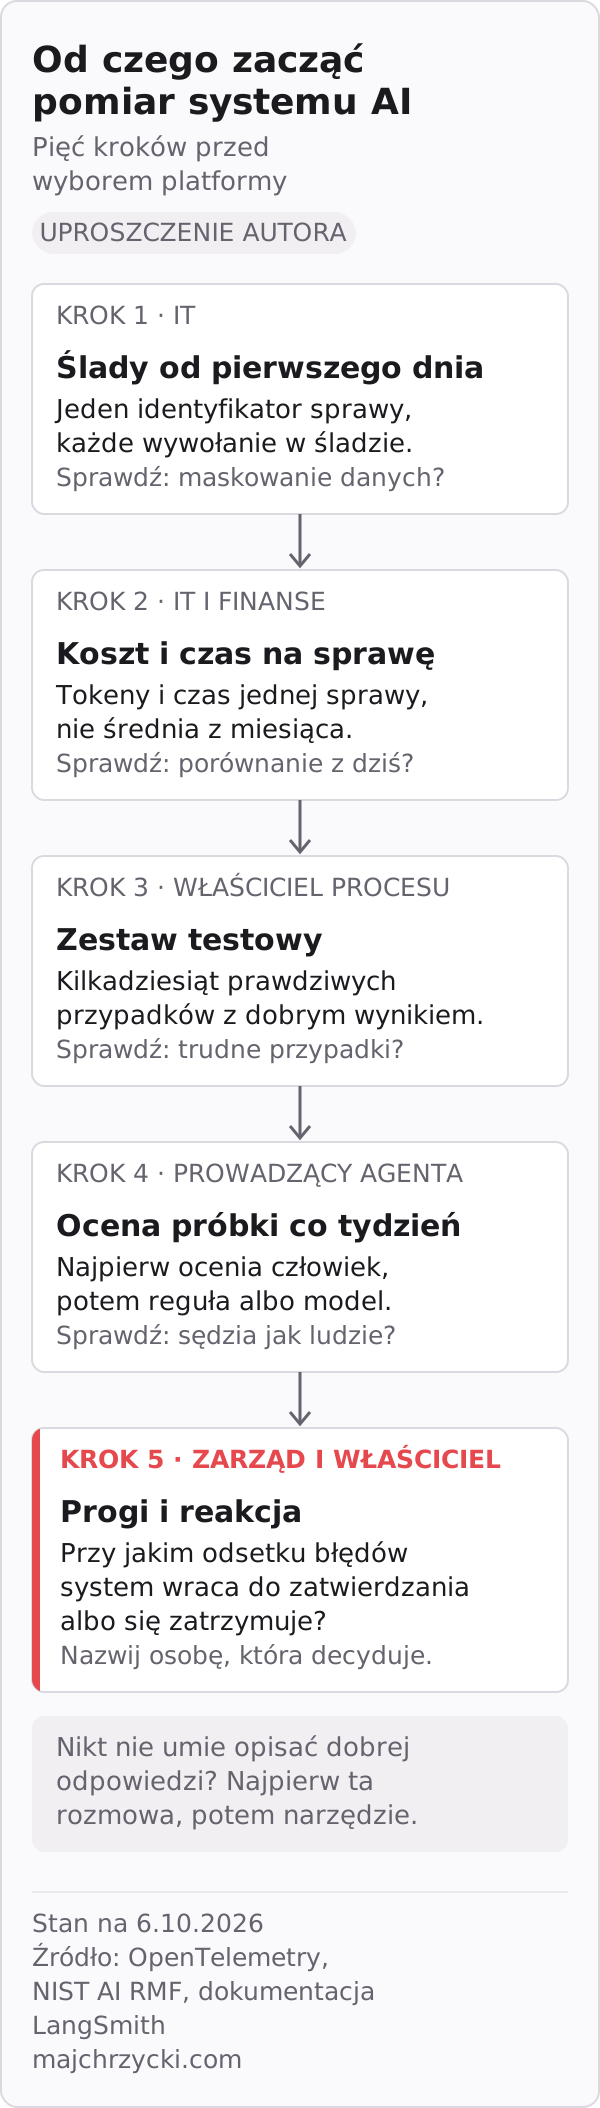
Jeśli po kroku 3 nikt nie potrafi powiedzieć, jak wygląda dobra odpowiedź, problem nie leży w narzędziu. Wtedy potrzebna jest rozmowa zarządu o tym, co system ma robić i kto odpowiada za wynik. Na tym polega prezentacja dla zarządu: nazwiemy proces, miary i osobę, która może zatrzymać system, niezależnie od vendora i partnera.
Mapa wpisów o obserwowalności AI
Wszystkie wpisy o obserwowalności, ewaluacjach i incydentach systemów AI w pięciu grupach.
A. Standard i zbieranie danych
Jak zbierać ślady, metryki i logi niezależnie od narzędzia.
- OpenTelemetry w suwerennym AI OS — jeden ślad od pytania do wywołania modelu i narzędzia.
- Prometheus w suwerennym AI OS — metryki i alerty dla usług modelowych.
- ClickStack w suwerennym AI OS — logi, ślady i metryki agentów w jednym silniku.
B. Dashboardy i platformy
Gdzie ludzie oglądają dane i szukają przyczyny problemu.
- Grafana w suwerennym AI OS — dashboardy metryk, logów i śladów.
- LGTM w suwerennym AI OS — Loki, Grafana, Tempo i Mimir jako jeden stos.
- Datadog w suwerennym AI OS — zarządzana platforma obserwowalności i bezpieczeństwa.
- Splunk w suwerennym AI OS — analiza logów w istniejącym środowisku operacyjnym.
C. Ślady i ewaluacje aplikacji LLM
Narzędzia, które pokazują rozmowę, prompt, koszt i ocenę odpowiedzi.
- Langfuse w suwerennym AI OS — otwarta platforma śledzenia i ewaluacji.
- LangSmith: jak oceniać i śledzić aplikacje AI — ewaluacje i ślady w ekosystemie LangChain.
- MLflow w suwerennym AI OS — śledzenie eksperymentów i wersji modeli.
D. Bezpieczeństwo i incydenty
Co się dzieje, gdy ktoś próbuje nadużyć systemu albo coś poszło źle.
- Wazuh w AI OS: widoczność hostów, alertów i agentów — wykrywanie zmian i podejrzanego zachowania węzłów.
- TheHive w AI OS: obsługa incydentów i koszt licencji — praca zespołu reagującego na incydent.
- Cortex w SOC dla AI OS: analiza i kontrolowana odpowiedź — analizatory i automatyczne działania w SOC.
E. Testy zmian i ciągłość pracy
Jak wdrażać zmiany bez niespodzianek i co robić, gdy system trzeba wyłączyć.
- Jak testować zmianę agenta przed sezonem? — porównanie wersji, ograniczone uruchomienie, karta wydania.
- Kto przejmie pracę, gdy firmowa automatyzacja się zatrzyma? — plan zatrzymania i przejęcia otwartych spraw.
- Obserwowalność
- Agenci AI
- Utrzymanie
- Zarząd