Microsoft Fabric w firmie: kiedy ma sens, ile kosztuje i jak z niego wyjść
Temat: Microsoft AI
Microsoft Fabric ma sens, gdy kilka osób w firmie co miesiąc ściąga, poprawia i uzgadnia te same dane z kilku systemów, a zarząd wie, kto zatwierdza wynik. Fabric to platforma danych w modelu SaaS. Płacicie za pojemność obliczeniową (w regionie Poland Central 0,1936 EUR za jednostkę CU na godzinę według API cen Azure, z którego korzysta cennik Fabric, stan na 5.10.2026), osobno za licencje Power BI i za magazyn OneLake. Platforma przyspieszy przepływ danych, ale nie ustali za Was, czym jest przychód. I ma cenę wyjścia, którą warto policzyć przed pierwszą fakturą, nie po trzecim roku.
Przewodnik jest dla zarządu i dyrektorów finansowych lub IT, którzy dostali propozycję wdrożenia Fabric. Szczegóły modułów są w osobnych wpisach, zebranych w mapie na końcu. Szerszy kontekst daje filar Microsoft AI dla firm.
Kiedy firma potrzebuje platformy danych (a kiedy nie)
Sygnałem jest powtarzana praca. Jeden analityk pobiera faktury do raportu, drugi do prognozy, trzeci znowu poprawia nazwy klientów. Każdy ma własną wersję zbioru. Uzgodnienie liczb trwa dłużej niż zrobienie wykresu, a koszt tej pracy jest ukryty w kalendarzu jednej osoby. Gdy ta osoba idzie na urlop, raport idzie razem z nią.
Rozdzielcie dwa problemy. Brak automatycznego pobierania faktur to problem dostępu do danych — zadanie integracyjne. Spór o to, czy do wyniku wliczać zaliczki, to problem znaczenia danych — decyzja biznesowa. Platforma dobrze rozwiązuje pierwszy. Drugi zostaje przy zarządzie, niezależnie od tego, co kupicie.
Cztery sytuacje, cztery decyzje
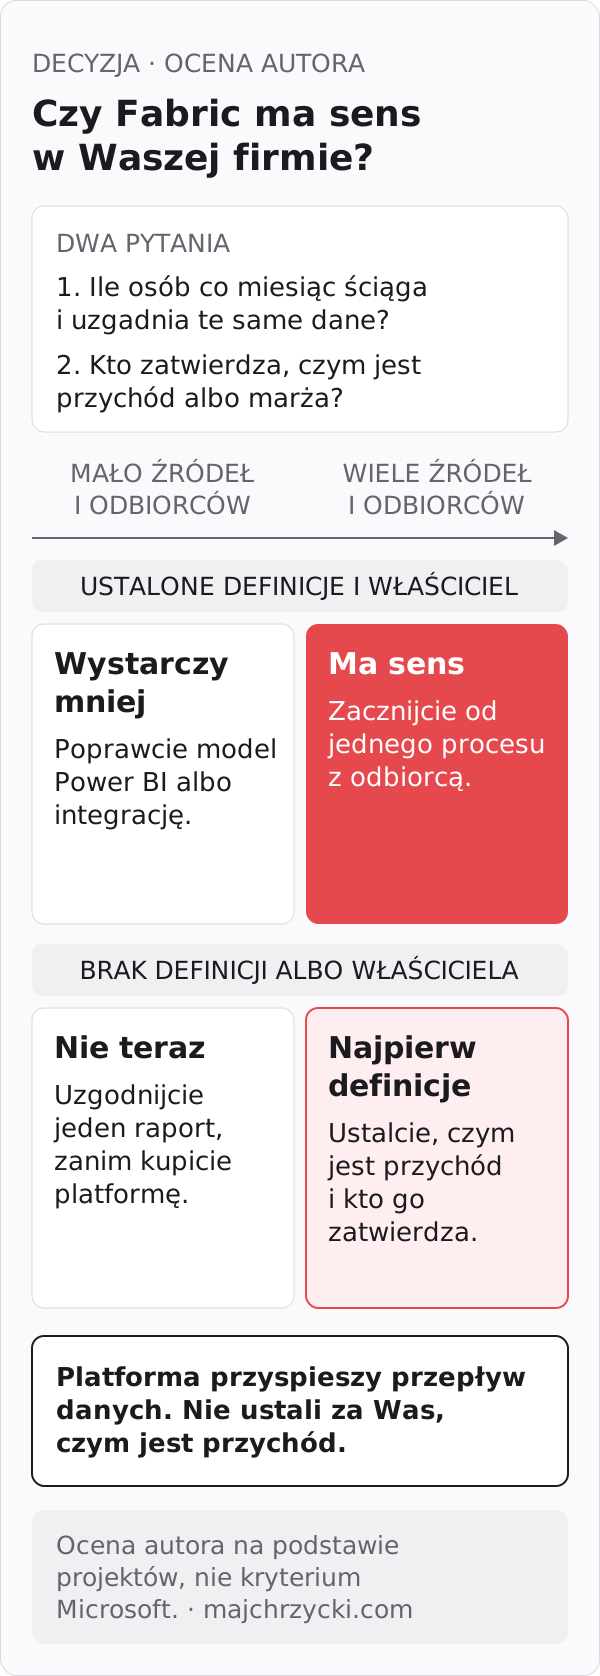
Macierz stawia dwa pytania. Ile osób co miesiąc ściąga i uzgadnia te same dane? Kto zatwierdza, czym jest przychód albo marża?
| Sytuacja | Co zrobić |
|---|---|
| Wiele źródeł i odbiorców, definicje ustalone, jest właściciel wyniku | Ma sens. Zacznijcie od jednego procesu z nazwanym odbiorcą. |
| Wiele źródeł i odbiorców, brak definicji albo właściciela | Najpierw definicje. Ustalcie, czym jest przychód i kto go zatwierdza. |
| Mało źródeł i odbiorców, definicje ustalone | Wystarczy mniej. Poprawcie model Power BI albo integrację. |
| Mało źródeł i odbiorców, brak definicji albo właściciela | Nie teraz. Uzgodnijcie jeden raport, zanim kupicie platformę. |
Sygnały, że platforma się przyda
| Obserwacja w firmie | Co uporządkować | Jak sprawdzić potrzebę |
|---|---|---|
| Kilka kopii tych samych danych | Wspólne przygotowanie zbioru | Porównajcie przekształcenia w istniejących raportach |
| Spory o liczby | Definicje i reguły rozliczenia | Uzgodnijcie wynik na próbce dokumentów |
| Ręczne codzienne eksporty | Powtarzalne zasilanie | Zmierzcie czas i liczbę poprawek |
| Rosnąca liczba źródeł | Identyfikatory i zależności | Prześledźcie jeden proces między systemami |
| Raport gotowy za późno | Automatyzacja i kontrola aktualności | Wskażcie etap, który naprawdę opóźnia wynik |
| Potrzeba prognoz lub AI | Jakość i zakres historii | Sprawdźcie kompletność wybranego okresu |
Kiedy wystarczy mniej
Jeden poprawny raport i jedno proste źródło to nie powód do budowy platformy. Często wystarczy poprawić model w Power BI albo integrację. Migracja do Fabric nie jest obowiązkowym krokiem po zakupie Power BI, a stabilny system źródłowy nie musi znikać tylko dlatego, że powstaje platforma analityczna.
Przykład: 500 000 zł zamówień, 420 000 zł faktur
W modelowym przykładzie sprzedaż pokazuje zamówienia na 500 000 zł, a finanse przychód z faktur na 420 000 zł. Różnica 80 000 zł nie musi być błędem systemu. To mogą być usługi jeszcze niewykonane albo inny okres rozliczenia. Platforma ma zachować obie definicje i pokazać ich związek, a nie wybrać jedną liczbę po cichu. To przykład syntetyczny, nie wynik wdrożenia.
Dlatego platforma danych to decyzja zarządu, nie zakup działu IT. Dział IT zbuduje przepływ. Tylko zarząd może powiedzieć, która z dwóch liczb trafia do budżetu.
Czym jest Microsoft Fabric: architektura w jednym obrazku
Fabric to platforma analityczna w modelu SaaS. Obejmuje pozyskiwanie, przekształcanie, strumienie, analitykę i raportowanie na wspólnym modelu obliczeń i magazynu (Microsoft Learn, przegląd Fabric, stan na 5.10.2026).
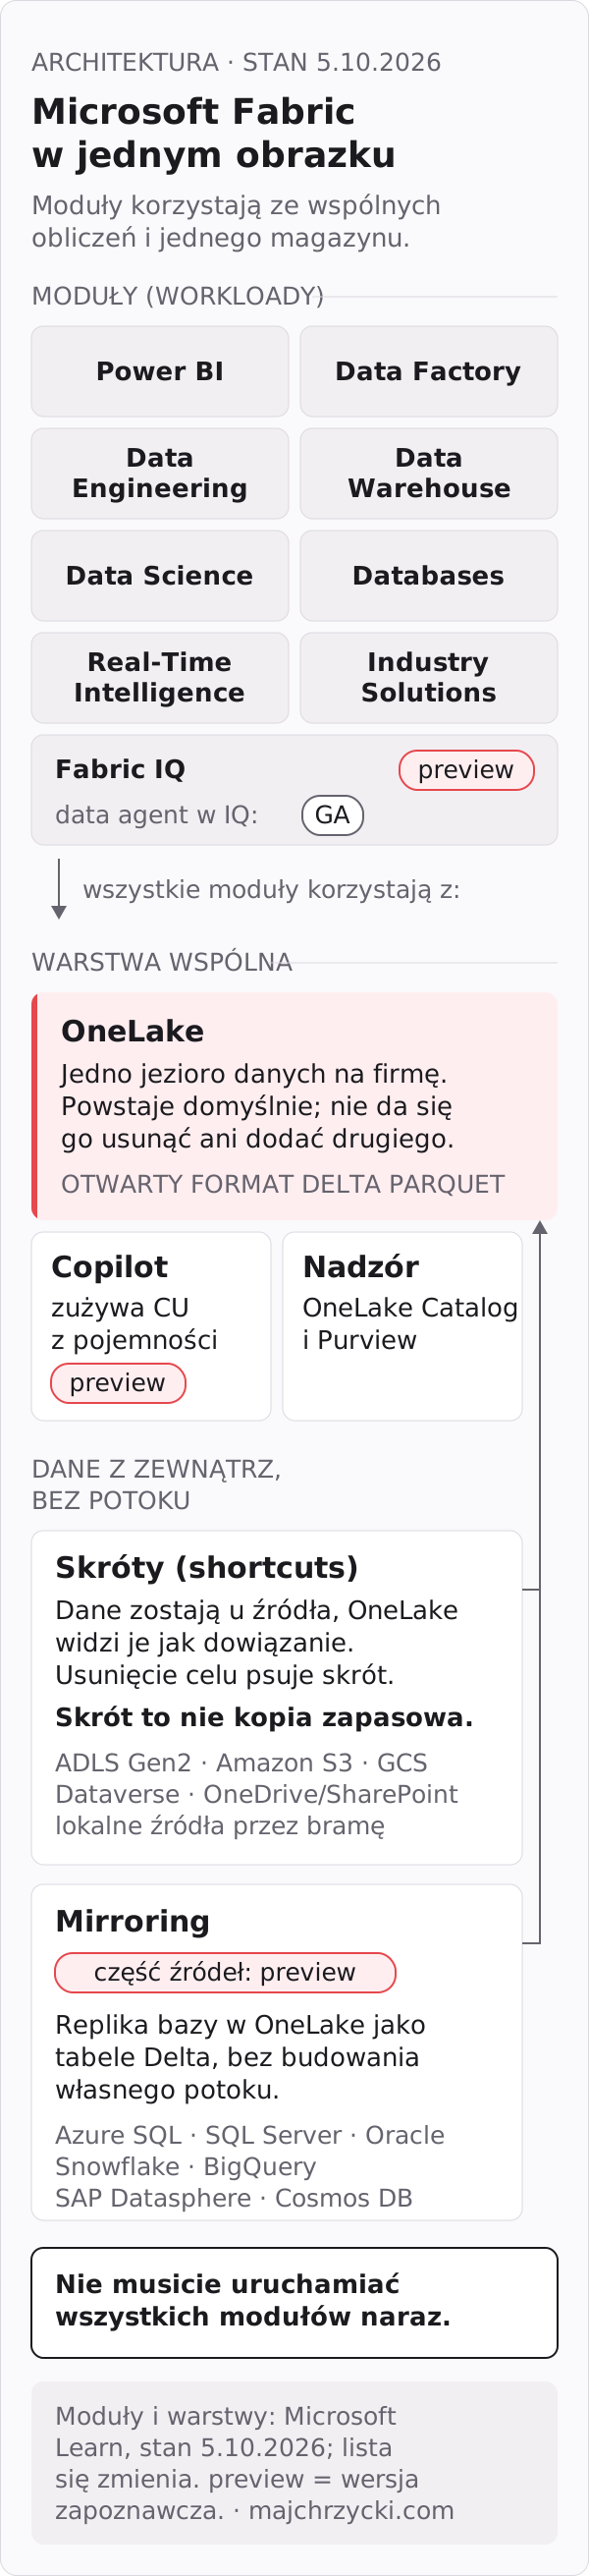
Moduły (Microsoft nazywa je workloadami) według przeglądu Learn:
- Power BI — modele i raporty.
- Data Factory — integracja danych ze źródeł.
- Data Engineering — przetwarzanie, m.in. w Spark i notebookach.
- Data Warehouse — hurtownia SQL na otwartym formacie Delta Lake.
- Data Science — uczenie maszynowe.
- Databases — bazy danych w Fabric.
- Real-Time Intelligence — zdarzenia i strumienie.
- Industry Solutions — rozwiązania branżowe.
- Fabric IQ (preview) — znaczenie danych biznesowych dla ludzi i agentów.
Pod modułami leży warstwa wspólna: OneLake, Copilot i nadzór (OneLake Catalog, Purview). Nie musicie uruchamiać wszystkich modułów w pierwszym projekcie. Każdy ma własny warunek odbioru i koszt utrzymania. Jak je złożyć, opisuje wpis o architekturze danych w Fabric.
OneLake: jedno jezioro na firmę
OneLake to jedno logiczne jezioro danych na tenant, zbudowane na Azure Data Lake Storage Gen2. Powstaje domyślnie. Nie da się go usunąć ani założyć drugiego (Learn, OneLake). Silniki Fabric zapisują dane w otwartym formacie Delta Parquet. Więcej we wpisie o OneLake.
Skróty (shortcuts) pozwalają czytać dane w innym miejscu bez kopiowania, m.in. z ADLS Gen2, Amazon S3, Google Cloud Storage i SharePoint. Działają jak dowiązania: przeniesienie lub usunięcie celu może skrót zepsuć (Learn, skróty OneLake). Skrót to więc nie kopia zapasowa. A „dostęp bez kopii” nie znaczy „bez kosztów” ani „zawsze aktualne”.
Mirroring: replika bez budowania potoku
Mirroring ma trzy odmiany: replikę bazy jako tabele Delta w OneLake, replikę samych metadanych i open mirroring, w którym Wasza aplikacja sama zapisuje zmiany (Learn, mirroring). Źródła to m.in. Azure SQL, SQL Server, Snowflake, Google BigQuery, Oracle i SAP Datasphere. Lista zmienia się często, część źródeł jest w preview — sprawdźcie swoje przed rozmową o architekturze.
Co jest gotowe, a co jeszcze w preview
Workload Fabric IQ ma status preview (Learn, Fabric IQ). Jego część, data agent, jest ogólnie dostępny (GA): od F2, nie na trialu, zwraca do 25 wierszy i 25 kolumn i nie czyta plików pdf ani docx (Learn, data agent). Data agent, który widzi 25 wierszy, nie zamknie Wam miesiąca. Ale może z pełnym przekonaniem powiedzieć, że zamknął.
Generatywne funkcje Copilota w Fabric Microsoft nadal opisuje jako preview (Learn, Copilot w Fabric). Stan poszczególnych funkcji jest na stronie statusów Copilota i AI w Fabric.
Poland Central i West Europe mają pełny zestaw workloadów. W Poland Central niedostępna jest aplikacja Fabric App w preview (Learn, dostępność regionów).
Ile kosztuje Microsoft Fabric: pojemność, licencje, magazyn
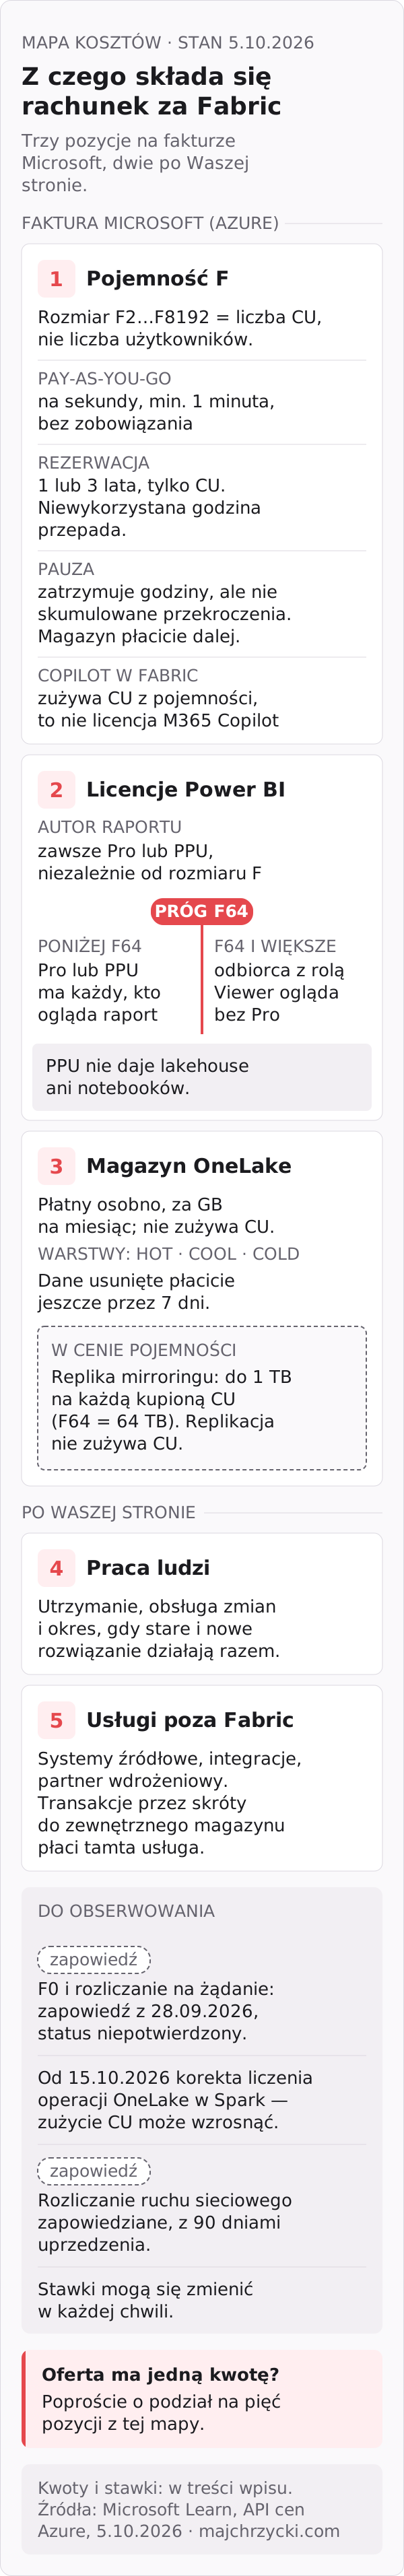
Rachunek ma trzy pozycje na fakturze Microsoft i dwie po Waszej stronie. Agent AI chętnie narysuje piękną tabelę kosztów F64 — bez daty, regionu i źródła. Tutaj każda stawka ma wszystkie trzy, a sumy liczycie w kalkulatorze.
Pięć pozycji rachunku
| Pozycja | Co obejmuje | Pytanie do osoby, która przygotowuje wycenę |
|---|---|---|
| 1. Pojemność F (Microsoft) | PAYG albo rezerwacja, pauza, Copilot, przekroczenia | Jakie obciążenie i przez ile godzin? |
| 2. Licencje Power BI (Microsoft) | Pro lub PPU dla autorów, poniżej F64 też dla odbiorców | Ilu autorów i odbiorców, ile licencji już mamy? |
| 3. Magazyn OneLake (Microsoft) | Warstwy Hot, Cool, Cold; mirroring ponad limit | Jakie dane, kopie i okresy przechowywania? |
| 4. Praca ludzi (firma) | Utrzymanie, zmiany, równoległe działanie starego i nowego | Kto pilnuje odświeżeń, uprawnień, kosztów i awarii? |
| 5. Usługi poza Fabric (firma) | Systemy źródłowe, integracje, partner wdrożeniowy | Jakie koszty powstaną poza Fabric? |
Oferta ma jedną kwotę? Poproście o podział na te pięć pozycji. Inaczej porównacie całodobową dostępność ze środowiskiem wyłączanym wieczorem.
Pojemność F: rozmiar to nie liczba ludzi
Rozmiar F to liczba jednostek CU: F2 = 2 CU, F64 = 64 CU, aż do F8192. To moc obliczeniowa, nie limit użytkowników. Rozliczenie jest na sekundy (minimum minuta), bez zobowiązania, a cena zależy od regionu. Pojemności P (Power BI Premium) są tylko dla klientów z Enterprise Agreement i Microsoft wycofuje je na rzecz F (Learn, licencje Fabric, stan na 5.10.2026).
Stawka PAYG za CU w Poland Central to 0,1936 EUR za godzinę (0,22 USD, 0,8471 PLN), tyle samo w EUR w West Europe. To ceny detaliczne bez umowy EA lub CSP, odczytane 5.10.2026 z publicznego API cen Azure, z którego korzysta cennik Fabric. Wzór na miesięczny koszt pojemności w PAYG:
liczba CU w SKU × stawka za CU na godzinę × liczba godzin, przez które pojemność jest włączona
Wynik dla swojego SKU, regionu i umowy sprawdźcie w kalkulatorze Azure i zapiszcie datę odczytu.
| SKU | CU | PAYG, EUR/h | Rezerwacja, EUR/h | Kiedy włączyć do porównania |
|---|---|---|---|---|
| F2 | 2 | 0,388 | 0,231 | Mała próba z niewielkim obciążeniem |
| F8 | 8 | 1,549 | 0,921 | Gdy próba na F2 pokazała konflikt zadań |
| F64 | 64 | 12,391 | 7,368 | Gdy uzasadnia to obciążenie albo licencje odbiorców Power BI |
Stawki godzinowe: cennik Fabric, Poland Central i West Europe (identyczne), EUR, odczyt w przeglądarce 5.10.2026. Rezerwacja na rok albo trzy lata wychodzi według Microsoftu ok. 41% taniej niż PAYG.
F2, które nie zdąży z odświeżeniem przed spotkaniem, nie jest tańszą wersją tego samego rozwiązania. Jest innym rozwiązaniem.
Rezerwacja czy pay-as-you-go
Rezerwacja na rok kosztuje 1008,45 EUR za 1 CU na cały okres, na trzy lata 3025,34 EUR (Poland Central i West Europe, ceny detaliczne, API cen Azure, 5.10.2026). Cennik podaje oszczędność ok. 41% wobec PAYG. Rezerwacja obejmuje tylko CU, nie magazyn ani sieć. Rabat działa godzina po godzinie, a niewykorzystana godzina przepada (Learn, rezerwacje Fabric).
Przy oszczędności 41% rezerwacja kosztuje ok. 59% całodobowego PAYG. Jeśli pojemność potrzebna jest przez 30% czasu, rezerwacja to dopłata, nie rabat.
| Wzorzec pracy | Co porównać |
|---|---|
| Krótki pilotaż, nieznane obciążenie | PAYG, dopóki nie macie pomiarów |
| Praca całodobowa | Rezerwację z PAYG w tym samym zakresie |
| Praca w wybranych godzinach | Pełną rezerwację i PAYG z pauzą |
| Rosnące obciążenie | Stała część w rezerwacji, zmienna w PAYG |
Pauza nie anuluje rachunku
Wstrzymanie pojemności zatrzymuje naliczanie godzin. Skumulowane przekroczenia są jednak sumowane i dodawane do rachunku Azure. Magazyn płacicie dalej, a mirroring przestaje działać (Learn, pauza i wznowienie).
Przed automatyczną pauzą: uzgodnijcie godziny pracy z odbiorcami raportów, sprawdźcie zadania w tle i zróbcie próbę wznowienia. Oszczędność w kalkulatorze musi odpowiadać sposobowi pracy, który ludzie zaakceptują.
Licencje Power BI i próg F64
Autor treści Power BI zawsze potrzebuje Pro albo PPU. Poniżej F64 Pro lub PPU potrzebuje też każdy, kto ogląda raport. Od F64 odbiorca z darmową licencją i rolą Viewer ogląda raporty bez Pro. PPU nie tworzy pojemności Fabric: nie daje lakehouse, hurtowni ani notebooków (Learn, licencje Fabric). „50 × PPU” i „F2” to nie dwie wersje tej samej usługi.
Power BI Pro kosztuje 12,10 EUR, a PPU 20,80 EUR za użytkownika miesięcznie (cennik Power BI, widok pl-pl, 5.10.2026); w USA 14 i 24 USD przy płatności rocznej (cennik USA). Przykład: 50 osób × 14 USD = 700 USD miesięcznie (cennik USA, 5.10.2026). Cena w złotych zależy od umowy — sprawdźcie ją u swojego partnera licencyjnego.
Czy F64 „zwróci się” licencjami? Policzcie: (koszt F64 − koszt mniejszej pojemności, która wystarcza wydajnościowo) ÷ cena Pro = liczba odbiorców, którym musielibyście kupić nowe Pro. Licencje już posiadane liczcie osobno, bo potrafią odwrócić wynik. Osadzanie raportów dla klientów zewnętrznych ma osobne reguły.
Magazyn OneLake i mirroring
Magazyn jest płatny osobno, za GB na miesiąc, i nie zużywa CU. Stawki w EUR za GB miesięcznie: Hot 0,0212, Cool 0,0116, Cold 0,0044 (Poland Central i West Europe, cennik Fabric, 5.10.2026). Dane usunięte miękko płacicie jeszcze przez 7 dni (Learn, zużycie OneLake). Replika mirroringu jest bezpłatna do 1 TB na każdą kupioną CU (F64 = 64 TB), a replikacja nie zużywa CU (Learn, mirroring).
Copilot w Fabric to zużycie CU, nie licencja Microsoft 365 Copilot
Copilot w Fabric zużywa CU z Waszej pojemności: miernik „Copilot and AI” kosztuje 0,1936 EUR za CU na godzinę (API cen Azure, 5.10.2026). Działa od F2, nie na trialu, i przetwarza zapytania w USA albo w EU Data Boundary (Learn, Copilot w Fabric). To nie jest licencja Microsoft 365 Copilot do Outlooka i Worda. Szczegóły: Copilot w Microsoft Fabric.
Trial: 60 dni na ocenę, nie na produkcję
Trial trwa 60 dni, ma pojemność F4 albo F64 i do 1 TB w OneLake. Nie obejmuje Copilota ani data agenta. Po wygaśnięciu dane zostają przez 7 dni (Learn, trial Fabric). Trial pokaże interfejs, ale nie koszt Waszego zamknięcia miesiąca.
Co się zmienia jesienią 2026
- 28.09.2026 Microsoft zapowiedział rozliczanie na żądanie i pojemność F0 bez opłaty z góry (blog Azure). Status i dostępność w Poland Central sprawdźcie na stronie licencji Fabric, zanim zmienicie plan.
- Od 15.10.2026 Fabric skoryguje raportowanie części operacji OneLake w zadaniach Spark. Stawki zostają, ale zużycie CU może wzrosnąć (Learn, zużycie OneLake).
Ludzie to też koszt
Przykład modelowy: cztery osoby po pięć godzin miesięcznie uzgadniają dane, razem 20 godzin. Po zmianie kontrola zajmuje 8 godzin. 12 godzin × umowne 150 zł to 1800 zł miesięcznie — przed kosztem usług i wdrożenia. To sposób liczenia, nie gwarancja.
Rozpiszcie też koszt na jednostkę zrozumiałą dla zamawiającego. Utrzymanie za 6000 zł miesięcznie przy 60 projektach to 100 zł na projekt, przy 30 projektach — 200 zł (przykład syntetyczny). Cudzy procent ROI nie przenosi się na Waszą firmę.
Jeśli po tej sekcji nie umiecie wskazać, kto odpowiada za które dane i ile kosztuje Wasz dzisiejszy stan, wycena Fabric będzie zgadywaniem. Najpierw potrzebna jest mapa danych i ich właścicieli. Zobaczcie zakres audytu i mapy danych.
Lakehouse w praktyce
Lakehouse łączy jezioro danych (data lake) z tabelami i dostępem analitycznym. W Fabric dane lakehouse są w Delta Lake (transakcje ACID, wymuszanie schematu, podróż w czasie), a dostęp jest przez Spark i SQL (Learn, lakehouse). Wybieracie go według danych, sposobu przetwarzania i kompetencji zespołu, nie według nazwy na schemacie. Budowę rozwiązań data lake opisuje wpis o data lake w Fabric.
Lakehouse czy warehouse
| Kryterium | Kiedy sprawdzić lakehouse | Kiedy sprawdzić warehouse |
|---|---|---|
| Sposób tworzenia transformacji | Spark i notebooki | Przede wszystkim T-SQL |
| Materiał wejściowy | Różne pliki i dane do przygotowania | Uporządkowane dane tabelaryczne |
| Główne zastosowanie | Inżynieria danych, eksperymenty, analityka | Modele raportowe i analityka SQL |
| Utrzymanie | Kompetencje obsługi przetwarzania | Kompetencje zarządzania rozwiązaniem SQL |
To kryteria startu próby, nie werdykt. Oba mogą współistnieć — wtedy wskażcie, który zbiór jest źródłem raportu i kto odpowiada za jego zmianę. Wariant SQL opisuje wpis o Data Warehouse w Fabric.
SQL w lakehouse to nie pełna hurtownia
Punkt końcowy SQL lakehouse jest tylko do odczytu i nie ma pełnego T-SQL. Widzi wyłącznie tabele Delta — wgrany plik CSV czy Parquet nie pojawi się tam jako tabela. Od 5 września 2025 utworzenie lakehouse nie tworzy już domyślnego modelu semantycznego Power BI (Learn, lakehouse). Model trzeba zaplanować i wycenić osobno.
Zamiast deklaracji „używamy Delta” poproście wykonawcę o pokaz. Przerwijcie zasilanie i zobaczcie, czy odbiorcy widzą poprawny, rozpoznawalny stan danych.
Warstwy jakości z warunkiem przejścia
Podział bronze, silver i gold nazywa etapy. Jakości nie nadaje. Potrzebny jest warunek przejścia:
| Etap | Przykład w firmie usługowej | Warunek przejścia dalej |
|---|---|---|
| Materiał wejściowy | Eksport czasu pracy z systemu projektowego | Znane źródło, okres i kompletność pliku |
| Dane uporządkowane | Godziny połączone z projektami | Wyjaśnione brakujące identyfikatory i duplikaty |
| Dane do decyzji | Koszt realizacji według projektu i miesiąca | Zatwierdzony sposób liczenia i zgodność próbki |
W modelowym zbiorze jest 1000 wpisów czasu pracy: w 30 brakuje projektu, 20 to duplikaty. Raport z pozostałych 950 to nie „kompletne zasilenie”, dopóki ktoś nie rozliczy tych 30. Folder „gotowe” nie jest dowodem jakości.
Lakehouse dla AI
Zbiór do modelu predykcyjnego może zawierać tylko informacje znane przed decyzją. Jeśli do prognozy opóźnień trafią dane dopisane po opóźnieniu, eksperyment wyjdzie podejrzanie dobrze. Odłóżcie część danych do niezależnej oceny. A dokumenty w lakehouse nie znaczą, że agent wybierze aktualny fragment. Więcej we wpisie o Data Science w Fabric.
Cena wyjścia i ryzyko vendora
Dane z Fabric da się wyjąć stosunkowo łatwo. Trudno wyjąć to, co zbudowaliście wokół nich. Pytanie dla zarządu: ile kosztuje zmiana platformy albo partnera wdrożeniowego?
Co wychodzi łatwo
Dane leżą w otwartym formacie Delta Parquet, a OneLake obsługuje też Apache Iceberg (Learn, OneLake). Z zewnątrz połączycie się przez interfejsy zgodne z ADLS Gen2, Azure Storage Explorer czy Databricks. OneLake obsługuje jednak tylko podzbiór API ADLS Gen2 i Blob (Learn, skróty OneLake), więc nie każde narzędzie zadziała bez prób.
Co nie wychodzi samo
Otwartość formatu nie przenosi aplikacji, zabezpieczeń i reguł. Potoki, notebooki, modele semantyczne, raporty, uprawnienia i konfigurację agentów trzeba będzie przebudować. OneLake jest jeden na tenant i nie da się go usunąć. To nie zarzut wobec Fabric. Chodzi o to, żeby tę cenę znać z góry.
Ruch między chmurami i sieć
Skróty do Amazon S3 i Google Cloud Storage mają opcjonalną pamięć podręczną na 1–28 dni, która zmniejsza koszt wyjścia danych między chmurami (Learn, skróty OneLake). Transakcje przez skrót do zewnętrznego magazynu płaci tamta usługa, na Waszym rachunku (Learn, zużycie OneLake). Cennik zapowiada rozliczanie ruchu sieciowego z 90-dniowym uprzedzeniem — aktualny stan jest na stronie cennika Fabric.
Ryzyko vendora
Stawki zużycia mogą zmienić się w każdej chwili. Microsoft deklaruje „rozsądne starania” o powiadomienie, a przy istotnym wzroście daje opcję anulowania metody płatności (Learn, zużycie OneLake). Do tego wycofywanie SKU P, korekta liczenia od 15.10.2026 i funkcje w preview. Rezerwacja na trzy lata to zobowiązanie wobec wszystkich tych zmian. Zwroty i wymiany rezerwacji mają limit 50 000 USD w ciągu 12 miesięcy (Learn, rezerwacje Fabric).
Lista „przed podpisaniem”
Moje zalecenia przed umową z partnerem wdrożeniowym:
- tenant, subskrypcja Azure i pojemność są na koncie firmy, nie partnera;
- definicje miar i reguły przekształceń są zapisane obok zbiorów, nie w głowie autora;
- dokumentacja pozwala innemu wykonawcy przejąć system;
- oferta opisuje sposób wyjścia: przekazanie danych, dokumentacji i zależności potrzebnych do odtworzenia analiz.
Porównujecie Fabric z innymi platformami? Zajrzyjcie do filaru Dane i wiedza firmy i do porównań ze Snowflake, Databricks i Google BigQuery. Ta sama próbka, te same reguły, te same warunki odbioru. Inaczej porównujecie dwa pokazy, nie dwie platformy.
Pierwszy proces: próba, której nie da się oszukać
Zacznijcie od jednego procesu z nazwanym odbiorcą i kryterium poprawności. Nie od przenoszenia wszystkiego.
Kontrakt na wynik
Zapiszcie odbiorcę, zakres danych, częstotliwość i kryterium poprawności. Częstotliwość wynika z terminu decyzji: dane co minutę nie pomogą, jeśli decyzja zapada raz dziennie. Jeśli spotkanie zaczyna się o 9:00, informacja o nocnym błędzie musi dotrzeć do właściwej osoby wcześniej.
Dopiszcie warunek zatrzymania publikacji: brak danych z ważnego systemu raport ma pokazać, zanim ktoś podejmie na nim decyzję. Ustalcie, kto zatwierdza zmiany. Gdy pole „wartość” zacznie oznaczać kwotę po rabacie, a „koszt” obejmie podwykonawców, poprawne technicznie odświeżenie nie uchroni raportów przed błędną interpretacją. Każdy udostępniany zbiór ma więc właściciela.
Najmniejszy zestaw elementów
Nie projektujcie rozwiązania przez odhaczanie ikon produktu. Dla każdego elementu zadajcie pytanie: co się stanie, jeśli go usuniemy? Jeśli nic ważnego, w pierwszej wersji jest zbędny.
Dostęp każdą drogą
Raport to tylko jedna droga do danych. Są jeszcze notebooki, zapytania SQL i eksport. Testujcie dostęp kontami prawdziwych ról: czy kierownik widzi stawki konkretnych osób, czy tylko sumy projektu? Konta integracji nie mogą zależeć od urlopu autora. Sprawdźcie też odebranie dostępu po zmianie roli. Pusty wynik nie może wyglądać jak brak kosztów.
Tabela odbioru
| Próba | Dowód | Powód zatrzymania |
|---|---|---|
| Typowe zasilenie | Wynik zgodny z dokumentami źródłowymi, przed terminem użycia | Niewyjaśnione różnice |
| Spóźnione dane | Jawny status dla odbiorcy | Nieaktualne dane bez ostrzeżenia |
| Ponowienie zadania | Brak podwojenia rekordów | Duplikaty po drugim uruchomieniu |
| Korekta historycznego okresu | Przeliczenie właściwego okresu, informacja dla odbiorców | Wynik niezgodny z regułą |
| Zmiana struktury źródła | Czytelny błąd albo zatwierdzona obsługa | Nowe pole po cichu zmienia wynik |
| Brak uprawnień | Odmowa właściwej operacji | Dostęp do wykluczonego zakresu |
| Awaria źródła | Wykrycie, diagnoza, odtworzenie | Pozornie poprawna liczba w raporcie |
| Koszt | Pomiar przy typowym obciążeniu i przy zamknięciu miesiąca | Brak podstaw do prognozy |
| Przejęcie | Druga osoba usuwa przygotowany błąd z samej dokumentacji | Trzeba szukać autora |
Szczegółowe listy są we wpisach o odbiorze potoku danych i odbiorze integracji w Data Factory.
Dziennik pilotażu
Dla każdego uruchomienia zapiszcie rozmiar danych, start, koniec, zadania równoległe i wynik: poprawny, niepełny albo błąd. Pierwsze załadowanie historii mierzcie osobno od codziennych przyrostów, bo jednorazowa migracja kilku lat danych przewymiaruje stałą pojemność. Po pilocie przejrzyjcie zasoby robocze: co do utrzymania, co do prób, co do usunięcia.
Właściciel po uruchomieniu
Ustalcie, kto ocenia nowe prośby, zatwierdza reguły i pilnuje kosztów. Kolejny raport nie powinien powstawać tylko dlatego, że łatwo go zbudować. Jak to zorganizować, opisują wpisy o centrum doskonałości dla Power BI i Fabric i o Purview w Fabric.
Fabric i AI: Copilot, data agent, Fabric IQ
Wynik zapytania wygenerowanego przez Copilota albo data agenta sprawdzajcie tak samo jak ręcznego: źródło, okres, reguła. Odpowiedź brzmiąca pewnie nie rozstrzyga, czy agent wybrał właściwą definicję przychodu. Agent nie wie, że u Was zaliczki się nie liczą — chyba że ktoś mu to zapisał. Więcej: data agent w Fabric, Fabric IQ i semantyka danych biznesowych, fundamenty dla AI z Fabric i Copilot Studio.
Mapa wpisów o Fabric: od czego zacząć
Zarząd: zacznijcie od sekcji o tym, kiedy platforma ma sens, i od kosztów. Analityk: architektura i lakehouse. IT: odbiór potoków i integracji.
- Decyzja i koszty: Microsoft Power BI · Power BI w Fabric · Copilot w Fabric
- Architektura i moduły: architektura danych z Fabric · OneLake · Data Factory · Data Engineering · Data Warehouse · Databases · Real-Time Intelligence · Data Science · Industry Solutions
- Lakehouse i hurtownia: data lake i platforma danych dla AI · hurtownia danych i platforma dla AI
- Wdrożenie i nadzór: odbiór potoku danych · odbiór integracji w Data Factory · centrum doskonałości (CoE) · Purview w Fabric
- AI na danych z Fabric: data agent · Fabric IQ · Fabric i Copilot Studio
- Porównania z innymi platformami: Snowflake · Databricks · Google BigQuery · Amazon Redshift · IBM Cloud Pak for Data · KNIME · Oracle ADW · SAP Business Data Cloud
Na najbliższe spotkanie
Przynieście jeden raport, o który się spieracie. Wskażcie jego źródła, dwie definicje i osobę, która zatwierdza wynik. Jeśli takiej osoby nie ma, to jest pierwsza decyzja do podjęcia — i nie podejmie jej ani Fabric, ani dział IT. Dopiero na tym raporcie planujcie próbę platformy.
- Agenci AI
- Dane i analityka
- Zarządzanie zmianą
- Regulacje
