Jak wykorzystać dane firmy w AI? RAG — poradnik dla biznesu
Temat: Dane i wiedza firmy
Model AI sam nie zna danych Waszej firmy — zna tylko to, czego nauczył się przed datą zakończenia treningu. Żeby odpowiadał z regulaminu, cennika albo instrukcji serwisowej, trzeba mu te dokumenty dostarczyć. Do tego służy RAG (retrieval-augmented generation): system przy każdym pytaniu wyszukuje właściwe fragmenty dokumentów i podaje je modelowi jako podstawę odpowiedzi. RAG nie jest jednak jedyną drogą ani magiczną. Ma swoje koszty, zależy od jakości źródeł i nie naprawi bałaganu w uprawnieniach.
Ten poradnik jest dla zarządu i menedżerów, którzy słyszą „podłączmy AI do naszych danych” i chcą wiedzieć, co to znaczy, ile to wymaga pracy i który wariant pasuje do ich pytań. Na blogu jest kilka szczegółowych wpisów o RAG — tutaj są zebrane w jedną mapę. Szerszy kontekst przygotowania danych i wiedzy firmy daje filar Dane i wiedza firmy.
Dlaczego model sam nie zna danych firmy
Duży model językowy (LLM) to program, który na podstawie ogromnej ilości tekstu nauczył się przewidywać kolejne słowa. Robi to bardzo dobrze. Ale ma cztery ograniczenia, które w firmie widać od pierwszego dnia. Szerzej o tym, co LLM potrafi, a czego nie, piszę w artykule Duże modele językowe: możliwości i ograniczenia.
1. Wiedza kończy się na dacie treningu
Model wie to, co było w danych treningowych. Vendorzy podają dla każdego modelu datę, do której sięga jego wiedza — na przykład Anthropic w przeglądzie modeli Claude podaje osobno datę graniczną wiarygodnej wiedzy („reliable knowledge cutoff”) i danych treningowych. Wasz cennik z zeszłego tygodnia nie trafił do treningu. Wewnętrzna procedura reklamacji też nie, bo nigdy nie była publiczna.
2. Model zgaduje zamiast mówić „nie wiem”
Gdy model nie zna odpowiedzi, często i tak ją podaje — płynnie i z przekonaniem. To halucynacja. Badacze OpenAI w pracy Why Language Models Hallucinate (2025) tłumaczą to tym, że trening i testy nagradzają zgadywanie bardziej niż przyznanie się do niepewności. Model zapytany o Wasz regulamin urlopowy odpowie równie pewnym tonem jak o tabliczkę mnożenia, choć regulaminu nigdy nie widział.
3. Model nie wie, kto pyta
Model nie ma pojęcia o uprawnieniach. Nie wie, że dane płacowe widzi tylko kadrowa, a marże — tylko zarząd. Microsoft w dokumentacji RAG w Azure AI Search wymienia bezpieczeństwo jako jedno z głównych wyzwań: użytkownicy i agenci mają dostawać tylko treści, do których mają prawo. Tego model sam nie zapewni. To zadanie systemu wokół niego.
4. Nie wszystko zmieści się w jednym pytaniu
Model przyjmuje ograniczoną ilość tekstu naraz (okno kontekstu). Okna rosną, ale wklejenie całego archiwum firmy nadal nie jest dobrym pomysłem. Badanie Lost in the Middle (Liu i in., 2023) pokazało, że modele najlepiej korzystają z informacji na początku i na końcu długiego tekstu, a gorzej z tej w środku. Więcej tekstu to też wyższy koszt i dłuższy czas odpowiedzi.
Cztery drogi do wiedzy firmy
Są cztery podstawowe sposoby, żeby model korzystał z wiedzy firmy. Różnią się tym, co zmieniają: pytanie czy sam model.
1. Prompt z dokumentem. Pracownik wkleja plik do rozmowy i pyta. Działa od ręki i dobrze sprawdza się przy jednym dokumencie. Ale nie skaluje się: każdy musi sam znaleźć właściwą wersję pliku, a nikt nie kontroluje, co trafia do modelu.
2. RAG. Aplikacja sama wyszukuje fragmenty dokumentów i dołącza je do pytania. Model się nie zmienia — zmienia się to, co dostaje. Wzorzec opisali Patrick Lewis i współautorzy w pracy Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (NeurIPS 2020): pamięć modelu łączy się z zewnętrznym indeksem dokumentów.
3. Fine-tuning. Model jest dotrenowywany na przykładach. Uczy się sposobu działania: formatu, tonu, kategorii. OpenAI w przewodniku o optymalizacji dokładności ujmuje to prosto: RAG, gdy modelowi brakuje wiedzy; fine-tuning, gdy model działa niespójnie. Microsoft w omówieniu fine-tuningu dodaje, że trening trzeba powtarzać po zmianie danych albo modelu bazowego.
4. RAFT, czyli oba naraz. Retrieval Augmented Fine-Tuning to metoda z pracy Zhang i in. (2024): model jest trenowany tak, żeby w RAG korzystał z właściwych dokumentów i ignorował te, które tylko wyglądają podobnie. To krok dla zespołów, które mają już działający i zmierzony RAG.
Obok tych czterech dróg jest piąta warstwa: narzędzia i agenci. Agent AI może nie tylko czytać dokumenty, ale też zapytać system ERP o stan magazynu albo CRM o historię klienta. Liczby powinny pochodzić z systemu źródłowego, a nie z akapitu w PDF-ie. RAG wyjaśnia, co znaczy „marża”; zapytanie do systemu podaje jej wartość.
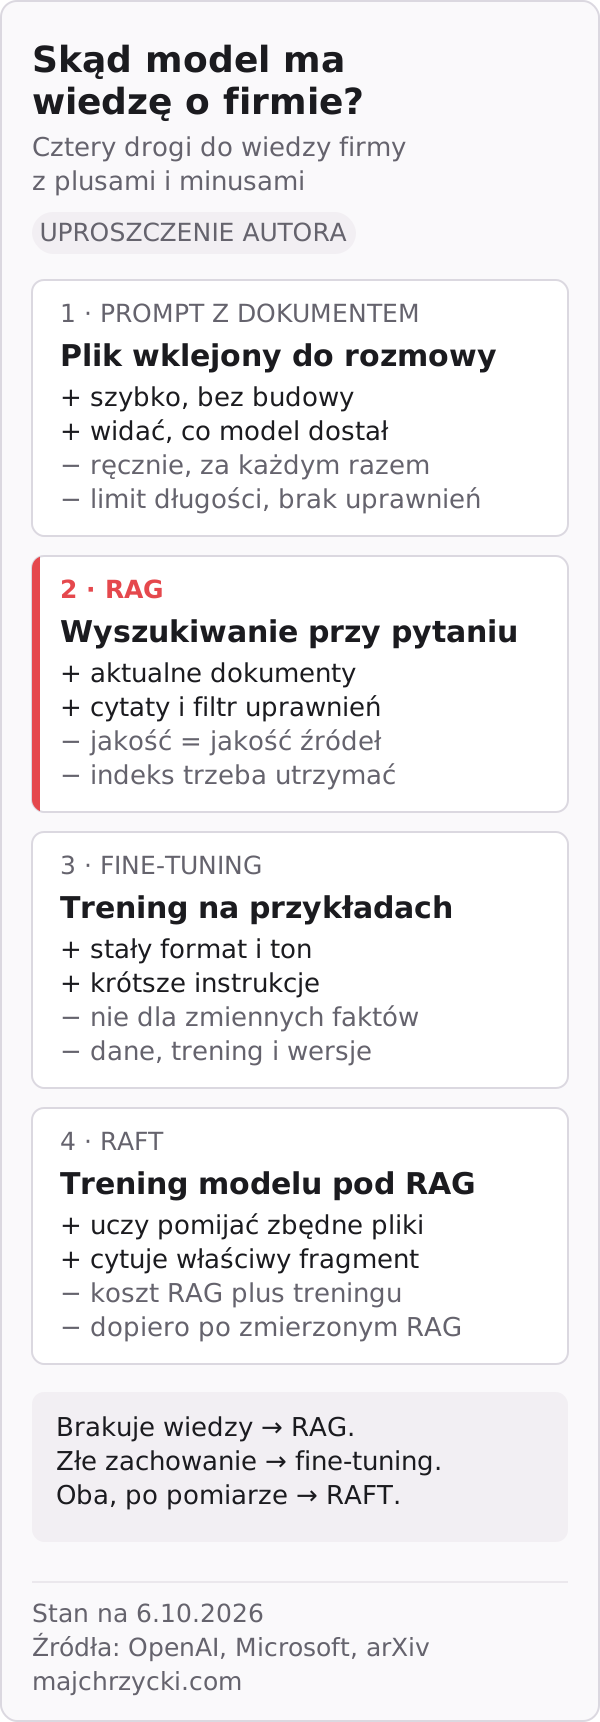
| Droga | Co zmienia | Plusy | Minusy |
|---|---|---|---|
| Prompt z dokumentem | pytanie, ręcznie | szybko, bez budowy | ręcznie, limit długości, brak kontroli uprawnień |
| RAG | pytanie, automatycznie | aktualne dokumenty, cytaty, filtr uprawnień | jakość zależy od źródeł, indeks trzeba utrzymać |
| Fine-tuning | sam model | stały format i ton, krótsze instrukcje | nie dla zmiennych faktów, potrzebne dane i wersje |
| RAFT | model i pytanie | model lepiej pomija zbędne dokumenty | koszt RAG plus koszt treningu |
Porównanie RAG, fine-tuningu i RAFT według rodzaju problemu rozwija wpis RAG, fine-tuning czy RAFT: jak wybrać. Kiedy trening modelu naprawdę się opłaca, opisuje Fine-tuning modelu: kiedy warto go przeprowadzić, a samą metodę RAFT — RAFT: trening modelu dla domenowego RAG.
Jak działa RAG w pięciu krokach
RAG wygląda z zewnątrz jak zwykły czat. W środku dzieje się pięć rzeczy. Microsoft opisuje ten przepływ w przewodniku Azure Architecture Center o projektowaniu RAG.
- Źródła. Firma wybiera dokumenty, z których system ma odpowiadać: procedury, instrukcje, umowy wzorcowe. Każde źródło ma właściciela, wersję i listę osób, które mogą je czytać.
- Indeks. Dokumenty są dzielone na krótkie fragmenty i zapisywane w wyszukiwarce razem z metadanymi: datą, działem, uprawnieniami.
- Wyszukanie. Gdy pracownik zadaje pytanie, system szuka najbardziej pasujących fragmentów — tylko wśród tych, które ten pracownik ma prawo zobaczyć.
- Pytanie z kontekstem. Znalezione fragmenty trafiają do modelu razem z pytaniem i instrukcją: „odpowiadaj tylko na podstawie tych fragmentów”.
- Odpowiedź ze źródłem. Model odpowiada i wskazuje, z którego dokumentu korzystał. Gdy fragmentów brak, mówi „nie wiem” albo przekazuje sprawę człowiekowi. Anthropic w poradniku o ograniczaniu halucynacji zaleca właśnie to: pozwolić modelowi przyznać się do niewiedzy i wymagać cytatu przy każdym twierdzeniu.
Kroki 1 i 3 to praca dla firmy, nie dla modelu. To tam rozstrzyga się, czy odpowiedź będzie poprawna i czy nie wycieknie. Jak przygotować dokumenty, podzielić je na fragmenty i zmierzyć jakość odpowiedzi, opisuje wpis RAG w Azure: dane, chunking i ewaluacja.
Plusy i minusy RAG
RAG nie jest wolny od wad. Ma je, tylko łatwiej je kontrolować niż wady innych dróg.
Plusy:
- Aktualność bez treningu. Zmieniacie dokument, odświeżacie indeks — model od razu odpowiada z nowej wersji.
- Źródło przy odpowiedzi. Pracownik widzi, z którego dokumentu pochodzi odpowiedź, i może to sprawdzić.
- Uprawnienia. Filtr w wyszukiwarce pozwala pokazać każdemu tylko to, co może zobaczyć. Microsoft opisuje to w dokumentacji filtrów bezpieczeństwa Azure AI Search.
- Wymienny model. Indeks i dokumenty zostają w firmie. Gdy vendor wyda nowy model, nie trzeba niczego trenować od nowa.
Minusy:
- Śmieci na wejściu, śmieci na wyjściu. Trzy wersje tej samej procedury w indeksie to trzy różne odpowiedzi. RAG nie wie, która wersja obowiązuje, jeśli nikt mu tego nie powie.
- Wyszukiwanie może chybić. Jeśli właściwy fragment nie trafi do modelu, najlepszy model nie odpowie poprawnie. Zmiana promptu tego nie naprawi.
- Utrzymanie. Indeks, aktualizacje, usuwanie wycofanych dokumentów, testy po każdej zmianie — to stała praca, nie jednorazowy projekt.
- Nowe ryzyka. Dokument może zawierać ukryte polecenie dla modelu (prompt injection), a źle ustawiony indeks może zwrócić cudzy dokument. OWASP LLM Top 10 2026 wymienia oba ryzyka i podpowiada, jak je testować.
- Słabość przy pytaniach przekrojowych. Klasyczny RAG szuka kilku pasujących fragmentów. Na pytanie „jakie są główne przyczyny reklamacji w całym roku?” jeden akapit nie odpowie.
Który wariant RAG gdzie
RAG ma kilka odmian. Wybór zależy od rodzaju pytań, nie od mody. Poniżej sytuacje, w których każdy wariant ma sens, i wpis, który opisuje go szczegółowo.
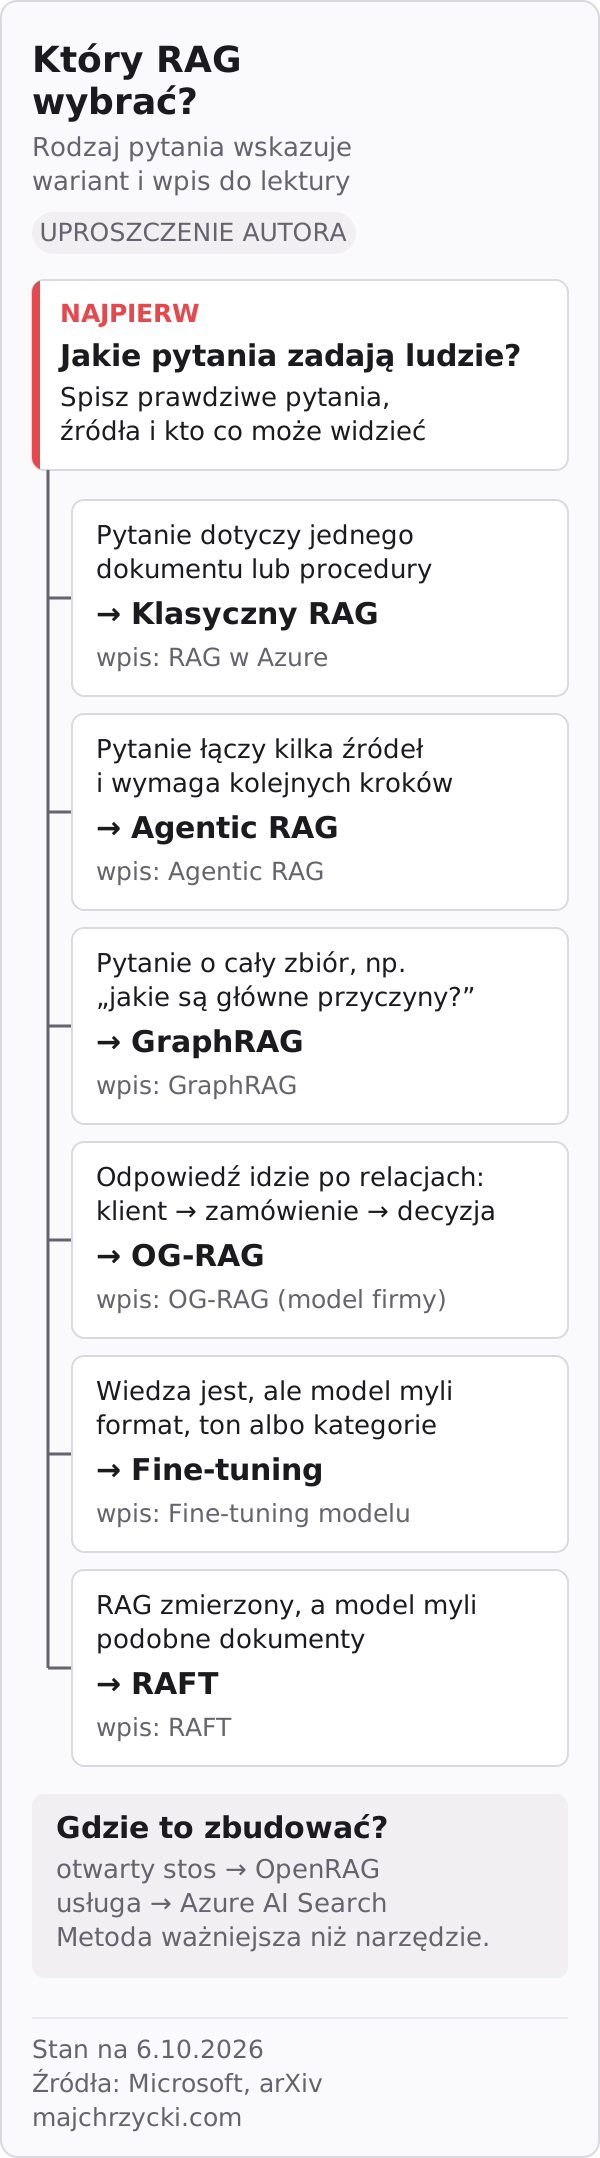
Mapa wpisów o RAG
Tabela zbiera wpisy o RAG według sytuacji w firmie. Wszystkie drogi naraz, z matrycą wyboru, porównuje wpis RAG, fine-tuning czy RAFT.
| Sytuacja w firmie | Podejście | Wpis do lektury |
|---|---|---|
| Pracownicy pytają o konkretną procedurę, instrukcję albo zapis umowy | klasyczny RAG | RAG w Azure: dane, chunking i ewaluacja |
| Pytanie łączy kilka źródeł i wymaga kolejnych kroków wyszukiwania | zaawansowany (agentic) RAG | Agentic RAG: wiele źródeł, koszt i kontrola |
| Pytanie dotyczy całego zbioru: tematy, przyczyny, trendy | GraphRAG | GraphRAG: kiedy graf wiedzy pomaga RAG |
| Odpowiedź wymaga przejścia po relacjach: klient → zamówienie → decyzja, a firma ma opisany cyfrowy model firmy (ontologię) | OG-RAG | OG-RAG: ontologia jako mapa dla wyszukiwania wiedzy |
| Zespół chce zbudować RAG na otwartym oprogramowaniu i mieć kontrolę nad stosem | otwarta platforma OpenRAG | OpenRAG: otwarta platforma do budowy RAG |
| Firma pracuje w Microsoft Azure i chce usługi zarządzanej | Azure AI Search jako usługa | Azure AI Search: klasyczny i agentowy RAG |
| Wiedza jest dostępna, ale model myli format, ton albo kategorie | fine-tuning | Fine-tuning modelu: kiedy warto |
| RAG działa i jest zmierzony, a model gubi się w podobnych dokumentach | RAFT | RAFT: trening modelu dla domenowego RAG |
Kilka uwag do tabeli. Warianty się nie wykluczają: GraphRAG może korzystać z cyfrowego modelu firmy, a OpenRAG albo Azure AI Search mogą być miejscem, w którym działa każda z metod. Platforma to miejsce budowy, metoda to sposób wyszukiwania — warto tego nie mylić przy porównywaniu ofert. Według badaczy Microsoft Research GraphRAG powstał właśnie dla pytań o cały zbiór dokumentów, z którymi klasyczny RAG sobie nie radzi.
Zasada autora: zaczynajcie od najprostszego wariantu, który odpowiada na Wasze pytania. Agent, który na pytanie o godziny otwarcia magazynu planuje pięć kroków wyszukiwania, jest imponujący na demo i drogi na fakturze. Bardziej złożony wariant dodajcie dopiero wtedy, gdy pomiar pokaże, że prostszy nie wystarcza.
Od czego zacząć
Pierwszy projekt RAG w firmie zaczyna się od kartki, nie od narzędzia. Kolejność, którą rekomenduję:
- Pytania. Zbierzcie 20–50 prawdziwych pytań, które pracownicy dziś zadają kolegom albo szukają odpowiedzi w folderach. Przy każdym zapiszcie, gdzie jest odpowiedź i kto zadaje pytanie.
- Dane i właściciele. Dla każdego źródła ustalcie właściciela, obowiązującą wersję i co zrobić ze starymi. Jeśli trzy działy mają trzy wersje tej samej instrukcji, RAG tego nie rozstrzygnie — rozstrzygnie właściciel.
- Uprawnienia. Ustalcie, kto co może zobaczyć, zanim cokolwiek trafi do indeksu. Filtr uprawnień ma działać przy wyszukiwaniu, nie dopiero w odpowiedzi.
- Pytania testowe. Z listy z punktu 1 zróbcie zestaw testowy: pytanie, oczekiwana odpowiedź, dokument źródłowy. Dołóżcie pytania bez odpowiedzi w dokumentach — system ma wtedy powiedzieć „nie wiem”.
- Pilotaż. Jeden proces, jedna grupa użytkowników, kilka tygodni. Porównajcie z obecnym sposobem pracy: czas znalezienia odpowiedzi, liczbę poprawek, liczbę pytań przekazanych ekspertowi.
Przedział 20–50 pytań to rekomendacja autora, nie norma. Mniej pytań nie pokaże wzorca błędów, a więcej utrudni ręczny przegląd przy pierwszym pilotażu.
Jeśli zarząd nie potrafi dziś powiedzieć, kto jest właścicielem kluczowych dokumentów i kto może je czytać, wybór narzędzia jest przedwczesny. Najpierw warto nazwać pytania i źródła — po to jest prezentacja dla zarządu.
Najważniejsze w skrócie
- Model nie zna danych firmy. Trzeba mu je dostarczyć: dokumenty przez RAG, liczby z systemów przez narzędzia.
- RAG dostarcza wiedzę, fine-tuning uczy zachowania. RAFT łączy oba i ma sens dopiero po zmierzonym RAG.
- Jakość RAG zależy od źródeł, wyszukiwania i uprawnień bardziej niż od wyboru modelu.
- Wariant RAG wybiera się według rodzaju pytań: jeden dokument, kilka źródeł, cały zbiór, relacje.
- Platforma (OpenRAG, Azure AI Search) to miejsce budowy, a nie metoda.
- Zaczyna się od pytań, właścicieli i uprawnień, a kończy na narzędziu.
- Dane i analityka
- Modele i LLM
- Agenci AI
- Zarząd