Azure AI Search: klasyczny i agentowy RAG
Temat: Microsoft AI
Azure AI Search to usługa Microsoftu, która wyszukuje fragmenty Twoich dokumentów i podaje je modelowi AI jako podstawę odpowiedzi, czyli realizuje wzorzec RAG (retrieval-augmented generation). Ma dwa tryby. W klasycznym Twoja aplikacja wysyła jedno zapytanie do indeksu i sama woła model. W trybie agentic retrieval baza wiedzy planuje kilka zapytań, wykonuje je i scala wyniki ze wskazaniem źródeł. Stan na 5.10.2026: klasyczne wyszukiwanie jest ogólnie dostępne (GA), a agentic retrieval jest GA w części funkcji, z resztą w preview (Microsoft Learn).
Usługa nie zamienia dokumentów w wiarygodne odpowiedzi sama. Jakość zależy od treści, podziału na fragmenty, indeksu, rankingu i testów, dlatego wyszukiwanie mierz oddzielnie od odpowiedzi. Środowisko chmury, w którym działa usługa, opisuje poradnik o Microsoft Azure dla firm. Szerszy obraz platformy, w której to wszystko się spotyka, daje poradnik Microsoft Foundry dla firm, a to, kiedy RAG jest właściwym wyborem dla danych firmy, opisuje poradnik o wykorzystaniu danych firmy w AI.
Gdzie Azure AI Search jest w Microsoft Foundry
Nazwa się nie zmieniła: to nadal Azure AI Search. Microsoft wymienia tę usługę na liście Foundry Tools (dawniej Azure AI services), obok Speech, Language czy Document Intelligence (lista Foundry Tools). Azure AI Search jest też fundamentem Foundry IQ, czyli zarządzanej warstwy wiedzy dla agentów, która korzysta z agentic retrieval.
W portalu Microsoft Foundry (nowa wersja) wchodzisz do projektu, wybierasz Build, a potem zakładkę Knowledge. Tam tworzysz albo podłączasz usługę wyszukiwania i budujesz bazę wiedzy (knowledge base) z jednego lub kilku źródeł (knowledge sources). Na zakładce Agents łączysz bazę z agentem (Foundry IQ w Microsoft Learn). Status jest taki jak w agentic retrieval: część funkcji GA, część preview, a portal daje dostęp tylko do wersji preview. Jak zaprojektować samą bazę wiedzy, opisuję we wpisie o Foundry IQ jako bazie wiedzy dla agentów.
Klasyczny i agentowy retrieval
Klasyczny RAG wykonuje sekwencję zaprojektowaną przez zespół: jedno zapytanie do jednego indeksu, wyniki, kontekst i wywołanie modelu przez Twoją aplikację. Agentic retrieval wywołuje bazę wiedzy. Ta może rozłożyć pytanie na podzapytania, wykonać je równolegle w kilku źródłach, każde przeliczyć semantic rankerem i zwrócić scalony wynik z odwołaniami do źródeł oraz dziennikiem tego, co przeszukała (agentic retrieval). Microsoft zaleca agentic retrieval dla nowych wdrożeń RAG, a klasyczny RAG wtedy, gdy potrzebujesz wyłącznie funkcji GA, prostoty i szybkości albo chcesz zachować własną orkiestrację (RAG w Azure AI Search).
| Kryterium | Klasyczny RAG | Agentic retrieval |
|---|---|---|
| przepływ | stały i przewidywalny | planowanie wielu zapytań |
| cel zapytania | jeden indeks | baza wiedzy z jednym lub kilkoma źródłami |
| rozliczenie | semantic ranker za zapytanie | tokeny w Azure AI Search plus tokeny modelu w Azure OpenAI |
| pytania | pojedyncza domena i indeks | złożone, konwersacyjne, wieloźródłowe |
| kontrola | własna orkiestracja | większa część pipeline zarządzana |
| status (5.10.2026) | GA | GA w części, reszta w preview |
| regiony | regiony usługi | wybrane regiony |
Status sprawdzaj dla wersji API, nie dla nazwy funkcji. Do produkcji Microsoft wskazuje REST API 2026-04-01 z typami źródeł GA i trybem minimal, czyli bez planowania przez model. Planowanie zapytań przez model, synteza odpowiedzi, wyższy poziom wysiłku i rozmowy wieloturowe są w 2026-08-01-preview. Portal Azure i portal Foundry dają dostęp do agentic retrieval tylko w wersji preview, więc obiekty utworzone w portalu mogą wymagać migracji przed produkcją (agentic retrieval, dostępność funkcji). Stan na 5.10.2026.
Tryby wyszukiwania
Oba tryby obsługują te same rodzaje zapytań: słowa kluczowe, wektory, hybrydę i zapytania multimodalne (tekst z obrazami). Różnią się tym, kto planuje zapytanie.
| Tryb | Jak działa | Kiedy pomaga |
|---|---|---|
| słowa kluczowe (full-text) | indeks odwrócony i ranking BM25 | kody produktów, nazwy, daty, żargon |
| wektorowy | podobieństwo embeddingów (HNSW albo exhaustive KNN) | parafrazy i pytania innymi słowami niż w dokumencie |
| hybrydowy | oba zapytania równolegle, wyniki łączy Reciprocal Rank Fusion (RRF) | punkt startu dla RAG |
| semantic ranker | ponowny ranking 50 najlepszych wyników modelami językowymi Microsoftu | lepsza kolejność, gdy treść to opisowa proza |
Microsoft zaleca w RAG zapytania hybrydowe i semantic ranking, który w agentic retrieval jest wbudowany, a w klasycznym RAG opcjonalny (wyszukiwanie hybrydowe). Ważne ograniczenie: semantic ranker nie przeszukuje całego korpusu. Przelicza tylko pierwsze 50 wyników z BM25 albo RRF, a podpisy i odpowiedzi zwraca jako dosłowny tekst z indeksu (semantic ranker). Jeśli właściwego fragmentu nie ma w tej pięćdziesiątce, ranker go nie znajdzie.
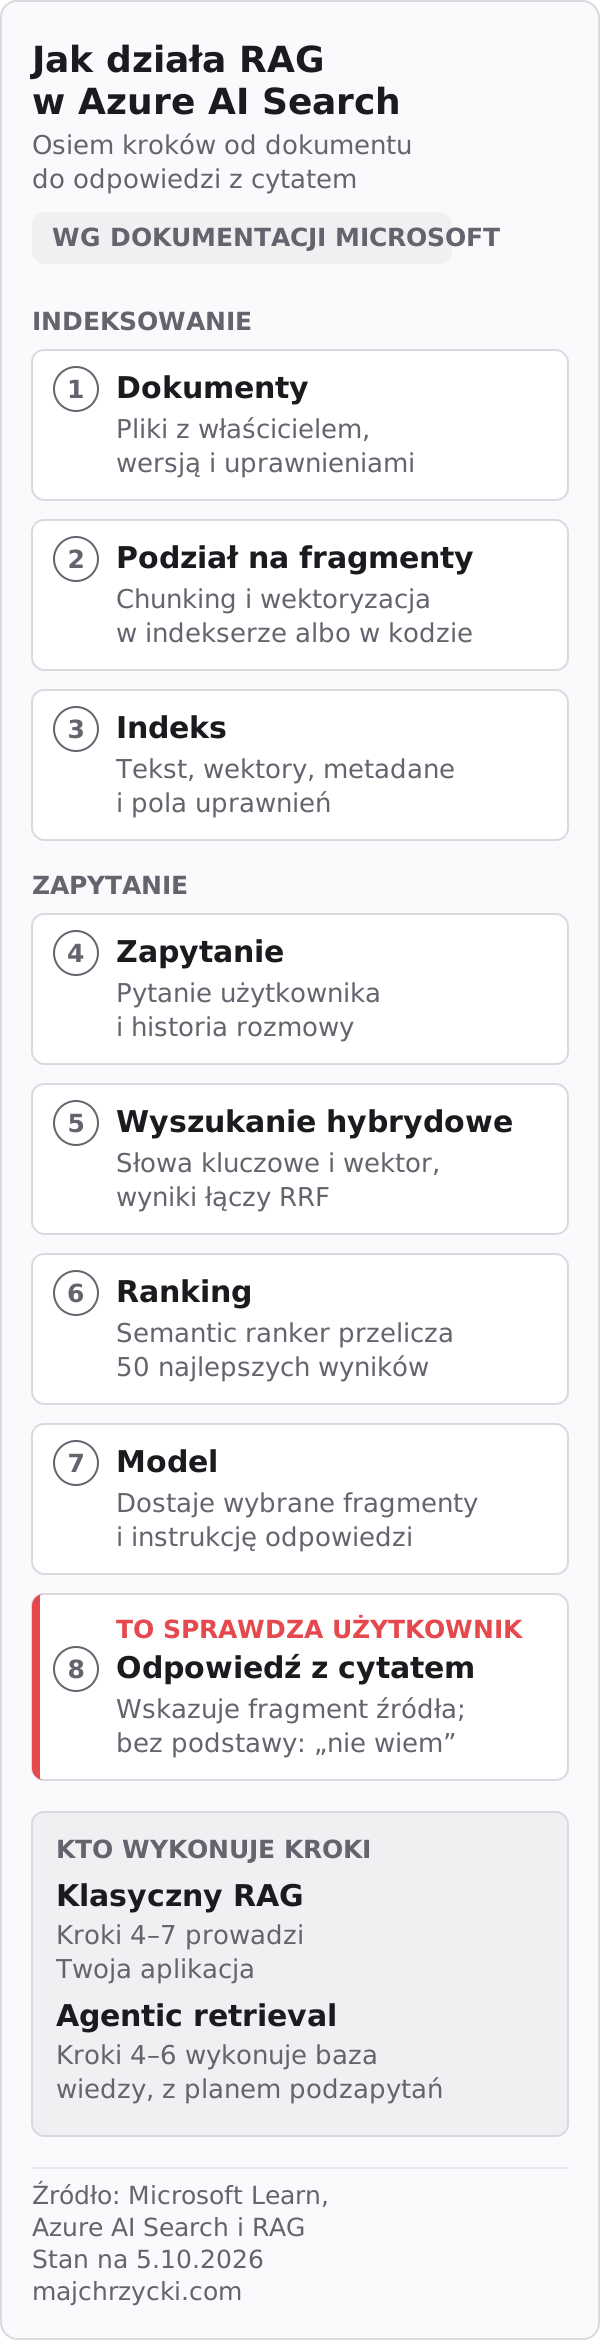
Jak działa RAG krok po kroku
- Dokumenty. Źródła z właścicielem, wersją i uprawnieniami, na przykład Azure Blob Storage, SharePoint albo OneLake.
- Podział na fragmenty. Chunking i wektoryzacja w indekserze (wbudowane skills) albo w Twoim kodzie.
- Indeks. Tekst, wektory, metadane i pola uprawnień.
- Zapytanie. Pytanie użytkownika, a w rozmowie także jej historia.
- Wyszukanie hybrydowe. Słowa kluczowe i wektor jednocześnie, wyniki łączy RRF.
- Ranking. Semantic ranker przelicza 50 najlepszych wyników.
- Model. Dostaje wybrane fragmenty i instrukcję odpowiedzi.
- Odpowiedź z cytatem. Wskazuje fragment źródła, żeby użytkownik mógł go sprawdzić, a bez podstawy w dokumentach mówi, że nie zna odpowiedzi.
W klasycznym RAG kroki 4–7 prowadzi Twoja aplikacja. W agentic retrieval kroki 4–6 wykonuje baza wiedzy i może przy tym zaplanować kilka podzapytań. Kroki 1–7 opisuje przegląd RAG w Azure AI Search, a zasadę odmowy przy braku odpowiedzi Azure Architecture Center.
Gdzie RAG się psuje
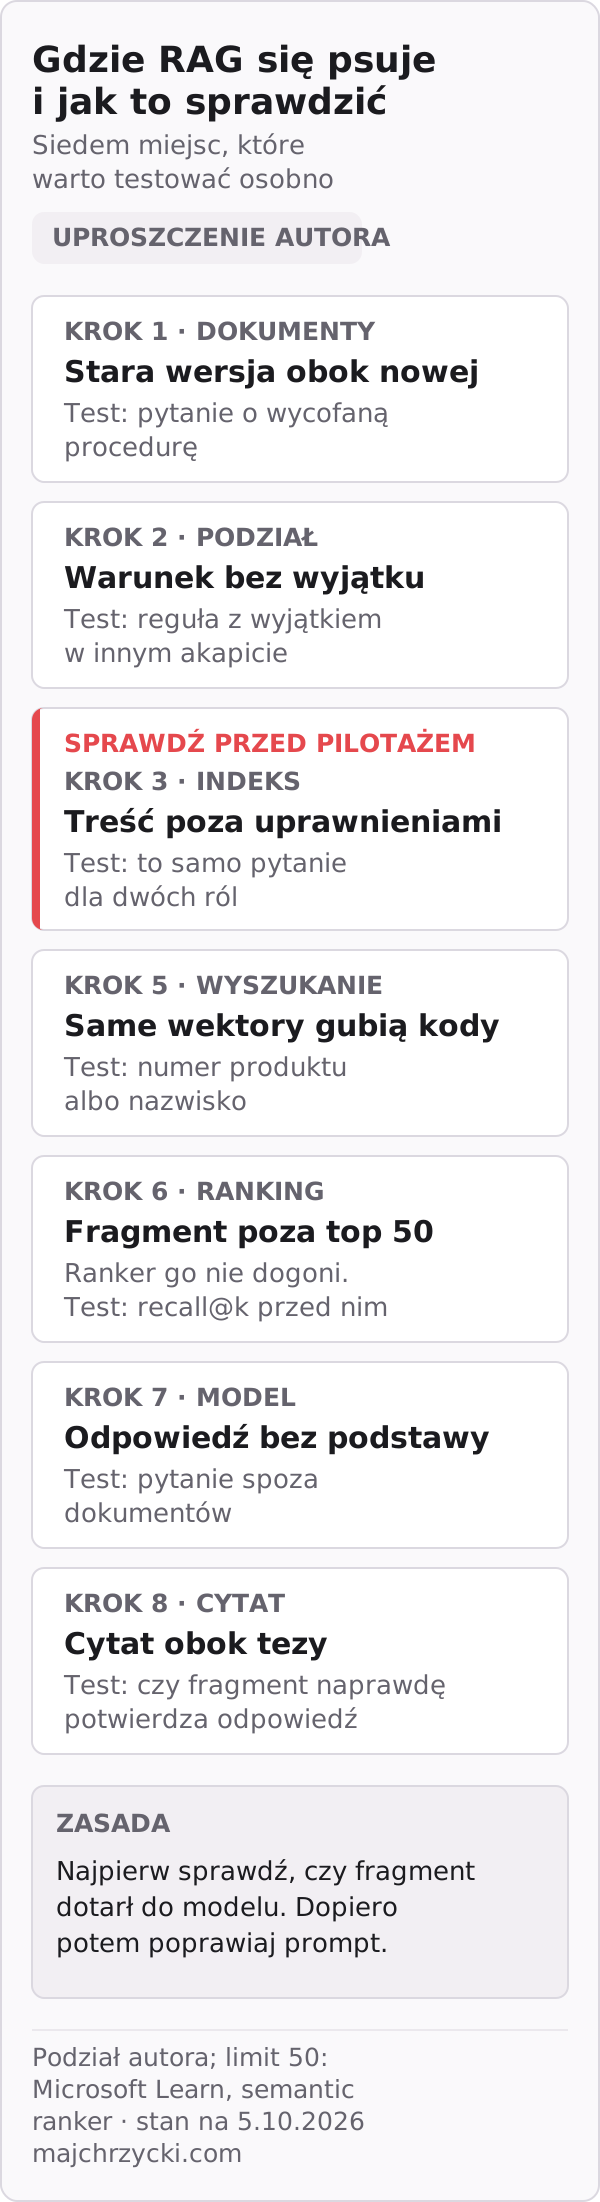
Prawie każdy krok ma swój typowy błąd i swój test. To mój podział, uproszczenie do pracy z zespołem, a nie lista Microsoftu. Numery kroków są te same co na schemacie wyżej; krok 4 (samo zapytanie) pomijam:
- Krok 1, dokumenty: stara wersja procedury leży obok nowej. Test: pytanie o wycofaną procedurę.
- Krok 2, podział: warunek trafia do innego fragmentu niż wyjątek. Test: reguła, której wyjątek jest w innym akapicie.
- Krok 3, indeks: treść wychodzi poza uprawnienia. Test: to samo pytanie dla dwóch ról.
- Krok 5, wyszukanie: same wektory gubią kody i nazwy. Test: numer produktu albo nazwisko.
- Krok 6, ranking: właściwego fragmentu nie ma w pierwszej pięćdziesiątce, więc ranker go nie dogoni. Test: recall@k przed rankingiem.
- Krok 7, model: odpowiada bez podstawy w dokumentach. Test: pytanie spoza dokumentów.
- Krok 8, cytat: cytowany fragment stoi obok tezy, ale jej nie wspiera. Test: czy fragment naprawdę potwierdza odpowiedź.
Krok 3 sprawdź jeszcze przed pilotażem z użytkownikami, bo cytat nie cofnie wycieku. Zasada wynika z kolejności kroków: najpierw sprawdź, czy właściwy fragment dotarł do modelu, a dopiero potem poprawiaj prompt.
Indeks i trafność
Przygotuj dokumenty, chunking, metadane i uprawnienia. Żadna kombinacja trybów wyszukiwania nie jest uniwersalna. Testuj na własnych pytaniach oraz treści.
Mierz, czy właściwy fragment znalazł się w pierwszych wynikach. Dopiero później oceniaj odpowiedź. Cytowanie powinno wskazywać fragment rzeczywiście wspierający tezę, nie dokument o podobnym temacie. Pytanie bez odpowiedzi w korpusie powinno kończyć się odmową albo eskalacją.
Modele cenowe, warstwy i regiony
Stan na 5.10.2026, według wyboru modelu cenowego i warstwy:
- Dedicated. Stała pojemność: płacisz stawkę godzinową za jednostki wyszukiwania (repliki razy partycje) w wybranej warstwie. Warstwy to Free, Basic, Standard (S1, S2, S3), S3 High Density oraz Storage Optimized (L1, L2).
- Free. Jedna usługa na subskrypcję, zasoby współdzielone, bez skalowania. Microsoft może ją usunąć po okresie bezczynności, więc nadaje się do nauki i prób, nie do pilotażu z użytkownikami.
- Serverless (preview). Rozliczenie za zużycie: jednostki obliczeniowe i gigabajty indeksu miesięcznie. Bez SLA i nie do produkcji; rozliczanie warstwy Serverless Developer ruszyło 13 września 2026.
- Semantic ranker. Plan free z miesięcznym limitem zapytań i plan standard, rozliczany za użycie po wyczerpaniu limitu.
- Agentic retrieval. Dwa rachunki: Azure AI Search liczy tokeny wyszukiwania i rankingu (z miesięcznym limitem w planie free), a Azure OpenAI liczy tokeny planowania i syntezy odpowiedzi (rozliczanie agentic retrieval).
Kwot tu nie podaję. Sprawdź je w cenniku Azure AI Search dla swojego regionu, a limity obiektów dla warstwy w tabeli limitów. Dla Poland Central tabela regionów zaznacza agentic retrieval, semantic ranker i query rewrite, także na warstwie Free. Nie zaznacza wbudowanych skills AI enrichment, modelu serverless ani stref dostępności (regiony Azure AI Search). Jeśli planujesz automatyczny chunking i wektoryzację przez wbudowane skills, sprawdź region przed utworzeniem usługi.
Bramka jakości: indeks przed modelem
W Azure AI Search pierwszą bramką jest sam indeks. Zanim podłączysz model, wyślij zapytania testowe bezpośrednio do usługi i obejrzyj surowe wyniki: które fragmenty wróciły, w jakiej kolejności i z jakimi metadanymi. Jeśli właściwego fragmentu nie ma na liście, przyczyna leży w treści, podziale albo konfiguracji wyszukiwania, a nie w modelu.
| Element usługi | Co sprawdzić | Sygnał, że trzeba poprawić |
|---|---|---|
| schemat indeksu | czy są pola tekstu, wektora, metadanych i uprawnień | filtr po dziale albo dacie nie ma na czym działać |
| tryb zapytania | full-text, wektor i hybryda na tych samych pytaniach | hybryda przegrywa z full-textem przy kodach i nazwiskach |
| semantic ranker | kolejność przed i po rerankingu, wynik @search.rerankerScore w skali 0–4 | właściwy fragment nie mieści się w 50 wynikach wejściowych |
| agentic retrieval | dziennik aktywności i odwołania do źródeł w odpowiedzi | podzapytanie trafia do niewłaściwego źródła wiedzy |
| wersja API | czy obiekt powstał na 2026-04-01, czy na schemacie preview | konfiguracja z portalu wymaga migracji przed produkcją |
Kolejność porównań ma znaczenie. Zacznij od klasycznego zapytania hybrydowego, potem dołącz semantic ranker, a agentic retrieval sprawdzaj dopiero na pytaniach, które naprawdę potrzebują kilku źródeł. W agentic retrieval włącz w odpowiedzi odwołania do źródeł i dziennik aktywności. Oba są opcjonalne, a bez nich nie zobaczysz, jakie podzapytania wykonała baza wiedzy (agentic retrieval).
Trafność wyszukiwania da się zmierzyć liczbowo, jeśli dla pytań testowych masz ręczne etykiety trafności dokumentów. W Microsoft Foundry służy do tego ewaluator Document Retrieval: porównuje zwrócone dokumenty z etykietami i liczy między innymi NDCG i Fidelity. Microsoft opisuje go jako narzędzie do strojenia parametrów wyszukiwania, czyli algorytmu, top_k i rozmiaru fragmentów (ewaluatory RAG w Microsoft Foundry). Każdą zmianę schematu, podziału albo trybu zapytania sprawdzaj na tym samym, zamrożonym zestawie zapytań.
Uprawnienia na poziomie dokumentów
Azure AI Search nie zgaduje, kto co może zobaczyć. Uprawnienia trzeba zapisać w indeksie albo odziedziczyć ze źródła, a usługa stosuje je przy zapytaniu. Dostępne mechanizmy zależą od trybu (bezpieczeństwo w RAG):
| Mechanizm | Tryb | Test przed pilotażem |
|---|---|---|
| przycinanie wyników na poziomie dokumentu (security trimming) i filtry przy zapytaniu | klasyczny i agentic | jedno pytanie zadane przez dwie role |
| kontrola dostępu na poziomie źródła wiedzy | agentic retrieval | agent bez prawa do źródła nie dostaje z niego fragmentów |
| dziedziczenie uprawnień zdalnego SharePointa | agentic retrieval | odebranie dostępu w SharePoint i ponowne pytanie |
| metadane uprawnień Entra dla treści z Azure Storage | oba | przeniesienie użytkownika do innej grupy i ponowne pytanie |
| private endpoints | oba | ruch do usługi wyłącznie z sieci firmowej |
W Foundry IQ zapytanie do bazy wiedzy uwzględnia listy kontroli dostępu, etykiety Microsoft Purview i tożsamość Entra osoby wywołującej (Foundry IQ).
Najczęstsza luka leży między źródłem a indeksem. Gdy uprawnienia są skopiowane do pola w indeksie, zmiana roli w źródle zadziała dopiero po aktualizacji tego pola. Zdalne źródło SharePoint jest odpytywane na żywo i dziedziczy uprawnienia przy zapytaniu. Dlatego w pilotażu odbierz komuś dostęp do dokumentu i sprawdź, po jakim czasie przestaje go widzieć w wynikach wyszukiwania.
Koszt i eksploatacja usługi
Rachunek za Azure AI Search składa się z kilku liczników, a każdy reaguje na inną decyzję projektową:
- Pojemność. W modelu Dedicated płacisz stawkę godzinową za jednostki wyszukiwania przez cały czas działania usługi, także w nocy, gdy nikt nie pyta. Każda dodatkowa replika albo partycja mnoży liczbę jednostek.
- Ranking. W klasycznym RAG semantic ranker jest rozliczany za zapytanie, więc testy obciążeniowe i ponowienia też trafiają na rachunek.
- Agentic retrieval. Tokeny liczy Azure AI Search, a osobno Azure OpenAI za planowanie i syntezę odpowiedzi. Poziom wysiłku minimal pomija planowanie przez model; domyślny poziom to low.
- Indeksowanie. Pełne ponowne indeksowanie powtarza chunking i wektoryzację, więc zmiana rozmiaru fragmentów ma swój koszt także wtedy, gdy liczba zapytań się nie zmienia.
W agentic retrieval Microsoft radzi obniżyć poziom wysiłku, żeby ograniczyć pracę modelu przy planowaniu (koszty agentic retrieval). Agent, który do pytania o godziny pracy biura planuje kilka podzapytań, nie wykazuje inteligencji, tylko entuzjazm na koszt tokenów.
W eksploatacji mierz opóźnienie i liczbę zapytań osobno dla klasycznego wyszukiwania i dla agentic retrieval, bo mają inne liczniki. Dziennik aktywności pokazuje, jakie podzapytania wykonała baza wiedzy, więc pomaga przypisać koszt do konkretnego typu pytania. Zawiera jednak treść zapytań, dlatego ustal, kto ma do niego dostęp i jak długo go przechowujesz.
Pilotaż na jednym indeksie
Pilotaż usługi zamknij w jednym indeksie i jednej domenie, na przykład w procedurach działu obsługi klienta. Do pilotażu z użytkownikami wybierz warstwę Basic albo Standard. Warstwa Free może zostać usunięta po okresie bezczynności, a Serverless jest w preview bez SLA. Przed utworzeniem usługi sprawdź w tabeli regionów, czy wybrany region ma funkcje, których potrzebujesz.
- Zbuduj indeks z polami uprawnień i metadanych, zasilony z jednego źródła.
- Uruchom wariant bazowy: klasyczne zapytanie hybrydowe z semantic rankerem.
- Jeśli pytania wymagają kilku źródeł, puść ten sam zestaw przez agentic retrieval na API
2026-04-01. - Porównaj trafność wyników, opóźnienie i liczniki kosztu obu wariantów.
- Wybierz: zostajesz przy klasycznym trybie, przechodzisz na agentic retrieval albo najpierw poprawiasz treść indeksu.
Obiekty wyklikane w portalu traktuj jak szkic. Portal tworzy agentic retrieval w wersji preview, więc konfigurację, która ma trafić do produkcji, zapisz w kodzie na wersji GA interfejsu API. Usługa dobrze znajduje fragmenty, ale nie sprawdza, czy model poprawnie z nich skorzystał. To zadanie testów odpowiedzi.
Jak przygotować pytania testowe, ocenić odpowiedzi i ryzyka metody niezależnie od narzędzia, opisuję we wpisie RAG w Azure: dane, chunking i ewaluacja. Na start wystarczy dwadzieścia pytań z działu, który bierze udział w pilotażu, i jedno popołudnie przy surowych wynikach z indeksu.
Źródło techniczne: dokumentacja pierwotna.
- Dane i analityka
- Modele i LLM
- Azure
- Zarządzanie zmianą
