OWASP LLM Top 10 2026: dziesięć ryzyk aplikacji z AI
Temat: Bezpieczeństwo i utrzymanie AI
OWASP opublikował w sierpniu 2026 r. wydanie „OWASP Top 10 for LLM Applications 2026”, w skrócie LLM Top 10 2026. Zastępuje ono listę z 2025 r., którą wciąż cytuje wiele materiałów szkoleniowych. Oficjalne repozytorium źródłowe zawiera nazwy, kolejność i szczegółowe opisy; strona wydania na genai.owasp.org wyjaśnia jego zakres. Lista pomaga ustawić priorytety testów, ale nie zastępuje modelowania zagrożeń własnego systemu. Stan na 6.10.2026. Dlaczego agent potrzebuje własnego konta i kontroli w systemie docelowym, opisuje poradnik o uprawnieniach agentów AI.
Dziesięć kategorii 2026 i pytanie kontrolne
| Kod 2026 | Ryzyko OWASP | Kod 2025 | Co sprawdzić w praktyce? |
|---|---|---|---|
| LLM01 | Prompt Injection | LLM01 | Czy tekst z dokumentu, strony, obrazu lub nagrania może zmienić instrukcję agenta? |
| LLM02 | Sensitive Information Disclosure | LLM02 | Czy odpowiedź ujawnia dane lub sekrety poza uprawnieniami pytającego? |
| LLM03 | Excessive Agency | LLM06 | Czy agent może wykonać więcej działań, niż wymaga zadanie i rola użytkownika? |
| LLM04 | Supply Chain | LLM03 | Czy model, biblioteka, narzędzie lub źródło danych ma sprawdzone pochodzenie? |
| LLM05 | Data and Model Poisoning | LLM04 | Czy złośliwy materiał może zatruć indeks, zbiór treningowy lub model? |
| LLM06 | Unbounded Consumption | LLM10 | Czy limity czasu, tokenów, kosztu i wywołań blokują niekontrolowane zużycie? |
| LLM07 | Misinformation | LLM09 | Czy system rozpoznaje brak dowodu i unika odpowiedzi przedstawionej jako fakt? |
| LLM08 | Hidden Context Exposure | — (zastępuje LLM07 System Prompt Leakage) | Czy prompt systemowy, pobrane polityki lub schematy narzędzi mogą wypłynąć do odbiorcy? |
| LLM09 | Vector and Embedding Weaknesses | LLM08 | Czy indeks wektorowy respektuje granice danych i nie zwraca mylących trafień? |
| LLM10 | Improper Output Handling | LLM05 | Czy wynik modelu, także wygenerowany kod, jest traktowany jako nieufne dane przed użyciem? |
Nazwy i numeracja pochodzą z kanonicznej listy OWASP 2026. Kolumna „Kod 2025” zestawia kategorie o tej samej nazwie z folderu wydania 2025. Pytania w prawej kolumnie są praktyczną interpretacją dla zespołu, a nie cytatem z publikacji.
Uwaga na stare kody. Strona listy na genai.owasp.org w dniu sprawdzenia (6.10.2026) nadal pokazywała wydanie 2025. „LLM06” oznacza tam Excessive Agency, a w wydaniu 2026 to Unbounded Consumption. Do dokumentacji audytowej zapisuj pełny kod z rokiem, na przykład LLM03:2026.
Co zmieniło się względem 2025 r.?
Przedmowa do wydania 2026 opisuje zmiany wprost:
- Excessive Agency awansowała na trzecie miejsce. OWASP wiąże to z rosnącą liczbą wdrożeń, w których model wykonuje działania.
- Unbounded Consumption przesunęła się o cztery pozycje w górę, a Improper Output Handling spadła z piątej na dziesiątą. Ta druga obejmuje teraz także niebezpieczny kod generowany przez asystentów.
- System Prompt Leakage zastąpiono szerszą kategorią Hidden Context Exposure. Opis LLM08:2026 obejmuje prompty systemowe, instrukcje dewelopera, pobrane polityki, schematy narzędzi i wbudowane reguły.
- Prompt Injection obejmuje ataki ukryte w obrazach i dźwięku, nie tylko w tekście.
Przedmowa zaznacza też granicę listy: dotyczy modelu jako komponentu aplikacji. Ryzyka samych agentów, takie jak przejęcie celu agenta czy nadużycie tożsamości, opisuje osobna lista OWASP Top 10 for Agentic Applications z grudnia 2025 r. (kody ASI01–ASI10). Przy agencie z narzędziami warto czytać obie.
Gdzie na ścieżce agenta działa każde ryzyko?
Najłatwiej przypisać kontrolę, gdy wiadomo, w którym miejscu ścieżki ryzyko powstaje. OWASP nie dzieli listy na etapy — poniższy podział jest moim uproszczeniem dla zespołu, który projektuje testy:
- Wejście — dokumenty, strony, wyniki narzędzi, indeks: LLM01 Prompt Injection, LLM05 Data and Model Poisoning, LLM09 Vector and Embedding Weaknesses.
- Model — co model zna i ma w kontekście: LLM04 Supply Chain, LLM07 Misinformation, LLM08 Hidden Context Exposure.
- Narzędzie — działanie ze skutkiem w systemie: LLM03 Excessive Agency, LLM06 Unbounded Consumption.
- Wynik — co trafia do odbiorcy albo do dalszego kodu: LLM02 Sensitive Information Disclosure, LLM10 Improper Output Handling.
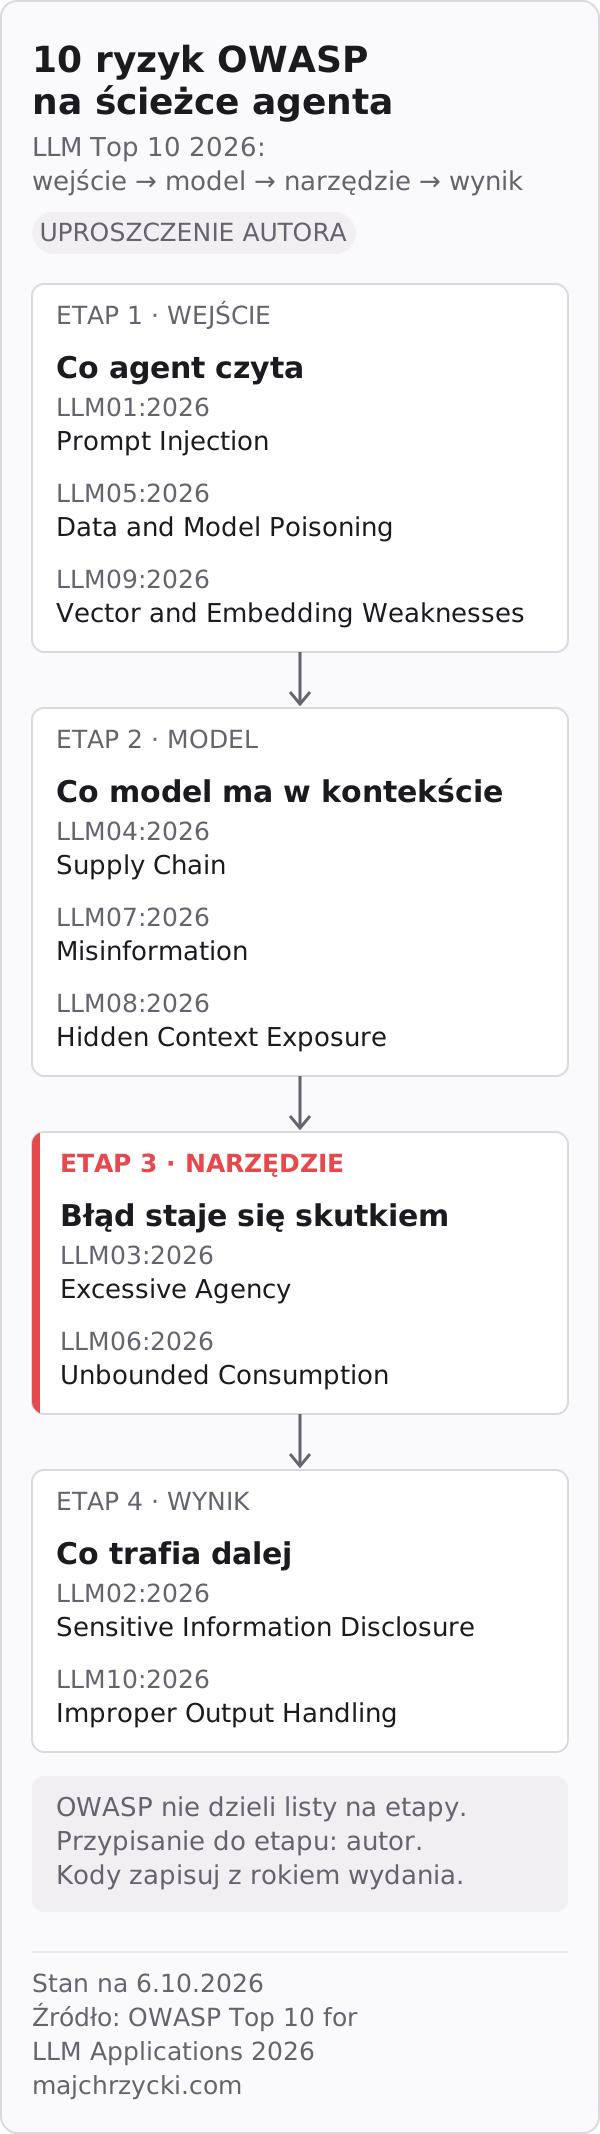
Jedno ryzyko może dotknąć kilku etapów. Wstrzyknięcie wchodzi przez dokument, ale szkodę robi dopiero w narzędziu. Podział służy do tego, by każda kontrola miała właściciela, a nie do zamykania dyskusji.
Co zmieniają agenci?
W klasycznym czacie błędna odpowiedź może wprowadzić człowieka w błąd. Agent z dostępem do poczty, CRM lub terminala może dodatkowo wykonać skutek. Dlatego LLM01 i LLM03 trzeba testować razem: wstrzyknięty tekst w dokumencie może nakłonić agenta do działania, na które użytkownik nie wyraził zgody. Model nie powinien być jedyną warstwą autoryzacji. Serwer narzędzia ma sprawdzić tożsamość, zakres zasobu i politykę dostępu, a operacje nieodwracalne powinny wymagać odpowiedniej zgody.
LLM09 dotyczy również RAG. Uprawnienia należy filtrować na etapie pobierania fragmentów, a nie dopiero usuwać poufne zdania z gotowej odpowiedzi. W GraphRAG trzeba też chronić relacje i metadane, które same mogą ujawnić istnienie poufnego projektu.
Jak zamienić listę na odbiór systemu?
Dla każdej kategorii zapisz zasób, przykładowy atak, kontrolę i test regresyjny. Na pilocie wystarczy kilka dobrze dobranych przypadków: nieufny PDF próbujący przejąć instrukcję; użytkownik bez prawa do dokumentu; agent chcący wysłać wiadomość; zapętlenie kosztownych wywołań; niebezpieczny wynik wstrzyknięty do HTML. Powtarzaj je po zmianie modelu, promptu, narzędzia i indeksu. Szerszą rolę projektu opisuje OWASP w AI SDLC.
Nie wszystkie pozycje listy naprawia się promptem. LLM02 i LLM08 wymagają ograniczenia danych, które w ogóle trafiają do kontekstu, oraz kontroli odpowiedzi. LLM06 wymaga limitów budżetu i liczby wywołań w kodzie hosta. LLM10 dotyczy dalszego użycia wyniku: tekst modelu nie powinien stawać się bez walidacji poleceniem terminala, zapytaniem SQL ani kodem HTML. Zespół powinien więc przypisać każdej kontroli właściciela w aplikacji, a nie przerzucać całego bezpieczeństwa na vendora modelu. Model zapytany, czy jego wynik jest bezpieczny, może to chętnie potwierdzić. To wciąż nie jest walidacja.
Testy warto prowadzić na kilku rolach i kilku rodzajach źródeł: dokument zaufany, dokument użytkownika, strona zewnętrzna i wynik narzędzia. Te same słowa ataku mogą zachować się inaczej zależnie od miejsca wejścia. Dobrze zaprojektowany zestaw regresyjny przechowuje oczekiwaną decyzję systemu, widoczną odpowiedź i informację, czy jakakolwiek akcja została rzeczywiście wykonana.
- Agenci AI
- AI SDLC
