NVIDIA NIM: inferencja modeli AI we własnej infrastrukturze
Temat: NVIDIA AI
NVIDIA NIM to rodzina kontenerowych mikroserwisów, które wystawiają modele AI przez API na infrastrukturze z kartami NVIDIA. Zespół dostaje przygotowany runtime, profile modeli i interfejs inferencji zamiast samodzielnie składać wszystkie zależności. NVIDIA opisuje NIM jako gotowe mikroserwisy inferencji do uruchamiania w chmurze, centrum danych, na stacji roboczej i na brzegu sieci. To warstwa serwowania modelu, a nie sam model ani kompletna platforma agentowa. Stan na 5.10.2026.
NIM ma sens tam, gdzie firma chce utrzymywać model blisko własnych danych i potrzebuje powtarzalnego wdrożenia. W stosie NVIDIA AI stoi między wybranym modelem a aplikacją, która go wywołuje. Własny kontener nie gwarantuje jednak automatycznie suwerenności: liczą się też źródło obrazu, pobieranie wag, telemetria, tożsamość i polityka sieciowa.
Miejsce NIM w całym stosie NVIDIA — od sprzętu po bezpieczeństwo agentów — pokazuje poradnik NVIDIA AI dla firm.
Co NIM robi, a czego nie robi?
NIM dla modeli językowych i wizyjnych jest zbudowany na vLLM. Według opisu architektury kontener uruchamia dwa procesy: silnik vLLM, który ładuje model i liczy na GPU, oraz cienkie proxy. Proxy wystawia API zgodne z OpenAI (/v1/chat/completions, /v1/completions, /v1/embeddings), osobne sondy /v1/health/live i /v1/health/ready oraz metryki. Pozostałe ścieżki zwracają 404.
Przy starcie NIM wykrywa kartę, wybiera pasujący profil modelu i pobiera wagi — z katalogu NGC albo Hugging Face — do lokalnej pamięci podręcznej (albo bierze je z niej). Gotowość zgłasza dopiero po załadowaniu modelu. Profil określa silnik (vLLM, SGLang lub TensorRT-LLM — zgodny z silnikiem w uruchamianym obrazie), precyzję, liczbę GPU i obsługę LoRA. Polecenie list-model-profiles pokazuje, które profile zmieszczą się w pamięci danej karty.
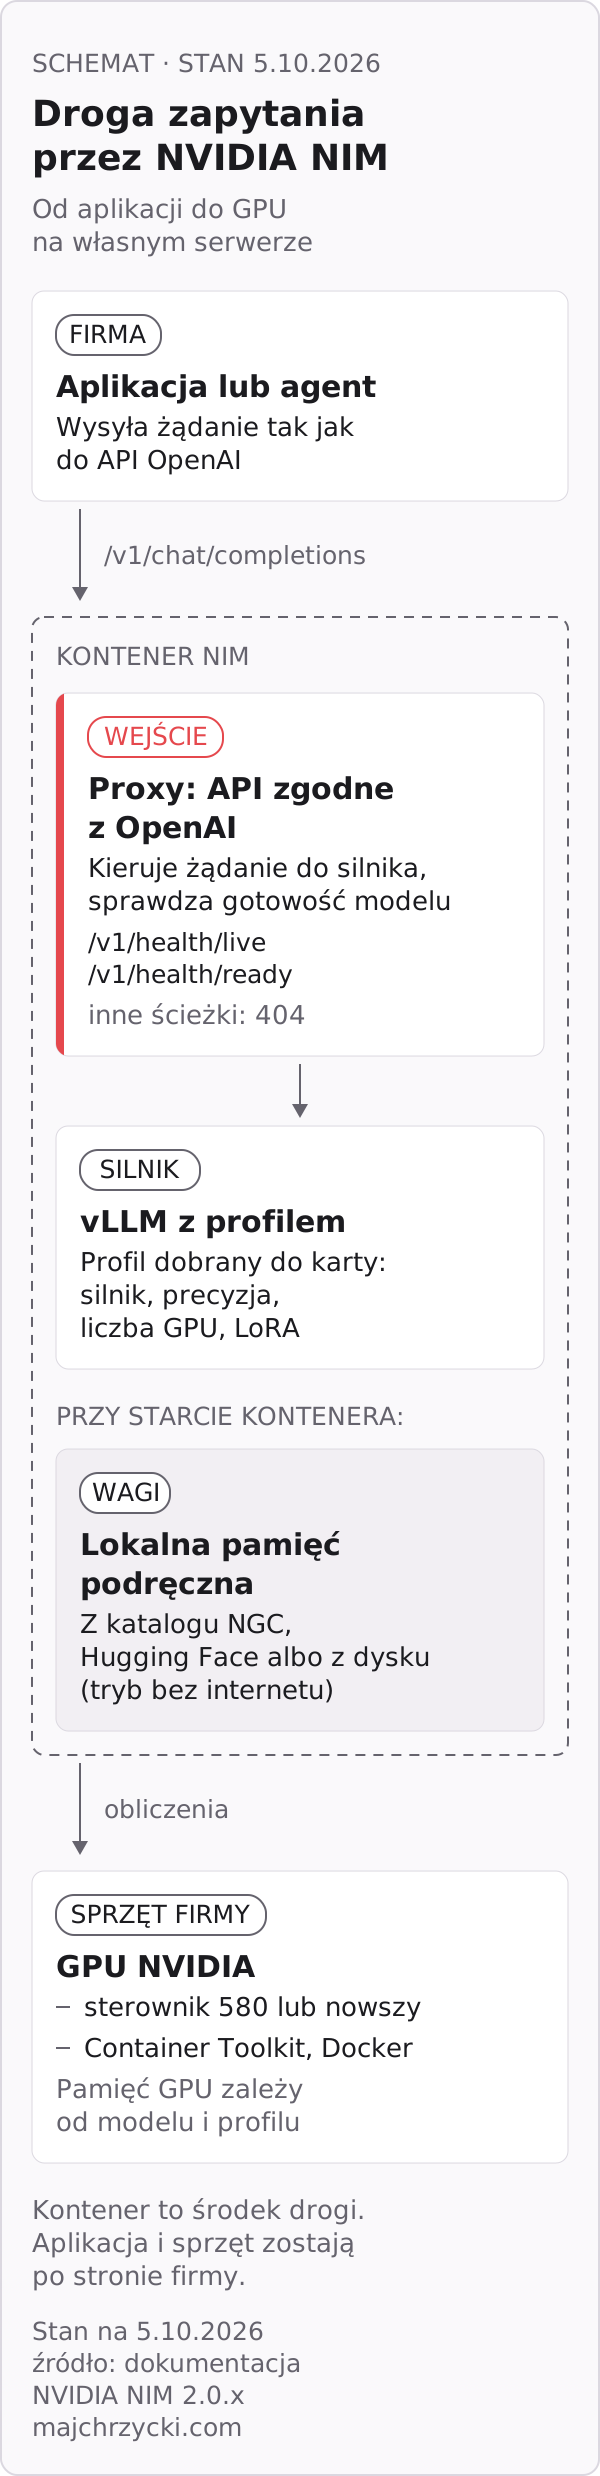
NIM nie przygotuje firmowych danych, nie zweryfikuje odpowiedzi modelu i nie rozstrzygnie, do których narzędzi agent ma dostęp. Jeśli agent pyta o zamówienie w ERP, NIM realizuje wywołanie modelu; logika uprawnień i sprawdzenie aktualnego stanu zamówienia pozostają poza nim.
Licencja: dostęp deweloperski i NVIDIA AI Enterprise
Do pobrania i uruchomienia kontenera wystarcza członkostwo w NVIDIA Developer Program albo licencja NVIDIA AI Enterprise; jest też 90-dniowa licencja ewaluacyjna AI Enterprise. Strona produktu łączy dostęp deweloperski z rozwojem i testami, a użycie produkcyjne — z licencją AI Enterprise.
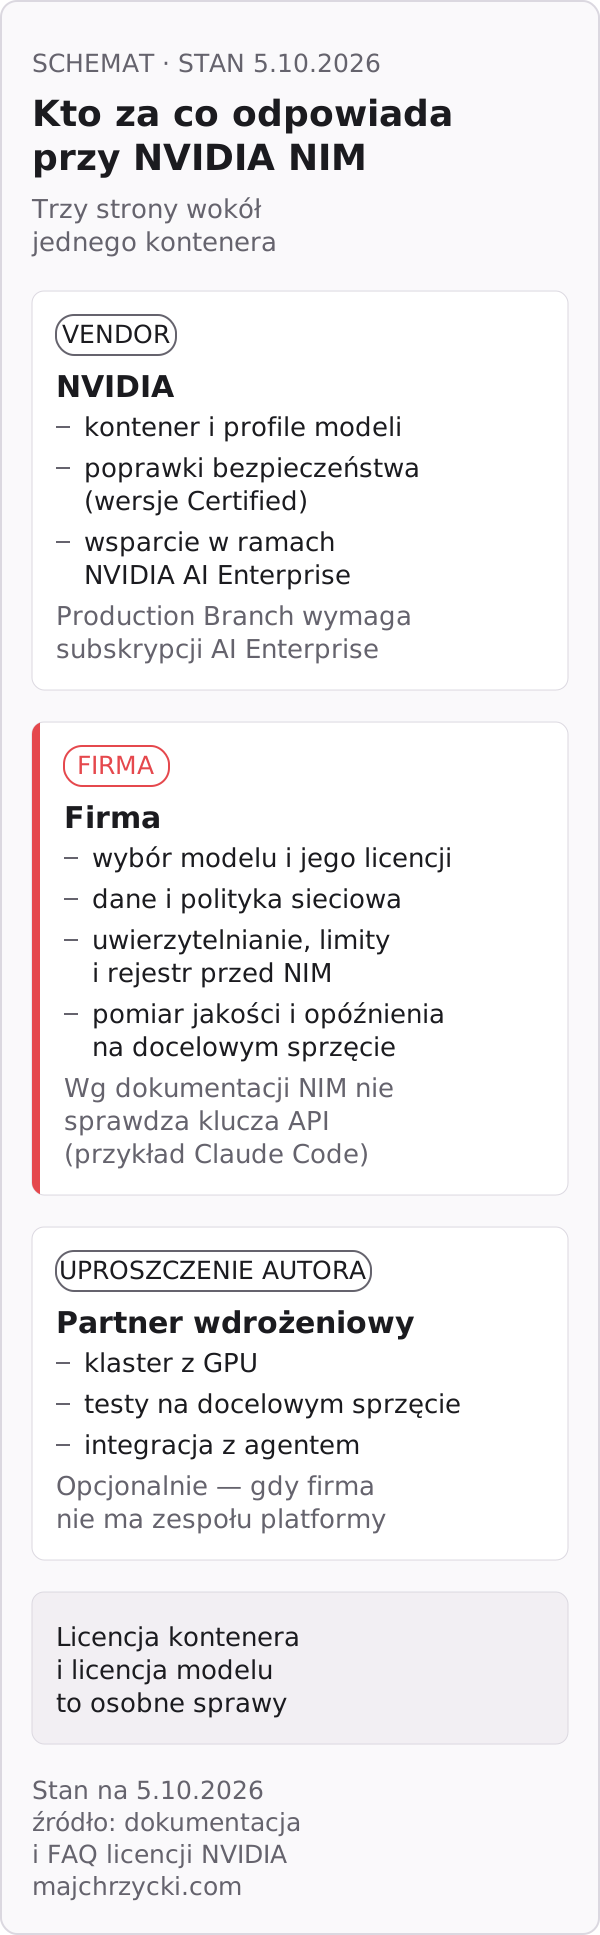
Dokumentacja rozróżnia trzy warianty: NIM, NIM Certified Feature Branch i NIM Certified Production Branch. Zwykły NIM jest walidowany na niewielkim zestawie kart i publikowany w ciągu ok. 72 godzin od udostępnienia modelu. NVIDIA pisze, że jest „available at no charge under the applicable license terms”, ale nie obejmuje go wsparcie NVIDIA Enterprise. Wersje Certified mają szerszą zgodność ze sprzętem i udokumentowany cykl poprawek bezpieczeństwa. Feature Branch działa na tych samych warunkach licencji co zwykły NIM, a wsparcie enterprise wymaga subskrypcji AI Enterprise. Production Branch wymaga aktywnej subskrypcji AI Enterprise, a wsparcie NVIDIA Enterprise Support jest w niej zawarte. Licencja kontenera i licencja modelu to osobne sprawy, co NVIDIA wyjaśnia w FAQ. Cen nie podaje ani FAQ, ani strona produktu — warunki trzeba sprawdzić dla konkretnego obrazu i modelu.
Gdzie działa NIM i czego wymaga?
Wymagania minimalne to procesor AMD64 lub ARM64, wspierana karta NVIDIA, sterownik 580 lub nowszy, NVIDIA Container Toolkit i Docker; NVIDIA zaleca Ubuntu 22.04 LTS lub nowszy. Pamięć GPU zależy od modelu — dla Llama 3.1 8B Instruct NVIDIA podaje co najmniej 24 GB. Stan na 5.10.2026, wydanie 2.0.13.
Ten sam kontener działa na pojedynczym serwerze, w klastrze Kubernetes (Helm, KServe, OpenShift, Run:ai albo NIM Operator) i w chmurach Google Cloud, AWS, Azure i Oracle. Dla środowisk odciętych od sieci NVIDIA opisuje wdrożenie air-gap: wagi przygotowuje się na maszynie z internetem, przenosi i uruchamia bez kluczy do katalogów modeli.
NIM czy vLLM, ONNX Runtime lub zarządzane API?
| Wybór | Najlepszy punkt startu | Główna odpowiedzialność zespołu |
|---|---|---|
| NIM | Chcesz gotowego, walidowanego sposobu serwowania wspieranego modelu na GPU NVIDIA | Sprawdzić profil, licencje, koszt wsparcia i zależność od ekosystemu. |
| vLLM | Potrzebujesz większej kontroli nad otwartym serwerem LLM i własnym cyklem aktualizacji | Samodzielnie utrzymywać konfiguracje, zabezpieczenia i operacje. |
| ONNX Runtime | Masz modele w ONNX i chcesz uruchamiać je na różnym sprzęcie | Przygotować lub wyeksportować model i zoptymalizować jego wykonanie. |
| Zarządzane API | Priorytetem jest szybki start bez obsługi GPU | Zweryfikować lokalizację danych, umowę, koszty wywołań i przenośność. |
NIM i vLLM nie są przeciwieństwami: NIM opakowuje vLLM w kontener z profilami, sondami i poprawkami. Porównanie dotyczy więc poziomu odpowiedzialności operacyjnej, nie samego silnika. Jeśli model ma działać na DGX Spark albo innym urządzeniu, sprawdź zgodność konkretnego obrazu z architekturą sprzętu i pamięcią.
NIM w systemie agentów
NIM obsługuje wywołania narzędzi w formacie OpenAI, więc agent może z niego korzystać razem z serwerami MCP. Dokumentacja opisuje też podłączenie Claude Code przez endpoint zgodny z Anthropic i zaznacza, że NIM nie sprawdza klucza API podanego przez klienta. Agent chętnie skorzysta z każdego endpointu, który odpowiada — dlatego uwierzytelnianie, limity i rejestr wywołań trzeba postawić przed NIM, po stronie firmy.
W stosie agentowym NVIDIA NIM jest warstwą modelu. NeMo służy według NVIDIA do budowy i monitorowania agentów, a NemoClaw może użyć lokalnego NIM: agent w sandboxie wysyła ruch do inference.local, a OpenShell przekazuje go do kontenera. Ta ścieżka ma status eksperymentalny (stan na 5.10.2026). Granice samego agenta opisuję we wpisie o NVIDIA Open Agent Safety Platform.
Jeśli firma nie ma własnego zespołu platformowego, partner wdrożeniowy może przygotować klaster z GPU, testy na docelowym sprzęcie i integrację z agentem. Dane, wybór modelu i zasady dostępu zostają jednak po stronie firmy — to uproszczenie autora, nie podział z dokumentacji NVIDIA.
Jak sprawdzić NIM w AI SDLC?
Zacznij od kontraktu aplikacji: model i wersja, format wejścia, budżet opóźnienia, spodziewana współbieżność, zasady danych. Następnie uruchom wybrany profil na sprzęcie docelowym, nie tylko w środowisku demonstracyjnym. Zmierz czas pierwszej odpowiedzi, przepustowość, wykorzystanie pamięci, zachowanie przy pełnej kolejce i jakość odpowiedzi na reprezentatywnym zbiorze. Osobno sprawdź wyniki po restarcie kontenera i po aktualizacji modelu.
Do monitorowania użyj sond i metryk zgodnych z Prometheusem. Alarm „kontener żyje” nie wystarcza, gdy model nie jest gotowy, dlatego liveness i readiness trzeba traktować oddzielnie. Jeśli aplikacja przetwarza dane wrażliwe, przetestuj, czy ruch sieciowy, logi i pobieranie zasobów odpowiadają założeniom izolacji. Ten pomiar jest ważniejszy niż obietnica, że jeden kontener uruchomi model „w kilka minut”.
- Agenci AI
