Co to jest AI SDLC? Agenci w wytwarzaniu oprogramowania
Temat: AI SDLC
AI SDLC to cykl wytwarzania oprogramowania, w którym część pracy na każdym etapie — od wymagań po utrzymanie — wykonują agenci AI, a człowiek zatwierdza wynik w ustalonych bramkach. Etapy się nie zmieniają. Zmienia się to, kto pisze specyfikację, kod i testy, oraz to, co jest dowodem, że zmiana jest dobra. Agent programistyczny potrafi w kilka minut przygotować zmianę w wielu plikach. Nie potrafi za to odpowiedzieć za jej skutki. Dlatego wdrożenie AI SDLC zaczyna się od pytania „kto i na jakiej podstawie zatwierdza?”, a nie od wyboru narzędzia.
Poradnik jest dla lidera IT, CTO i kierownika zespołu w firmie od 50 osób, który ma już w zespole pierwsze narzędzia AI i chce uporządkować sposób pracy. Ogólne pojęcia — czym agent różni się od asystenta i bota — wyjaśnia poradnik o agentach AI dla firm. Szerszy kontekst daje filar AI SDLC, a na końcu jest mapa wszystkich wpisów o AI SDLC na blogu.
Dwa nurty: AI w produkcie i AI w zespole
Pod hasłem AI SDLC mieszczą się dwie różne rzeczy. Warto je rozdzielić już na pierwszym spotkaniu.
- Budowa produktu, który korzysta z AI. Aplikacja odpowiada klientowi, klasyfikuje zgłoszenia albo działa jako agent. Do zwykłego cyklu dochodzą: wybór modelu, dane, ewaluacje zachowania i obserwacja odpowiedzi po wdrożeniu. Zmiana promptu albo wersji modelu jest tu wydaniem, nawet bez zmiany kodu.
- Używanie agentów AI do pisania oprogramowania. Produkt może nie mieć w sobie żadnej AI. Agent pomaga zespołowi pisać specyfikację, kod, testy i dokumentację.
Oba nurty często spotykają się w jednym repozytorium. Ten poradnik skupia się na drugim, bo to on najszybciej zmienia pracę zespołu. Pierwszego dotyczą sekcje o testach i ewaluacjach.
Siedem etapów i miejsce agenta
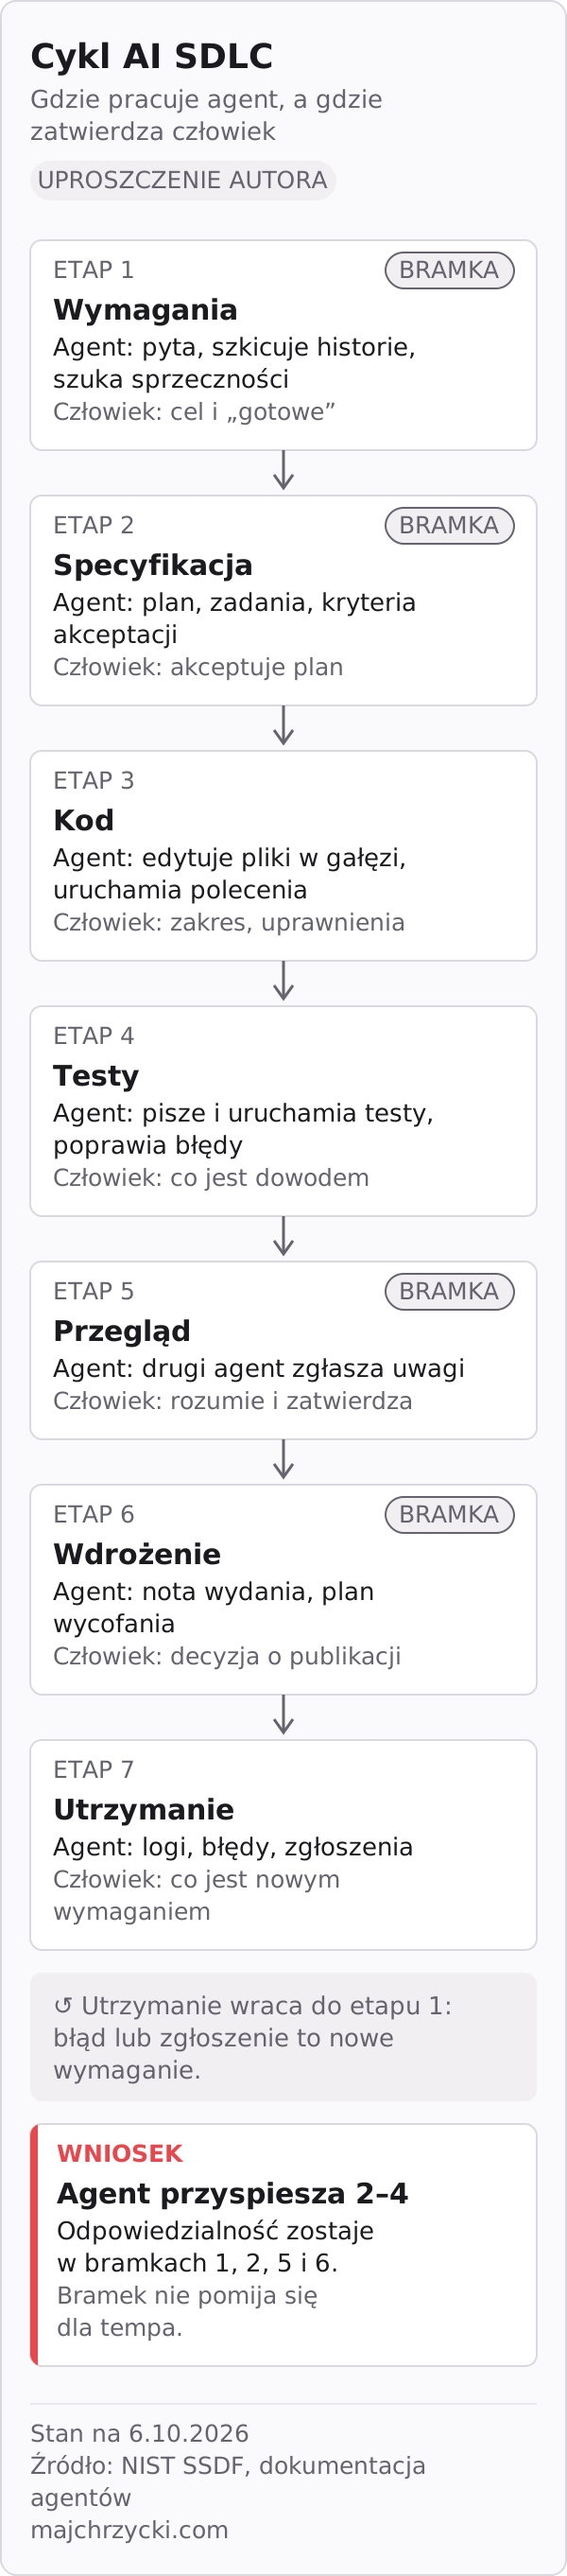
Agent może pomóc na każdym etapie, ale nie na każdym powinien decydować. Poniższy podział jest uproszczeniem autora, zgodnym z logiką NIST SSDF — ramy bezpiecznego wytwarzania oprogramowania, którą NIST w 2024 r. rozszerzył o praktyki dla generatywnej AI.
| Etap | Co robi agent | Co robi człowiek | Bramka |
|---|---|---|---|
| 1. Wymagania | zadaje pytania, szkicuje historie użytkownika, szuka sprzeczności | właściciel ustala cel i warunek „gotowe” | tak |
| 2. Specyfikacja | pisze plan, podział na zadania, kryteria akceptacji | akceptuje plan, zanim powstanie kod | tak |
| 3. Kod | edytuje pliki w osobnej gałęzi, uruchamia polecenia | ustala zakres plików i uprawnienia agenta | — |
| 4. Testy | pisze i uruchamia testy, poprawia błędy | decyduje, które testy są dowodem | — |
| 5. Przegląd | drugi agent może wskazać uwagi | recenzent rozumie i zatwierdza zmianę | tak |
| 6. Wdrożenie | przygotowuje notę wydania i plan wycofania | właściciel wydania decyduje o publikacji | tak |
| 7. Utrzymanie | analizuje logi, błędy i zgłoszenia | decyduje, co staje się nowym wymaganiem | — |
Najwięcej czasu agent oszczędza w etapach 2–4. Najwięcej szkody robi wtedy, gdy ominie bramki 1, 2, 5 i 6. Typowy objaw: piękny pull request do zadania, którego nikt dobrze nie opisał.
Specyfikacja i instrukcje: kontekst, którego agent nie zgadnie
Agent dobrze zna języki programowania. Nie zna za to Waszych konwencji, komend, zakazów ani tego, po co powstaje zmiana. Ten kontekst trzeba zapisać w repozytorium, a nie powtarzać w każdym czacie.
- AGENTS.md — otwarty format „README dla agentów”, którym opiekuje się dziś Agentic AI Foundation w Linux Foundation. Według strony projektu obsługuje go ponad 20 agentów i narzędzi, m.in. Codex, GitHub Copilot, Cursor i Devin. Claude Code czyta własny
CLAUDE.md, a według dokumentacji Anthropic potrafi też odczytaćAGENTS.md. - SKILL.md — powtarzalna procedura dla agenta, na przykład „jak przygotować migrację bazy”. W specyfikacji Agent Skills to katalog z wymaganym plikiem
SKILL.md. - Specyfikacja przed kodem — GitHub Spec Kit prowadzi pracę w fazach: specyfikacja, plan, zadania, implementacja i sprawdzenie zgodności. Podobną drogę od opisu do zadań akcentuje Amazon Kiro.
- Pluginy — paczki instrukcji, narzędzi i agentów, które zespół instaluje i udostępnia. Wygodne, ale to kod z uprawnieniami programisty, więc wymagają tej samej kontroli co zależności.
Praktyczna zasada: jeśli recenzent poprawia ten sam błąd agenta drugi raz, reguła powinna trafić do pliku instrukcji. Jeśli trzeci raz — do testu albo lintera, bo instrukcję agent może przeoczyć, a test nie.
Testy i ewaluacje: odbiór na dowodach
W AI SDLC test przestaje być formalnością. Agent oddaje kod szybciej, niż człowiek zdąży go przeczytać, więc to testy dźwigają główny ciężar odbioru.
Testy kodu pisanego przez agenta. Kryteria akceptacji zapisujcie przed implementacją, najlepiej jako testy, które agent ma przejść. Jeśli agent pisze i kod, i testy, recenzent sprawdza przede wszystkim testy: czy sprawdzają zachowanie, a nie tylko to, że kod się uruchamia.
Ewaluacje samych agentów. Badacze mierzą agentów na zestawach takich jak SWE-bench: 2 294 zadania z prawdziwych zgłoszeń w 12 repozytoriach Python. To dobry punkt odniesienia dla vendorów, ale nie dla Was. Wasz zestaw to kilkanaście zamkniętych zadań z własnego repozytorium, na których porównujecie narzędzia i kolejne wersje instrukcji.
Ewaluacje produktu z AI. Gdy aplikacja korzysta z modelu, potrzebny jest zestaw przypadków i ocena każdej wersji: promptu, modelu, źródeł. Do tego służą narzędzia opisane w mapie wpisów, m.in. LangSmith i MLflow. Warstwę API i aplikacji webowej sprawdza się dodatkowo klasycznymi skanerami, na przykład OWASP ZAP.
Role człowieka w AI SDLC
Agent nie zmniejsza liczby decyzji. Przesuwa je wcześniej, do opisu zadania, i później, do odbioru. W zespole warto nazwać pięć ról, nawet jeśli jedna osoba pełni kilka z nich:
| Rola | Za co odpowiada | Typowy błąd bez tej roli |
|---|---|---|
| Właściciel wymagań | cel, zakres, warunek „gotowe” | agent buduje to, co łatwe, a nie to, co potrzebne |
| Prowadzący agenta | opis zadania, instrukcje, uprawnienia, poprawki | ta sama poprawka w każdym zadaniu |
| Recenzent | zrozumienie zmiany i zatwierdzenie | zatwierdzanie diffu, którego nikt nie przeczytał |
| Właściciel wydania | decyzja o publikacji i plan wycofania | wydanie bez drogi powrotu |
| Bezpieczeństwo | sekrety, zależności, granice danych | kod lub dane klienta w niewłaściwej usłudze |
Najbardziej zmienia się praca inżyniera. Gdy agent pisze kod szybciej, niż zespół potrafi wyjaśnić problem, wartość przesuwa się do rozmowy z biznesem i do odbioru. Tę zmianę opisuje wpis od kodera do FDE.
Ryzyka: bezpieczeństwo, jakość i dług
Bezpieczeństwo. Agent czyta treści z zewnątrz: zgłoszenia, dokumentację, strony, pliki zależności. OWASP opisuje to jako LLM01 Prompt Injection (pierwsze miejsce w wydaniach 2025 i 2026), także w wersji pośredniej, gdy złośliwe polecenie ukryto w pliku lub na stronie. Zalecenia OWASP pasują wprost do agentów programistycznych: minimalne uprawnienia, oddzielenie treści zewnętrznych i zatwierdzenie człowieka przy operacjach wysokiego ryzyka. Agent z dostępem do sekretów produkcyjnych i internetu jednocześnie to zaproszenie do kłopotów.
Zależności. Badanie zaprezentowane na USENIX Security 2025 objęło 16 modeli i 576 tys. próbek kodu. Średnio co najmniej 5,2% pakietów proponowanych przez modele komercyjne i 21,7% przez modele otwarte nie istniało. Agent nie męczy się w piątek o 17:00. Za to z tym samym entuzjazmem doda do projektu bibliotekę, której nikt nigdy nie opublikował — albo, co gorsze, którą ktoś opublikował dopiero wczoraj pod tą samą nazwą. Lista dozwolonych rejestrów i skanowanie zależności w potoku to obowiązek, nie opcja.
Jakość i tempo. Szybszy kod to nie zawsze szybsza praca. W randomizowanym badaniu METR z 2025 r. 16 doświadczonych programistów open source wykonało 246 zadań. Z narzędziami AI z początku 2025 r. pracowali o 19% dłużej, choć spodziewali się przyspieszenia o 24%. To mała próba i starsze narzędzia, ale wniosek jest trwały: mierzcie czas od zadania do wdrożenia, nie wrażenie. Raport DORA 2025, oparty na odpowiedziach prawie 5 000 osób, opisuje AI jako wzmacniacz: wzmacnia mocne strony sprawnych zespołów i problemy słabszych.
Dług. Agent chętnie dopisuje nowy kod obok starego, zamiast go uprościć. Bez reguł w instrukcjach i bez przeglądu pod kątem architektury repozytorium rośnie szybciej niż zrozumienie zespołu. Pomaga zasada: mniejsze zadania, jedna zmiana na pull request i przegląd, który odrzuca kod niepotrzebny do celu.
Software Dark Factory: dokąd to zmierza
Najdalej idący model to „fabryka” oprogramowania, w której agenci budują i poprawiają kod w pętli. StrongDM opisuje taki proces: ludzie definiują intencję, agenci budują, a przegląd kodu zastępuje walidacja na scenariuszach i symulacjach zewnętrznych usług. Zasady tej fabryki sprowadzają się do pętli: materiał wejściowy, uprząż walidacyjna, informacja zwrotna — powtarzane, aż przejdą scenariusze odłożone do sprawdzenia.
To ciekawy kierunek, ale nie punkt startowy. Fabryka działa tylko wtedy, gdy testy i scenariusze są lepsze niż przegląd człowieka. Większość firm najpierw musi dojść do etapu, w którym testom ufa bardziej niż własnej intuicji. Szerzej o tej pętli pisze wpis o Software Dark Factory w mapie poniżej.
Jak wybrać agenta programistycznego: kryteria, nie ranking
Rankingi agentów zmieniają się co kilka miesięcy, kryteria wyboru — rzadko. Przed porównaniem odpowiedzcie na sześć pytań:
- Gdzie może trafić kod i dane? Chmura vendora, chmura firmy czy tylko własny komputer i model lokalny.
- Jak odbieracie pracę? Programista patrzy na każdą zmianę na bieżąco albo agent pracuje sam i oddaje pull request.
- Gdzie działa agent i z jakimi uprawnieniami? Na laptopie programisty, w izolowanym kontenerze, w środowisku chmurowym vendora.
- Jakie instrukcje rozumie? AGENTS.md, skille, pluginy, MCP — im bliżej otwartych formatów, tym łatwiej zmienić narzędzie.
- Jak integruje się z Waszym procesem? Repozytorium, CI, system zgłoszeń, komunikator.
- Kto płaci i za co? Licencja na osobę, zużycie modelu, czas działania w chmurze. Porównujcie koszt na zamknięte zadanie, nie cenę za miejsce.
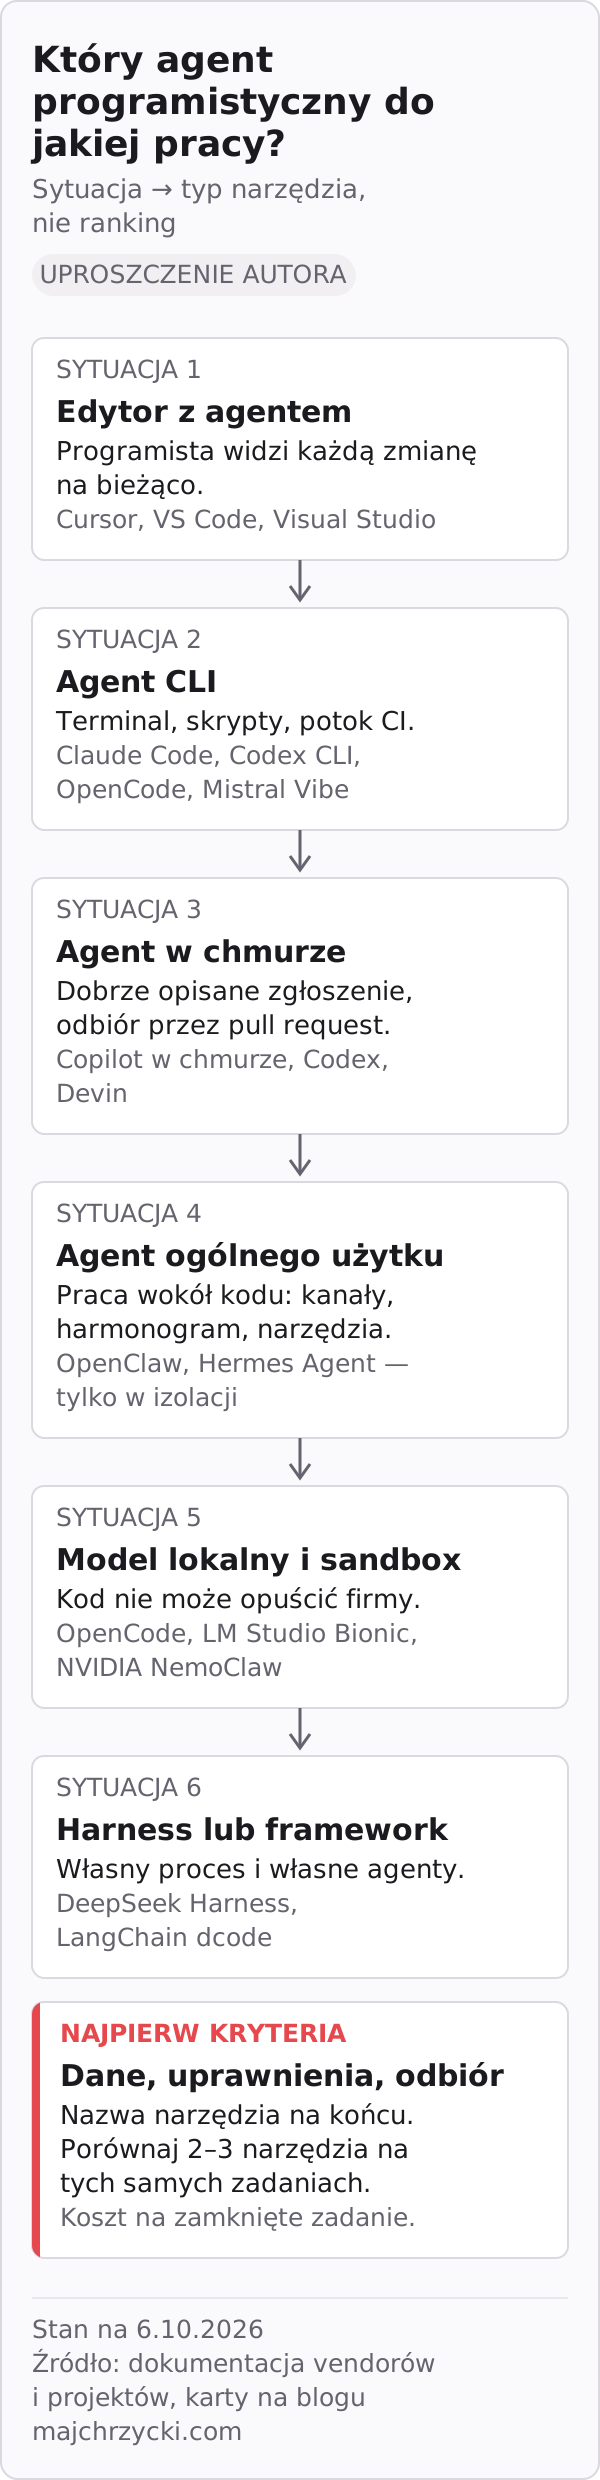
Z odpowiedzi wynika typ narzędzia. Poniższa tabela to przegląd ról, nie ranking; szczegóły i daty są w kartach narzędzi.
| Sytuacja | Typ narzędzia | Przykłady z bloga |
|---|---|---|
| programista chce widzieć każdą zmianę na bieżąco | edytor z agentem | Cursor, Visual Studio Code, Visual Studio |
| praca w terminalu, skrypty, CI | agent CLI | Claude Code, Codex CLI, OpenCode, Mistral Vibe |
| dobrze opisane zgłoszenie, odbiór przez pull request | agent w chmurze | agent GitHub Copilot w chmurze, Codex w chmurze, Devin |
| praca wokół kodu: kanały, harmonogram, narzędzia | agent ogólnego przeznaczenia | OpenClaw, Hermes Agent — tylko w izolacji |
| kod nie może opuścić firmy | otwarty klient z modelem lokalnym, sandbox | OpenCode, LM Studio Bionic, NVIDIA NemoClaw |
| własny proces i własne agenty | harness lub framework | DeepSeek Harness, LangChain dcode |
Dwie uwagi. Według dokumentacji GitHub agent Copilot w chmurze pracuje w jednym repozytorium, na jednej gałęzi i otwiera jeden pull request na zadanie, a jego logi „nie zastępują przeglądu i testów”. Z kolei twórcy OpenClaw zalecają traktować wiadomości przychodzące jako niezaufane, bo narzędzia działają domyślnie na hoście. NemoClaw NVIDIA ma status „early preview” (stan na 6.10.2026) i jest opisany jako stos dla zaufanego operatora na jednym hoście.
Jak zacząć w firmie: pierwszy pilot
Krok 1. Wybierzcie jedno repozytorium i jeden rodzaj zadań. Dobry kandydat ma testy, aktywnego właściciela i powtarzalne zadania: poprawki błędów, testy dla nieprzetestowanego kodu, aktualizacje zależności. Słaby kandydat to „przepiszmy system”.
Krok 2. Spiszcie zasady na jedną stronę. Jakie dane i jaki kod wolno wysłać do usługi vendora. Jakie uprawnienia dostaje agent: odczyt, zapis w gałęzi, uruchamianie poleceń, dostęp do sieci. Kto zatwierdza pull request. Zakazy: sekrety produkcyjne, bezpośredni zapis do gałęzi głównej, wdrożenie bez człowieka.
Krok 3. Dodajcie AGENTS.md i kryteria odbioru. Komendy budowania i testów, konwencje, zakazy. Każde zadanie pilota ma warunek „gotowe” zapisany przed startem.
Krok 4. Porównajcie dwa lub trzy narzędzia na tych samych zadaniach. Kilkanaście zamkniętych zadań z repozytorium. Mierzcie czas od zgłoszenia do zatwierdzonej zmiany, liczbę poprawek po przeglądzie i błędy wykryte później. Nie mierzcie liczby wygenerowanych linii.
Krok 5. Zdecydujcie, co dalej. Rozszerzenie na kolejne repozytorium, zmiana narzędzia albo zatrzymanie. Każda z tych decyzji jest dobrym wynikiem pilota, jeśli opiera się na pomiarze.
Jeśli w kroku 2 nikt nie potrafi powiedzieć, kto zatwierdza zmianę agenta, brakuje nie narzędzia, tylko roli. Inżynier, który umie ustalić z firmą zakres, zasady i odbiór, staje się w AI SDLC najcenniejszą osobą w zespole. Do tej roli przygotowuje kurs Forward Deployed AI Engineer w Akademii.
Mapa wpisów o AI SDLC
Wszystkie wpisy o AI SDLC na blogu w siedmiu grupach. Zacznijcie od grupy, która odpowiada Waszemu pytaniu.
A. Agenci programistyczni vendorów
Karty narzędzi: rola w AI SDLC, granice danych i sposób odbioru.
- Claude Code w AI SDLC: zadania, testy i review
- ChatGPT Codex w AI SDLC: praca od zadania do diffu
- GitHub Copilot w AI SDLC: od sugestii do PR
- Cursor w AI SDLC: edytor z agentem kodującym
- Visual Studio Code: wspólne miejsce dla agentów
- Visual Studio: agent kodujący w projektach .NET
- Google Antigravity: agenci w środowisku pracy
- Amazon Kiro: specyfikacja przed kodem w AI SDLC
- Devin w AI SDLC: kiedy delegować zadanie agentowi w chmurze?
- Grok Bot w AI SDLC: delegowanie zadań kodowych
- IBM Bob w AI SDLC: agent do pracy nad kodem firmy
- Mistral Vibe w suwerennym AI OS
B. Agenci otwarci, lokalni i ich środowiska
Otwarte klienty, harnessy i izolacja — gdy liczy się kontrola nad modelem i danymi.
- Hermes Agent w AI SDLC: pamięć i narzędzia
- OpenClaw w AI SDLC: automatyzacja wokół kodu
- NVIDIA NemoClaw: izolacja agenta w AI SDLC
- OpenCode: agent kodujący z wyborem modelu
- DeepSeek Harness: pluginy w pracy agenta
- Command Code: agent CLI, który uczy się stylu kodowania
- LM Studio Bionic: agent z modelem lokalnym czy chmurowym?
- LangChain dcode w suwerennym AI OS
C. Specyfikacje i instrukcje dla agentów
Jak zapisać kontekst, procedury i rozszerzenia, żeby agent nie zgadywał.
- AGENTS.md: stałe instrukcje dla agentów kodujących
- SKILLS.md czy SKILL.md? Umiejętności agentów AI
- Pluginy agentów AI: Claude, ChatGPT, Codex i Copilot
- GitHub Spec Kit: specyfikacja przed kodowaniem z AI
- Excalidraw: szkic architektury AI, który uruchamia rozmowę
D. Testy, ewaluacje i bezpieczeństwo
Odbiór na dowodach: ślady, zestawy przypadków i testy bezpieczeństwa.
- LangSmith: jak oceniać i śledzić aplikacje AI
- MLflow w suwerennym AI OS
- Prompt flow: testowanie przepływu aplikacji AI
- OWASP w AI SDLC: bezpieczeństwo od zadania do wdrożenia
- OWASP ZAP w AI SDLC: testy API agentów i aplikacji
E. Budowa aplikacji: języki, frameworki i narzędzia
Technologie, w których powstają aplikacje i usługi AI.
- Python w aplikacjach AI: architektura i test
- Python w AI SDLC
- .NET w AI SDLC
- .NET 10 dla aplikacji AI: warstwy i wybór
- Aspire: AppHost, service discovery i dashboard
- Blazor w .NET 10: renderowanie, stan i AI
- Microsoft Orleans 10: kiedy wybrać virtual actors
- Angular w AI SDLC
- Go w AI SDLC
- Rust w AI SDLC
- PHP w AI SDLC
- Jupyter Notebook w suwerennym AI OS
- Docker w suwerennym AI OS
- Nx w AI SDLC: graf projektów i zakres zmian
F. Interfejsy i design systems aplikacji AI
Jak pokazać użytkownikowi źródło, niepewność i moment decyzji.
- Design system dla aplikacji AI: jak wybrać
- Material Design w aplikacji AI: kryteria wyboru
- Fluent Design w aplikacji AI: czytelność i kontrola
- IBM Carbon w aplikacji AI: projekt i odbiór
G. Organizacja pracy i przyszłość zespołu
Co agenci zmieniają w pracy inżyniera i w całym procesie.
- AI SDLC
- Agenci AI
- Bezpieczeństwo
- Procesy